Index Table
Проблема
В многих хранилищах данные для коллекций сущностей организованы при помощи первичного ключа. Этот ключ может использоваться в приложении для поиска и извлечения данных. На рисунке представлен пример хранилища данных со сведениями о клиентах. Первичный ключ — это идентификатор клиента. На рисунке представлены сведения о клиенте, упорядоченные по первичному ключу (идентификатору клиента).
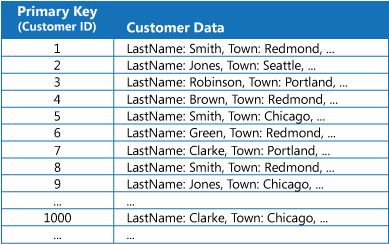
Первичный ключ отлично подходит для запросов данных на основе его значения. Но если нужно получить данные на основе другого поля, первичный ключ не всегда можно использовать. В приведенном выше примере для поиска клиентов в приложении нельзя использовать первичный ключ (идентификатор клиента), если данные запрашиваются исключительно по ссылке на значение какого-нибудь другого атрибута, например на название города, в котором находится клиент. Для выполнения такого запроса приложению может потребоваться получить и изучить каждую запись клиента, что может занять довольно много времени.
Многие системы управления реляционными базами данных поддерживают вторичные индексы. Вторичный индекс — это отдельная структура данных, упорядоченных по одному или нескольким вторичным (дополнительным) ключевым полям. Такой индекс указывает, где хранятся данные для каждого индексированного значения. Элементы вторичного индекса обычно сортируются по значению вторичных ключей, чтобы повысить скорость поиска данных. Такие индексы, как правило, автоматически обслуживаются системой управления базами данных.
Вы можете создать любое количество вторичных индексов для поддержки различных запросов, выполняемых в приложении. Например, в таблице со сведениями о клиентах в реляционной базе данных, где идентификатор клиента является первичным ключом, стоит добавить вторичный индекс над полем города, если в приложении часто выполняется поиск клиентов по городу, в котором они находятся.
Однако, хотя вторичные индексы распространены в реляционных системах, некоторые хранилища данных NoSQL, используемые облачными приложениями, не предоставляют эквивалентную функцию.
Решение
Если хранилище данных не поддерживает вторичные индексы, их можно эмулировать вручную, создав собственные таблицы индексов. В таблице индексов данные упорядочиваются по указанному ключу. Для структурирования таблицы индексов обычно используются три стратегии. Стратегию выбирают на основе требуемого числа вторичных индексов и характера запросов в приложении.
Первая стратегия — данные дублируются в каждой таблице индексов, но упорядочиваются по разным ключам (полная денормализация). На следующем рисунке представлены таблицы индексов, в которых одни и те же данные клиента упорядочены по городу и фамилии:
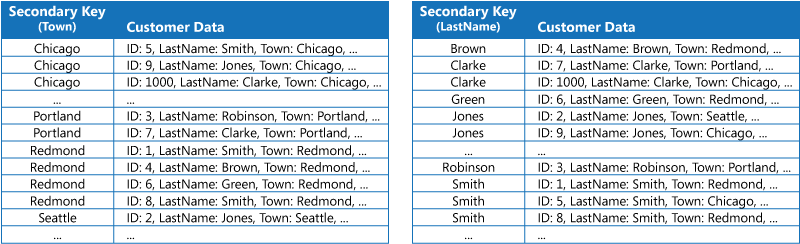
Эта стратегия подходит, если данные остаются относительно статическими при любом количестве запросов с помощью каждого ключа. Если данные более динамические, затраты на обслуживание каждой таблицы индексов слишком значительны и такой подход нецелесообразен. Кроме того, если объем данных очень велик, требуется значительное пространство для хранения дублируемых данных.
Вторая стратегия — создаются нормализованные таблицы индексов, которые упорядочены по разным ключам, и добавляются ссылки на исходные данные с помощью первичного ключа (вместо их дублирования), как показано на приведенном ниже рисунке. Исходные данные называются таблицей фактов.
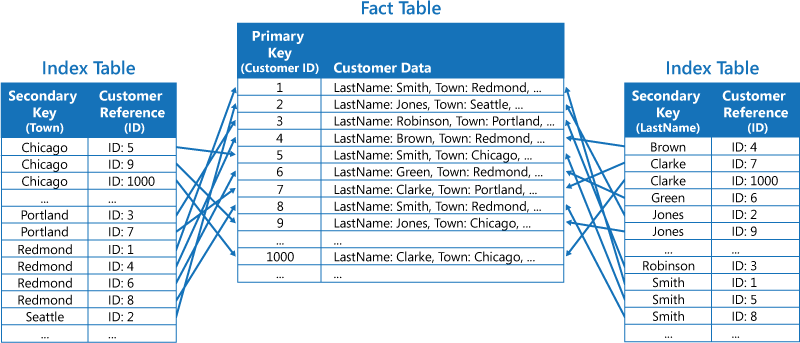
Этот способ позволяет сэкономить место и сократить затраты на обслуживание дублируемых данных. Недостатком такого подхода является то, что приложению требуется выполнять две операции поиска данных с использованием вторичного ключа. Сначала нужно найти первичный ключ для данных в таблице индексов, а затем использовать его для поиска данных в таблице фактов.
Третья стратегия — создаются частично нормализованные таблицы индексов, упорядоченные при помощи различных ключей. В таких таблицах дублируются часто извлекаемые поля. Для доступа к редко используемым полям добавляются ссылки на таблицу фактов. На следующем рисунке показано, как часто используемые данные дублируются в каждой таблице индексов:
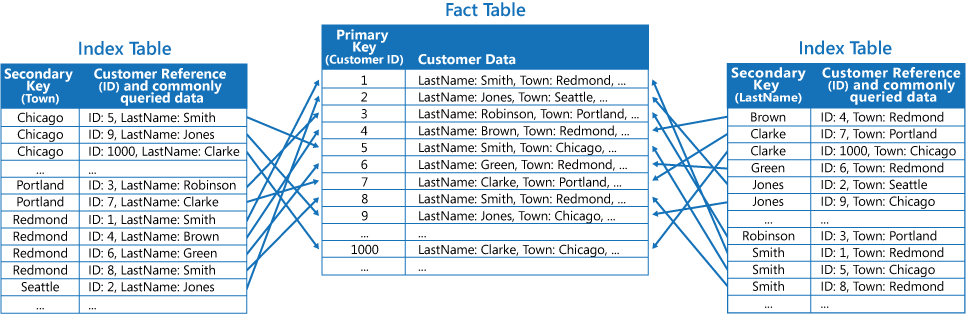
Эта стратегия обеспечивает баланс между двумя первыми подходами. Данные для часто выполняемых запросов можно быстро получить при помощи одной операции поиска, а занимаемое пространство и затраты на обслуживание не так значительны, как при дублировании всего набора данных.
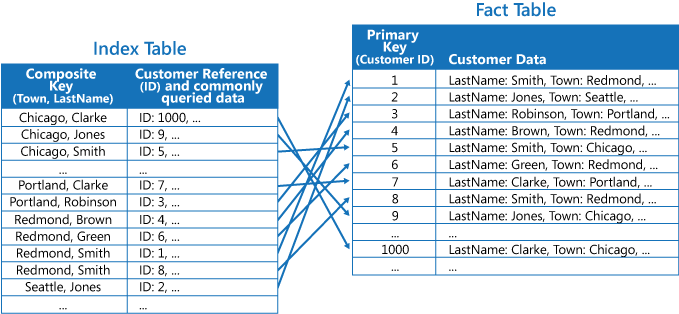
Если приложение часто запрашивает данные, указывая сочетание значений (например, "Найти всех клиентов, живущих в Redmond и имеющих фамилию Smith"), можно реализовать ключи к элементам в таблице индексов в виде объединения атрибута "Город" и атрибута LastName. На приведенном ниже рисунке представлена таблица индексов на основе составных ключей. Ключи сортируются по городу, а затем — по фамилиям для записей с одинаковыми значениями города.
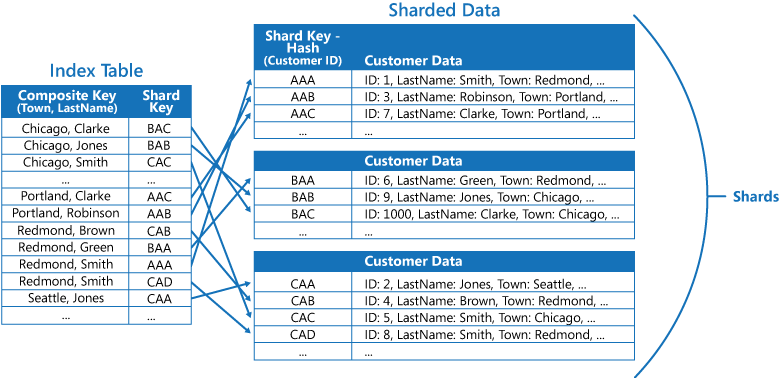
Таблицы индексов могут ускорить операции запросов для сегментированных данных и особенно полезны, когда ключ сегмента хэшируется. На приведенном ниже рисунке показан пример, где ключ сегмента является хэшем идентификатора клиента. В таблице индексов можно упорядочить данные по нехэшированному значению (город и фамилия) и указать хэшированный ключ как данные поиска. Это поможет предотвратить многократное вычисление хэш-ключей (ресурсоемкую операцию) в приложении, если требуется получить данные в пределах диапазона или в порядке нехэшированных ключей. Например, запрос, например "Найти всех клиентов, живущих в Redmond", можно быстро устранить, найдя соответствующие элементы в таблице индекса, где все они хранятся в непрерывном блоке. Затем используйте ссылки на данные клиента с помощью ключей сегментов, которые хранятся в таблице индексов.