Service per team
Проблема
Какая связь между командами и сервисами?
Решение
Каждый сервис принадлежит команде, которая несет единоличную ответственность за внесение изменений. В идеале у каждой команды есть только один сервис.
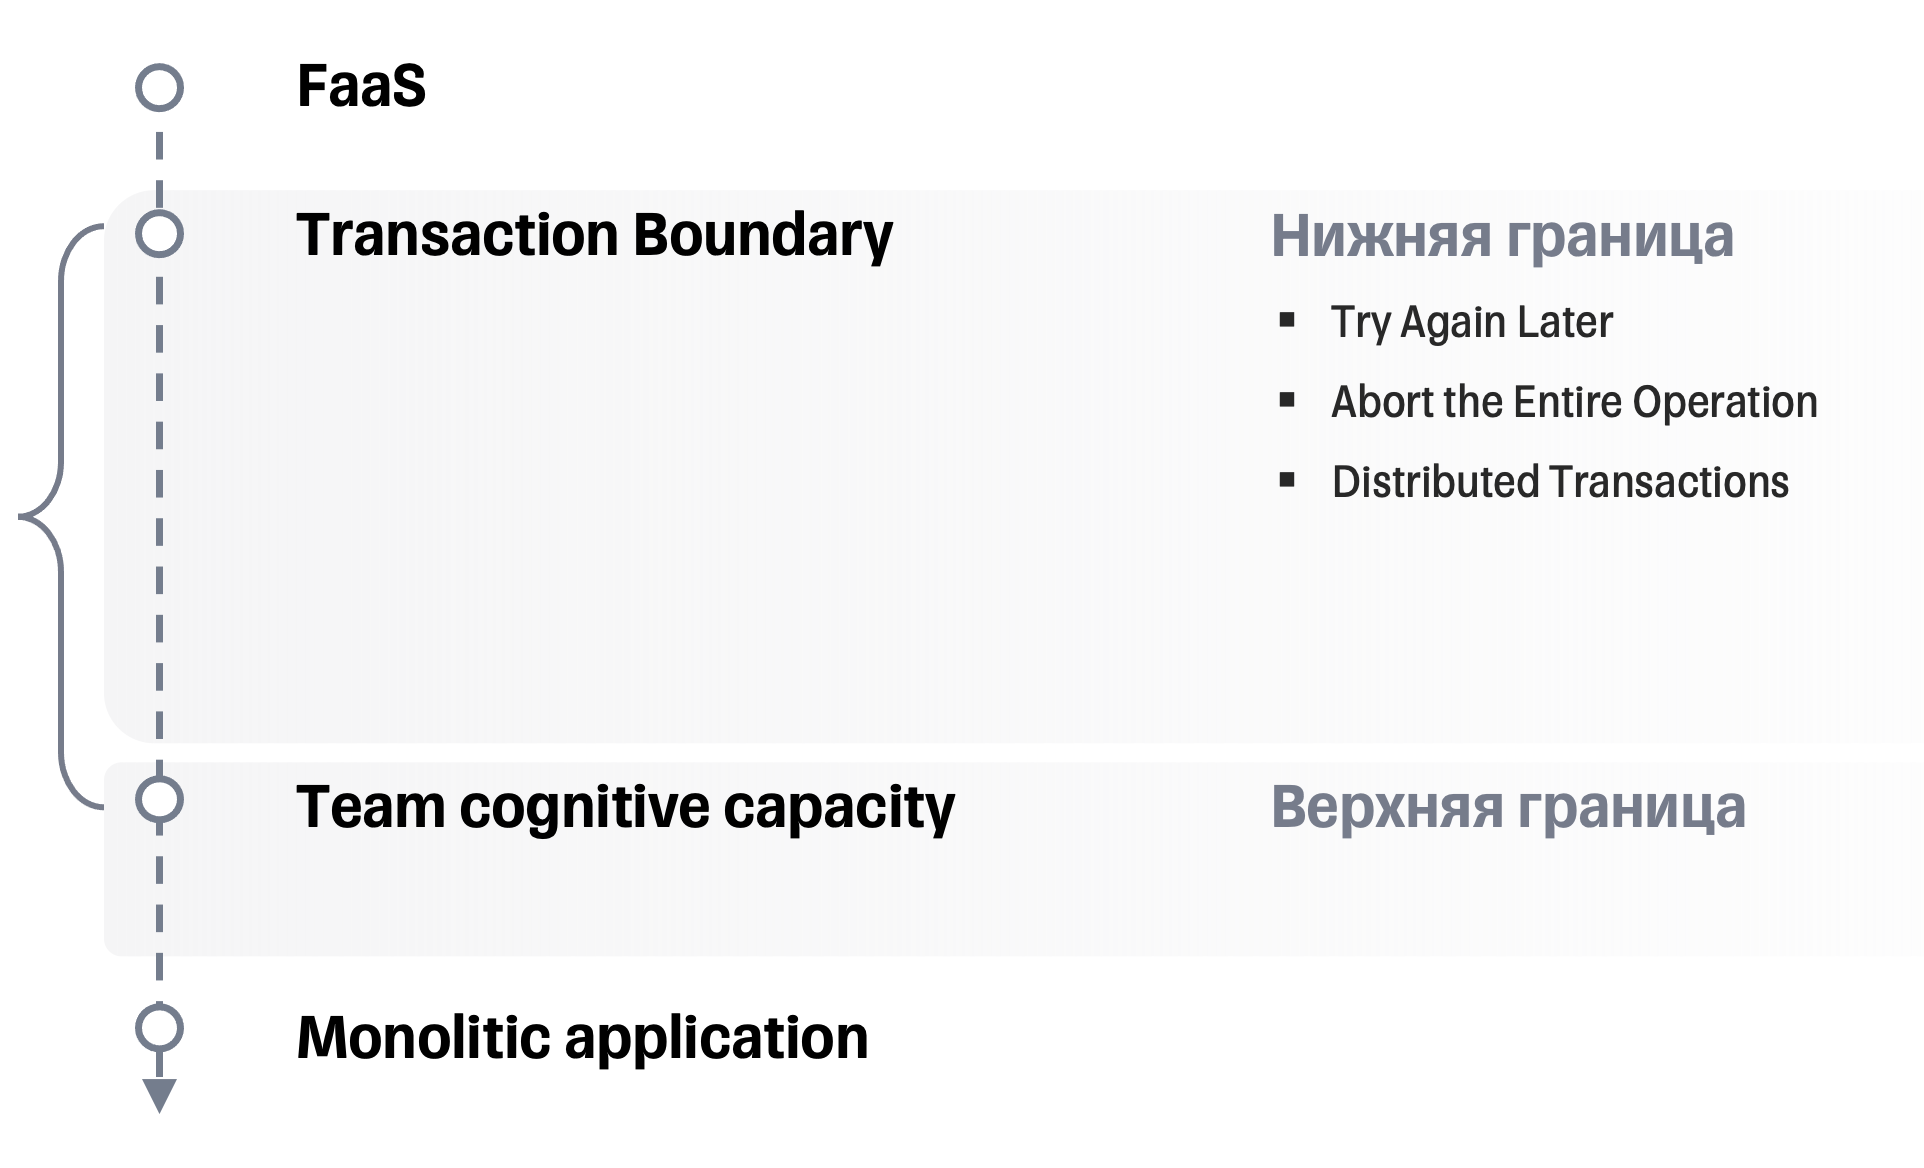
Для наглядности отрисуем ось на которой отметим FaaS как минимальную границу сервиса и монолитное приложение как максимальную границу.
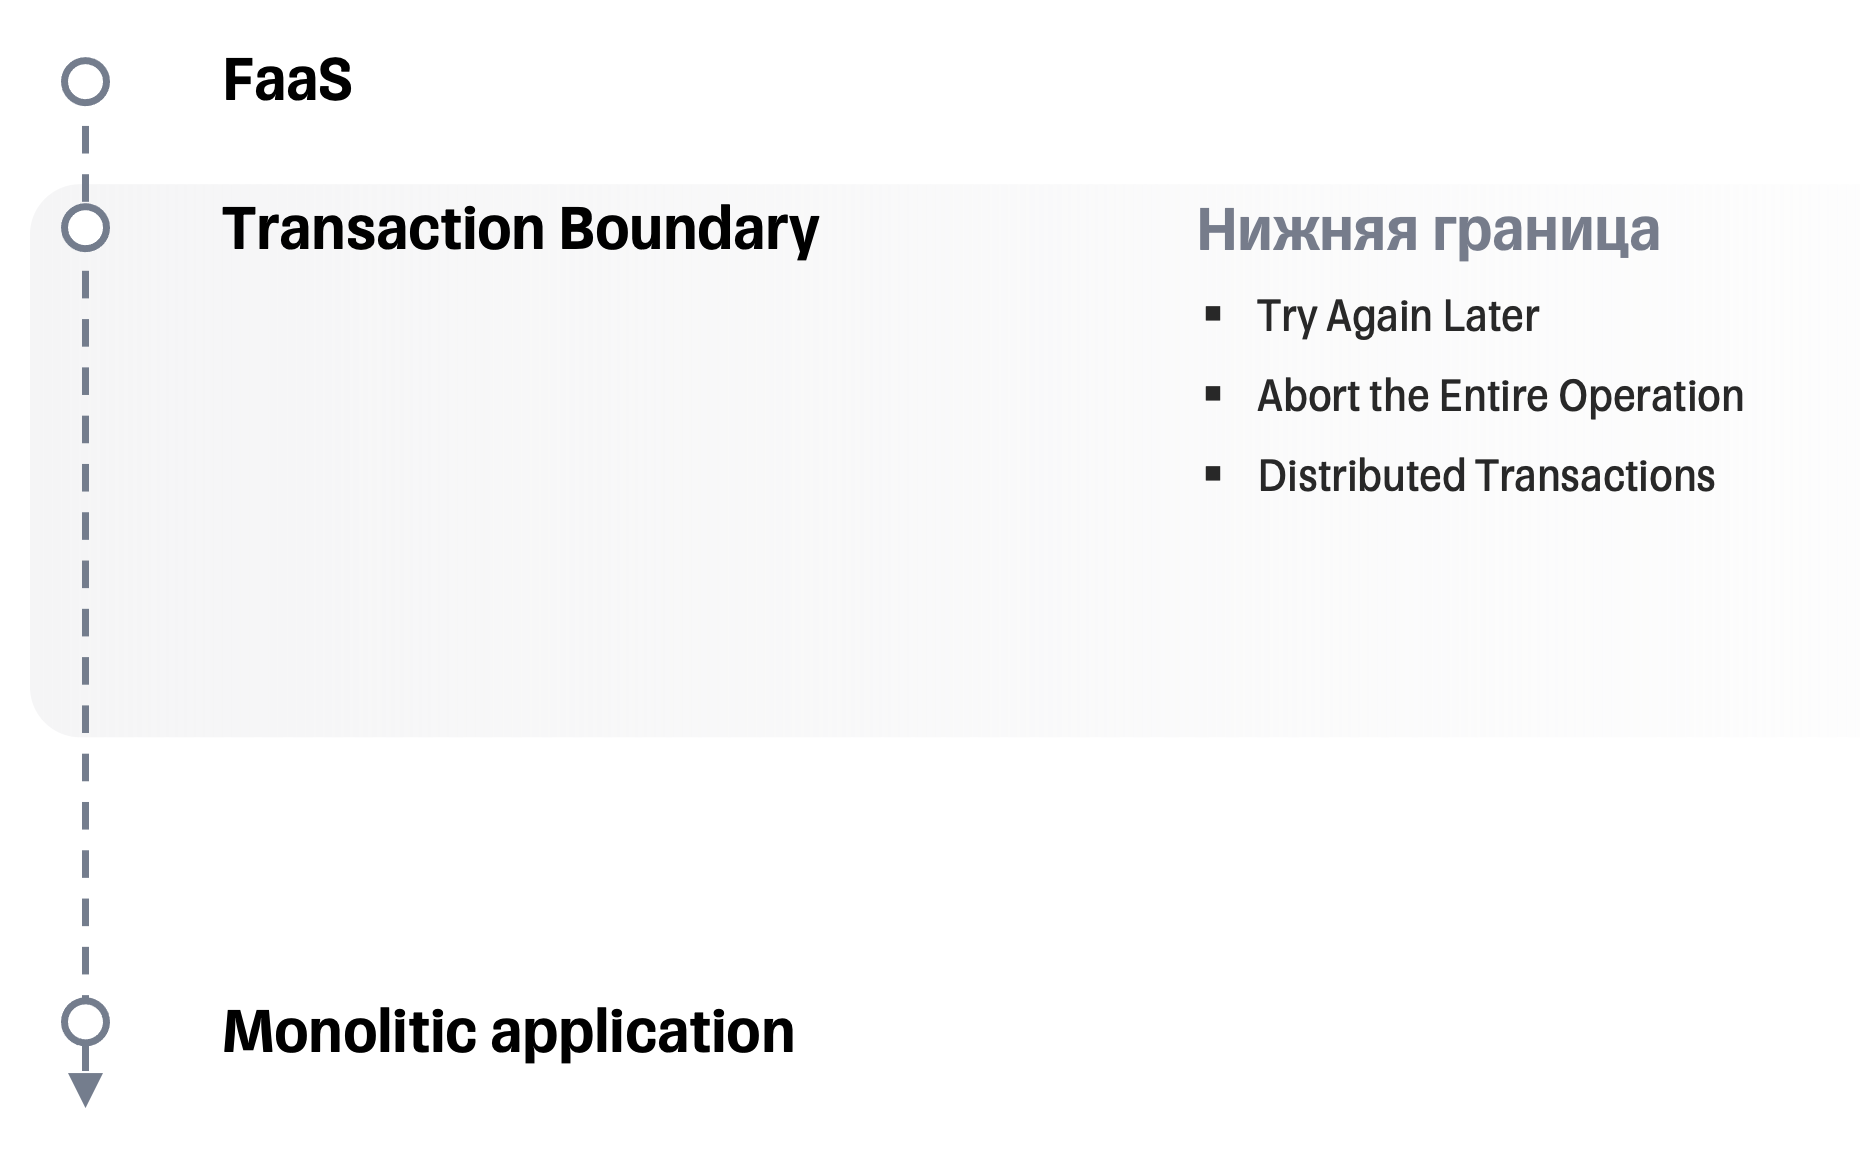
Теперь на оси отметим минимальную границы микросервиса. Хорошей отправной точкой для этого становятся границы транзакционности.
Следует помнить, что транзакционная граница не единственный драйвер интеграции. Следующим на, что я смотрю это рабочий процесс. Разнесение рабочего процесса по разным сервисам может привести к частым сквозным доработкам.
На всякий случай поясню, что понимается под рабочим процессом. Рабочим процессом можно считать конечную пользовательскую услугу. Декомпозиция этой услуги приведет к частым зависимым изменениям.
Sum Newman в книги Build Microcervices говорит о рисках распила transaction boundary по сервисам. Как только граница транзакционности находится за пределами одной системы, гарантировать согласованность данных становится практически невозможно. В своей книге он описывает 3 возможных механизма достижения согласованности: Try Again Later, Abort the Entire Operation, Distributed Transactions, и не один из них не совершенен.
- Try Again Later - говорит о том, что целевая система обновляет операцию атомарно, а остальные постепенно во времени. Этот механизм не имеет механизма компенсации в случае ошибки на стороне вторичных систем.
- Abort the Entire Operation - механизм Saga. Механизм предполагает консистенцию во времени как и первый вариант, но в добавок имеет механизмы компенсации в случае неуспеха вторичных систем. Один из самых сложных вариантов в котором нужно предусматреть множество негативных сценариев. Что произойдет, если наша компенсирующая транзакция не удастся?
- Distributed Transactions - Альтернативой ручной организации компенсирующих транзакций является использование распределенной транзакции. Распределенные транзакции пытаются охватить внутри себя несколько транзакций, используя некий общий управляющий процесс, называемый менеджером транзакций, для координации различных транзакций, выполняемых базовыми системами. Наиболее распространенный алгоритм, используемый для обработки распределенных транзакций заключается в использовании двухфазной фиксации. При двухэтапном коммите сначала идет этап голосования. Именно здесь каждый участник (также называемый в данном контексте когортой) в распределенной транзакции сообщает менеджеру транзакций, считает ли он, что его локальная транзакция может быть продолжена. Если менеджер транзакций получает голос «да» от всех участников, он говорит им всем, чтобы они продолжали выполнять свои коммиты. Одного голоса «против» достаточно, чтобы менеджер транзакций разослал откат всем сторонам. Этот подход основан на том, что все стороны останавливаются до тех пор, пока центральный координирующий процесс не сообщит им о продолжении. Это означает, что мы уязвимы для сбоев. Если диспетчер транзакций выходит из строя, ожидающие транзакции никогда не завершаются. Если когорта не отвечает во время голосования, все блокируется. Также есть случай, что произойдет, если последующее голосование за коммит не удастся. В этом алгоритме неявно подразумевается, что этого не может произойти: если когорта говорит «да» во время периода голосования, мы должны предположить, что она зафиксирует. Когорты должны иметь способ заставить эту фиксацию работать в какой-то момент. Это означает, что этот алгоритм не является надежным, он просто пытается отловить большинство случаев отказа. Этот процесс согласования также означает блокировки; то есть незавершенные транзакции могут блокировать ресурсы. Блокировка ресурсов может привести к конфликтам, что значительно усложнит масштабирование систем, особенно в контексте распределенных систем.
Все описанные механики чрезвычайно сложны. Задайте себе вопрос. Может ли ваша транзакция быть согласованна по времени. Если нет, подумайте над размещением функциональности в одном едином сервисе.
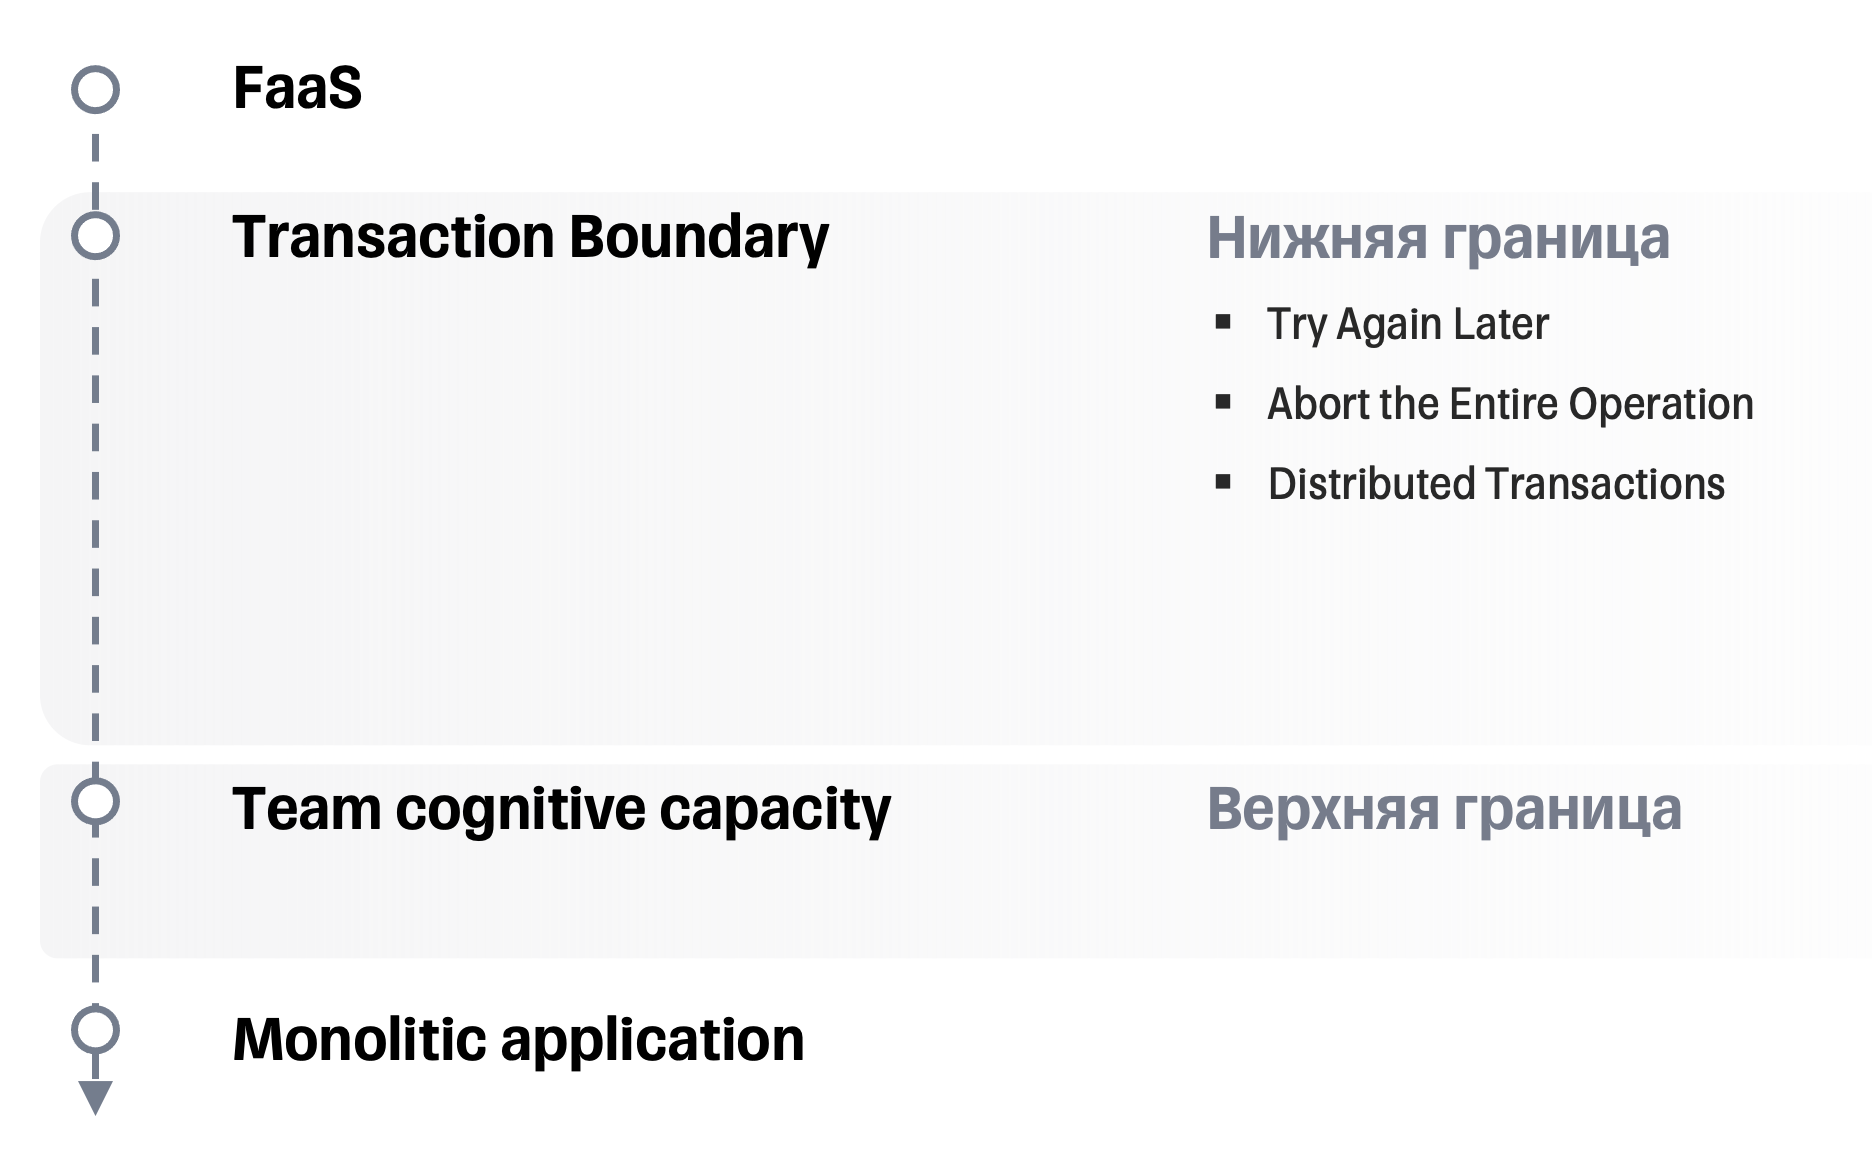
Отлично, мы знаем минимальные границы нарушение которых станет болью при разработки. Давайте определим максимальные границы.
Максимальной границей можно считать когнитивные способности команды. Все, что больше невозможно держать в голове и разработка затрудняется. При доработках приходится много информации поднимать в память заново. Time to market от того существенно страдает. Вторая проблема нарушения этой границы это протухание кода. Разработчики не способны держать такой код в чистоте. Появляется много мертвого функционала который просто страшно выпиливать. Абстракции просачиваются друг в друга и код очень быстро превращается в спагетти.
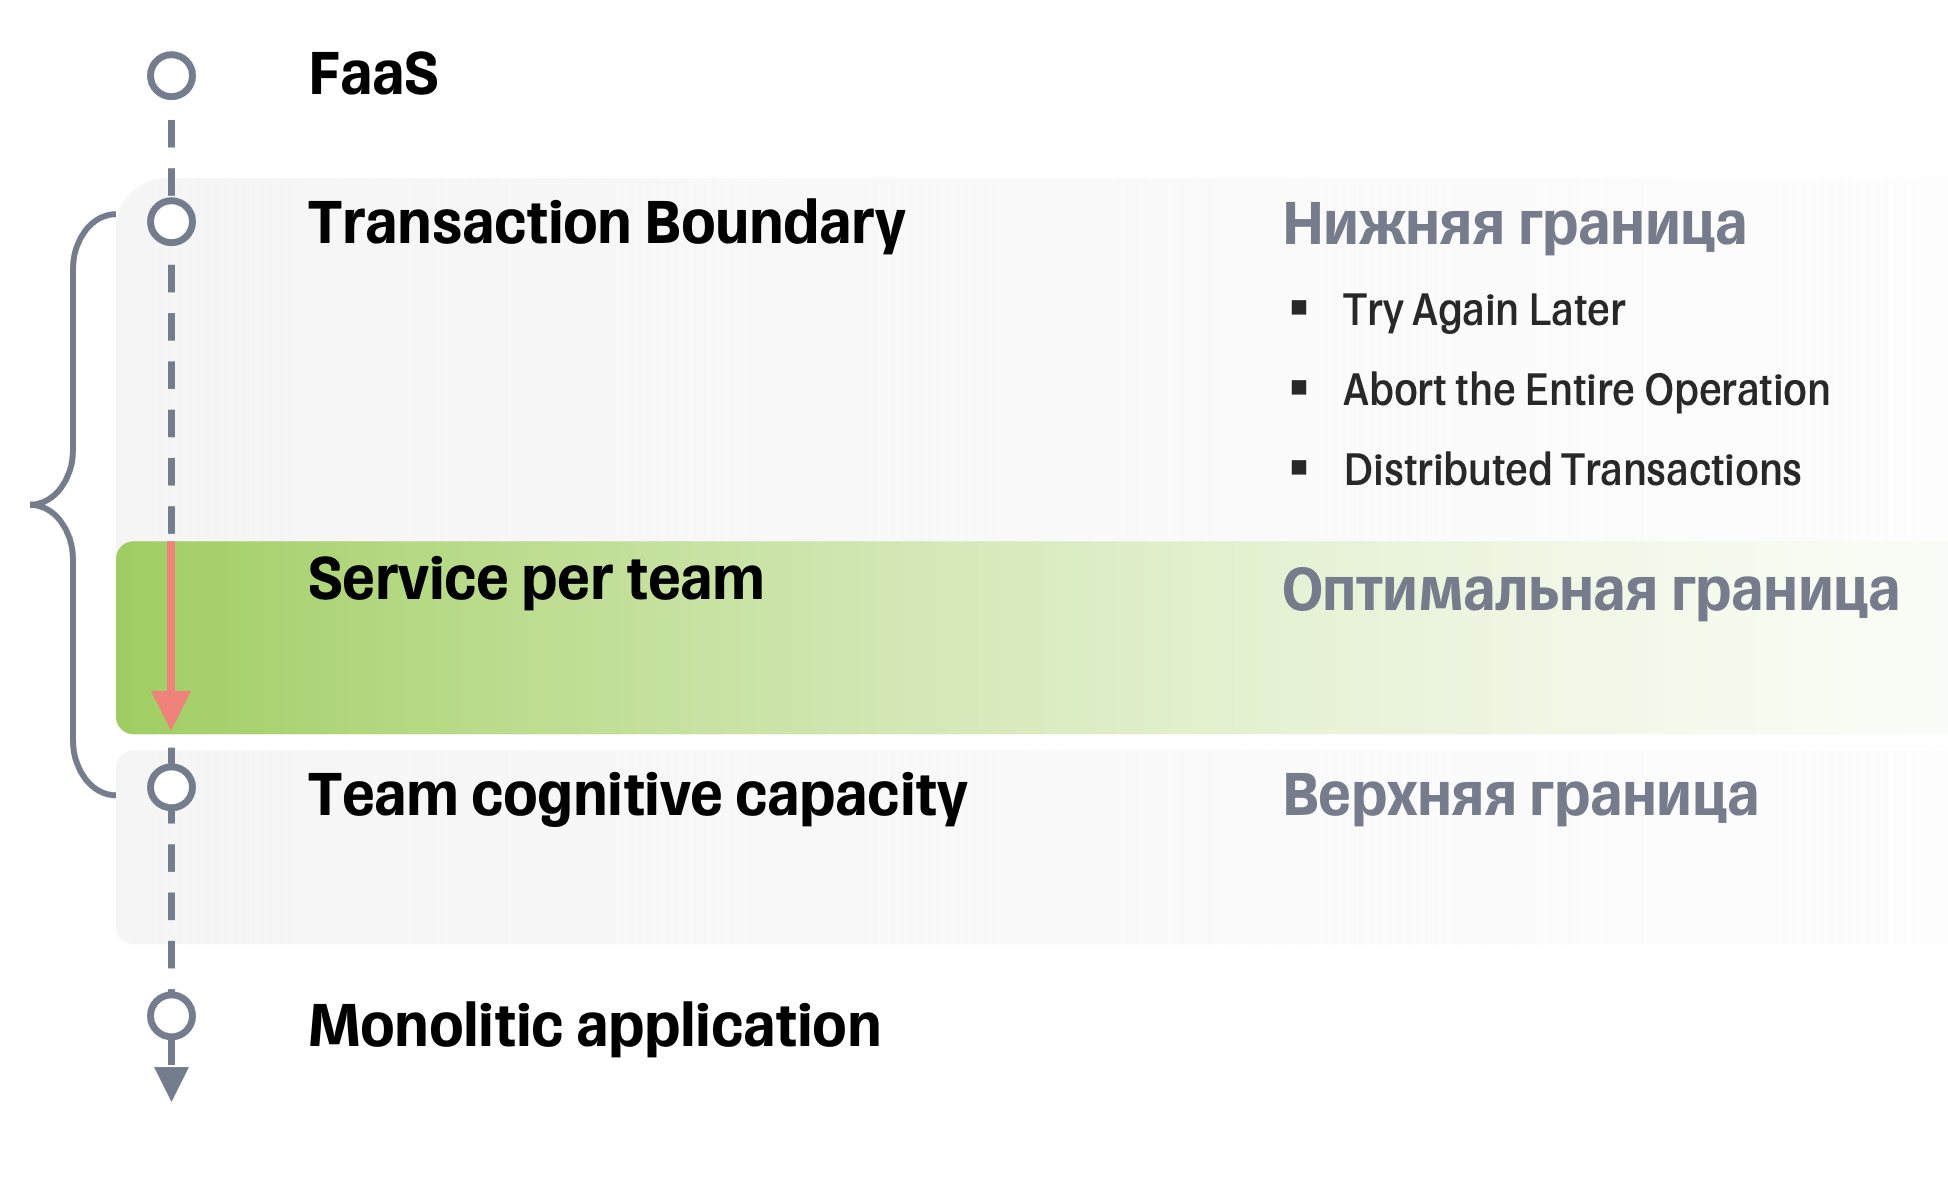
Отлично! Мы нашли область с которой можно начинать работать. Но каким же будет оптимальный/идеальный размер сервиса.
И здесь мы приходим к относительно новой парадигме Service per team.
В идеале команда должна владеть только одним сервисом, поскольку этого достаточно для обеспечения автономности команды и слабой связанности, а каждый дополнительный сервис добавляет сложности и накладных расходов. Команде следует развертывать свой код как несколько сервисов только в том случае, если он решает осязаемую проблему. Поскольку команда должна быть небольшой, ее когнитивные способности ограничены. Чтобы команда была продуктивной, ее кодовая база не должна превышать когнитивные способности команды. Другими словами, он должен «умещаться» в головах команды.
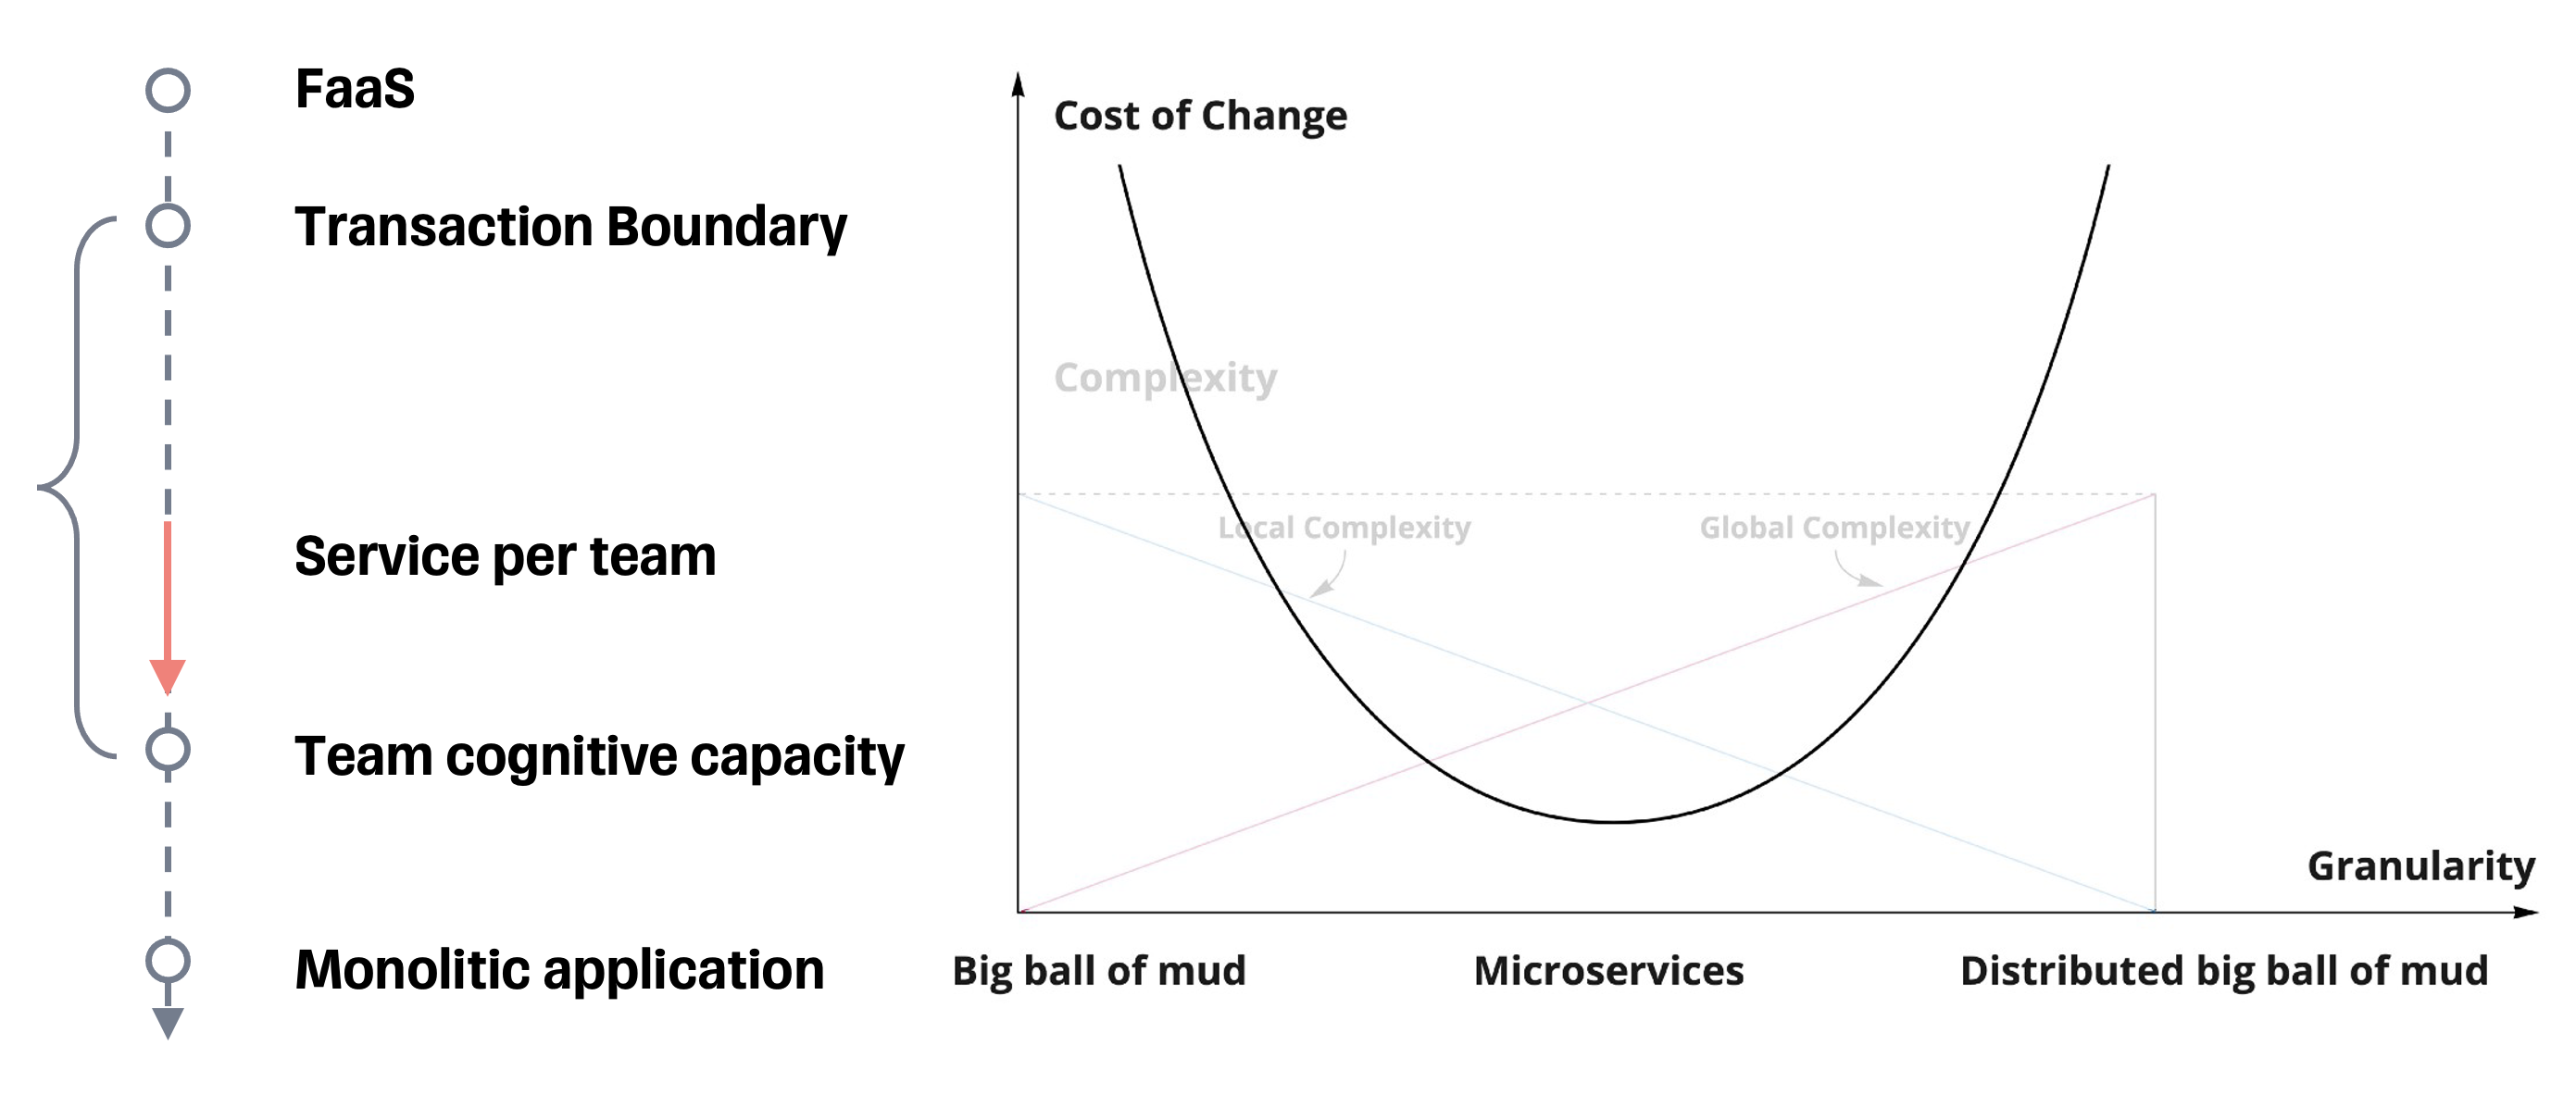
Добавлю веса к своим словам графиком стоимости изменений от гранулярности.
Первая крайность. Команда работающие над приложением, объем кодовой базы которого не укладывается в границы когнитивной способности команды, вносит изменения дольше.
Мне это напоминает подключение свопа при нехватки оперативной памяти. Постоянно в памяти такие системы не помещаются и каждый раз при появлении доработок приходится поднимать новую порцию кодовой базы и опускать другую из памяти. Знания постоянно находятся в состоянии вымывания. Процесс поднятия в память достаточно долгий. Соответственно time to market ухудшается.
Вторая крайность. Излишняя гранулярность. Нарушение границ transaction boundary приводит к излишней сложности.
Даже если вы бьете по границам транзакционности правильно, все равно остается риск излишней гранулярности. Допустим вы владеете продуктом и решаете его разбить на 4 микросервиса в пределах одной команды. Какие плюсы вы от этого получаете? Масштабируемость? Может быть, но только если вы понимаете, что вы делаете. Мелкие гранулы это физические границы, которые очень дорого нарушать. Некорректно выбранные границы превратят ваши микросервисы в distributed big ball of mud (вы нарушите одно из свойств микросервисов, а именно Loose Coupling)
Вывод
Держитесь в оптимальных границах.