Event-Driven Architecture
Описание
Стиль архитектуры, управляемой событиями, - это популярный стиль распределенной асинхронной архитектуры, используемый для создания высокомасштабируемых и высокопроизводительных приложений. Стиль хорошо подходит как для малых, так и для больших приложений. Архитектура, управляемая событиями, состоит из сильно развязанных компонентов обработки событий, которые асинхронно принимают и обрабатывают события. Его можно использовать как автономный стиль архитектуры или встраивать в другие стили архитектуры (например, архитектуру микросервисов, управляемую событиями).
Управляемая событиями архитектура включает поставщики событий (event producers), которые создают потоки событий, и потребители событий(event consumers), которые прослушивают эти события.
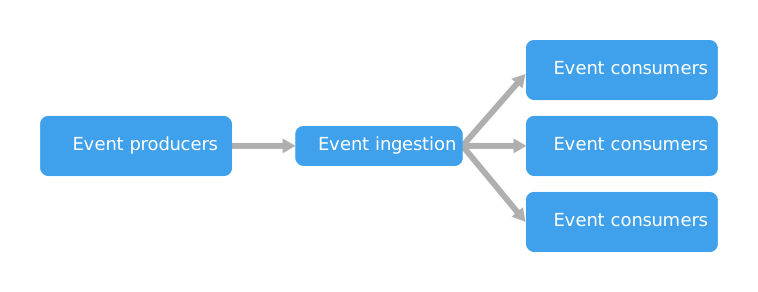
События доставляются практически мгновенно, что позволяет потребителям немедленно реагировать на происходящие события. Производители отделены от потребителей - производитель даже может не знать, какие потребители его слушают.
Архитектура на основе событий может использовать модель публикации и подписки (также называемая pub/sub) или моделью потока событий (Event streaming).
Pub/sub. Инфраструктура обмена сообщениями поддерживает список подписок. Каждое публикуемое событие отправляется каждому подписчику. После получения события его нельзя воспроизвести, а новые подписчики не видят старые события.
Event streaming. Все события записываются в журнал. События в пределах каждой секции строго упорядочены и сохраняются в течение долгого времени. Клиенты не подписываются на поток, а просто считывают события из любой его части. Каждый клиент самостоятельно управляет своим положением в потоке. Это означает, что клиент может подключиться в любое время и (или) прослушать события повторно.
На стороне получателя есть несколько распространенных вариантов реализации.
Обработка простых событий. Каждое событие немедленно запускает действие на стороне потребителя.
Базовая корреляция событий. Потребителю необходимо обработать небольшое количество дискретных бизнес-событий, обычно связанных с каким-либо идентификатором, сохраняя некоторую информацию из более ранних событий для использования при обработке более поздних событий.
Сложная обработка событий. Потребитель обрабатывает серию событий, ища закономерности в данных событий. Например, вы можете агрегировать показания некоторого устройства за определенный временной интервал и генерировать уведомление, если скользящее среднее пересекает определенный порог.
Обработка потока событий (Event Stream Processing). Это набор технологий, упрощающий разработку архитектуры на основе данных. Event Stream Processing состоит из двух отдельных технологий. Первая технология — это система логического хранения событий, вторая — ПО для обработки этих событий.
Источник событий может находиться за пределами системы, например это могут быть физические устройства в решении Интернета вещей. В такой ситуации система должна поддерживать прием данных в таких объемах и на такой скорости, которые соответствуют характеристикам источника данных.
На представленной выше логической схеме каждый тип потребителя обозначен отдельным блоком. На практике обычно используется несколько экземпляров каждого поставщика, чтобы они не становились единой точкой отказа. Наличие нескольких экземпляров также может требоваться для обработки событий в нужных объемах и (или) с нужной скоростью. Кроме того, каждый объект-получатель может обрабатывать события в нескольких потоках.
Уникальные возможности
Отзывчивость
Стиль архитектуры, управляемой событиями, предлагает уникальную характеристику по сравнению с другими стилями архитектуры - он опирается исключительно на асинхронную связь как для обработки fire and forget (ответ не требуется), так и для обработки request/replay (ответ требуется от потребителя события). Асинхронная связь может быть мощным методом повышения общей отзывчивости системы.
Рассмотрим пример публикации комментариев, используем синхронный и асинхронный подходы.
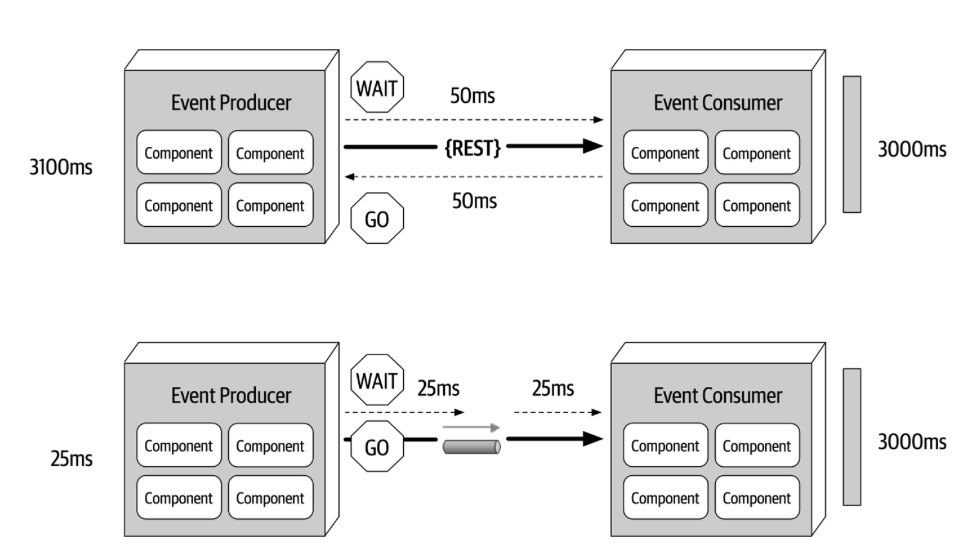
При синхронном взаимодействии пользователь вынужден ждать 3100 миллисекунд.
При асинхронном взаимодействии пользователь получит ответ за 25 миллисекунд. Разрыв в 3075 миллисекунд ошеломительный, но нужно понимать, что это только отзывчивость и у всего есть последствия.
Конечная производительность не изменилась. Потребитель как обрабатывал комментарий за 3000 миллисекунд так и обрабатывает. К тому же появится новая проблема - пользователь не увидит успешно ли опубликован комментарий или нет. Что будет, если потребитель по каким-то причинам отклонит публикацию? Например, из-за нецензурной лексики в комментарии или из-за контента рекламного характера или ещё из-за миллиона разных причин. Обработка ошибок в событийной архитектуре - это новый челенж для архитектора.
Broadcast
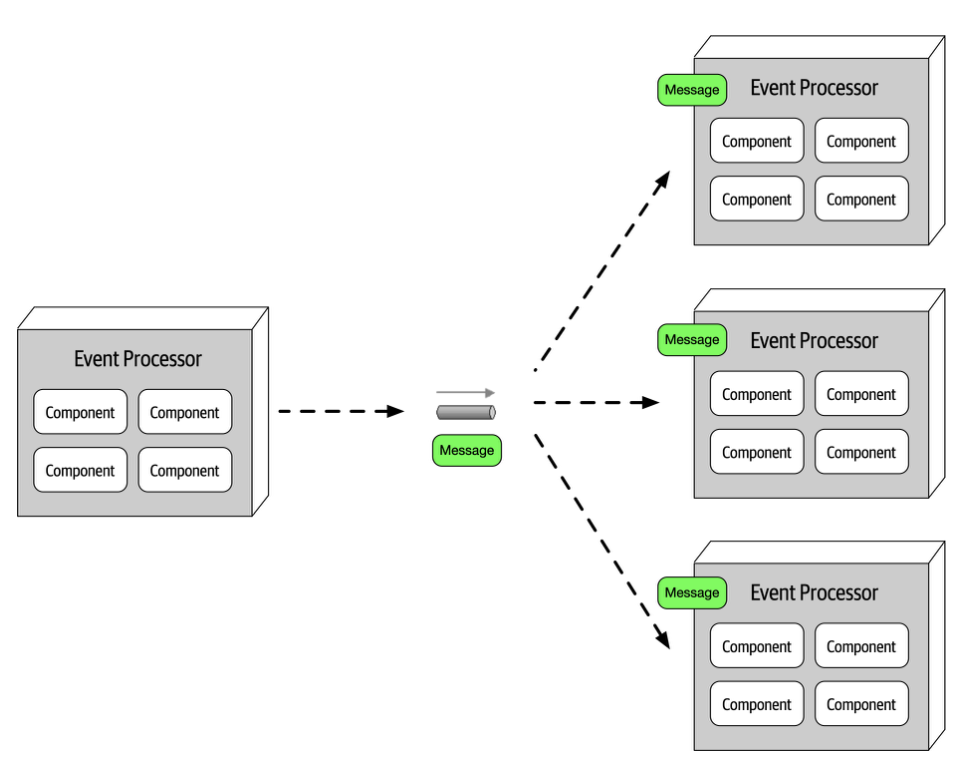
Одной из других уникальных характеристик событийной архитектуры является возможность транслировать события без знания того, кто (если кто-либо) получает сообщение и что они с ним делают.
Broadcast, наверное, один из самых эффективных видов развязанности. Производитель ничего не знает о том, кто будет читать его данные и, что с ними делать. Добавление нового потребителя ни как не повлияет на производителя.
Топология рабочего процесса
В архитектуре, управляемой событиями, есть две основные топологии: топология брокера и типология медиатора. Топология медиатора обычно используется, когда вам требуется контроль над рабочим процессом события, в то время как топология брокера используется, когда вам требуется высокая степень отклика и динамический контроль над обработкой события. Поскольку характеристики архитектуры и стратегии реализации различаются между этими двумя топологиями, важно понимать каждую из них, чтобы знать, что лучше всего подходит для конкретной ситуации.
Топология брокера
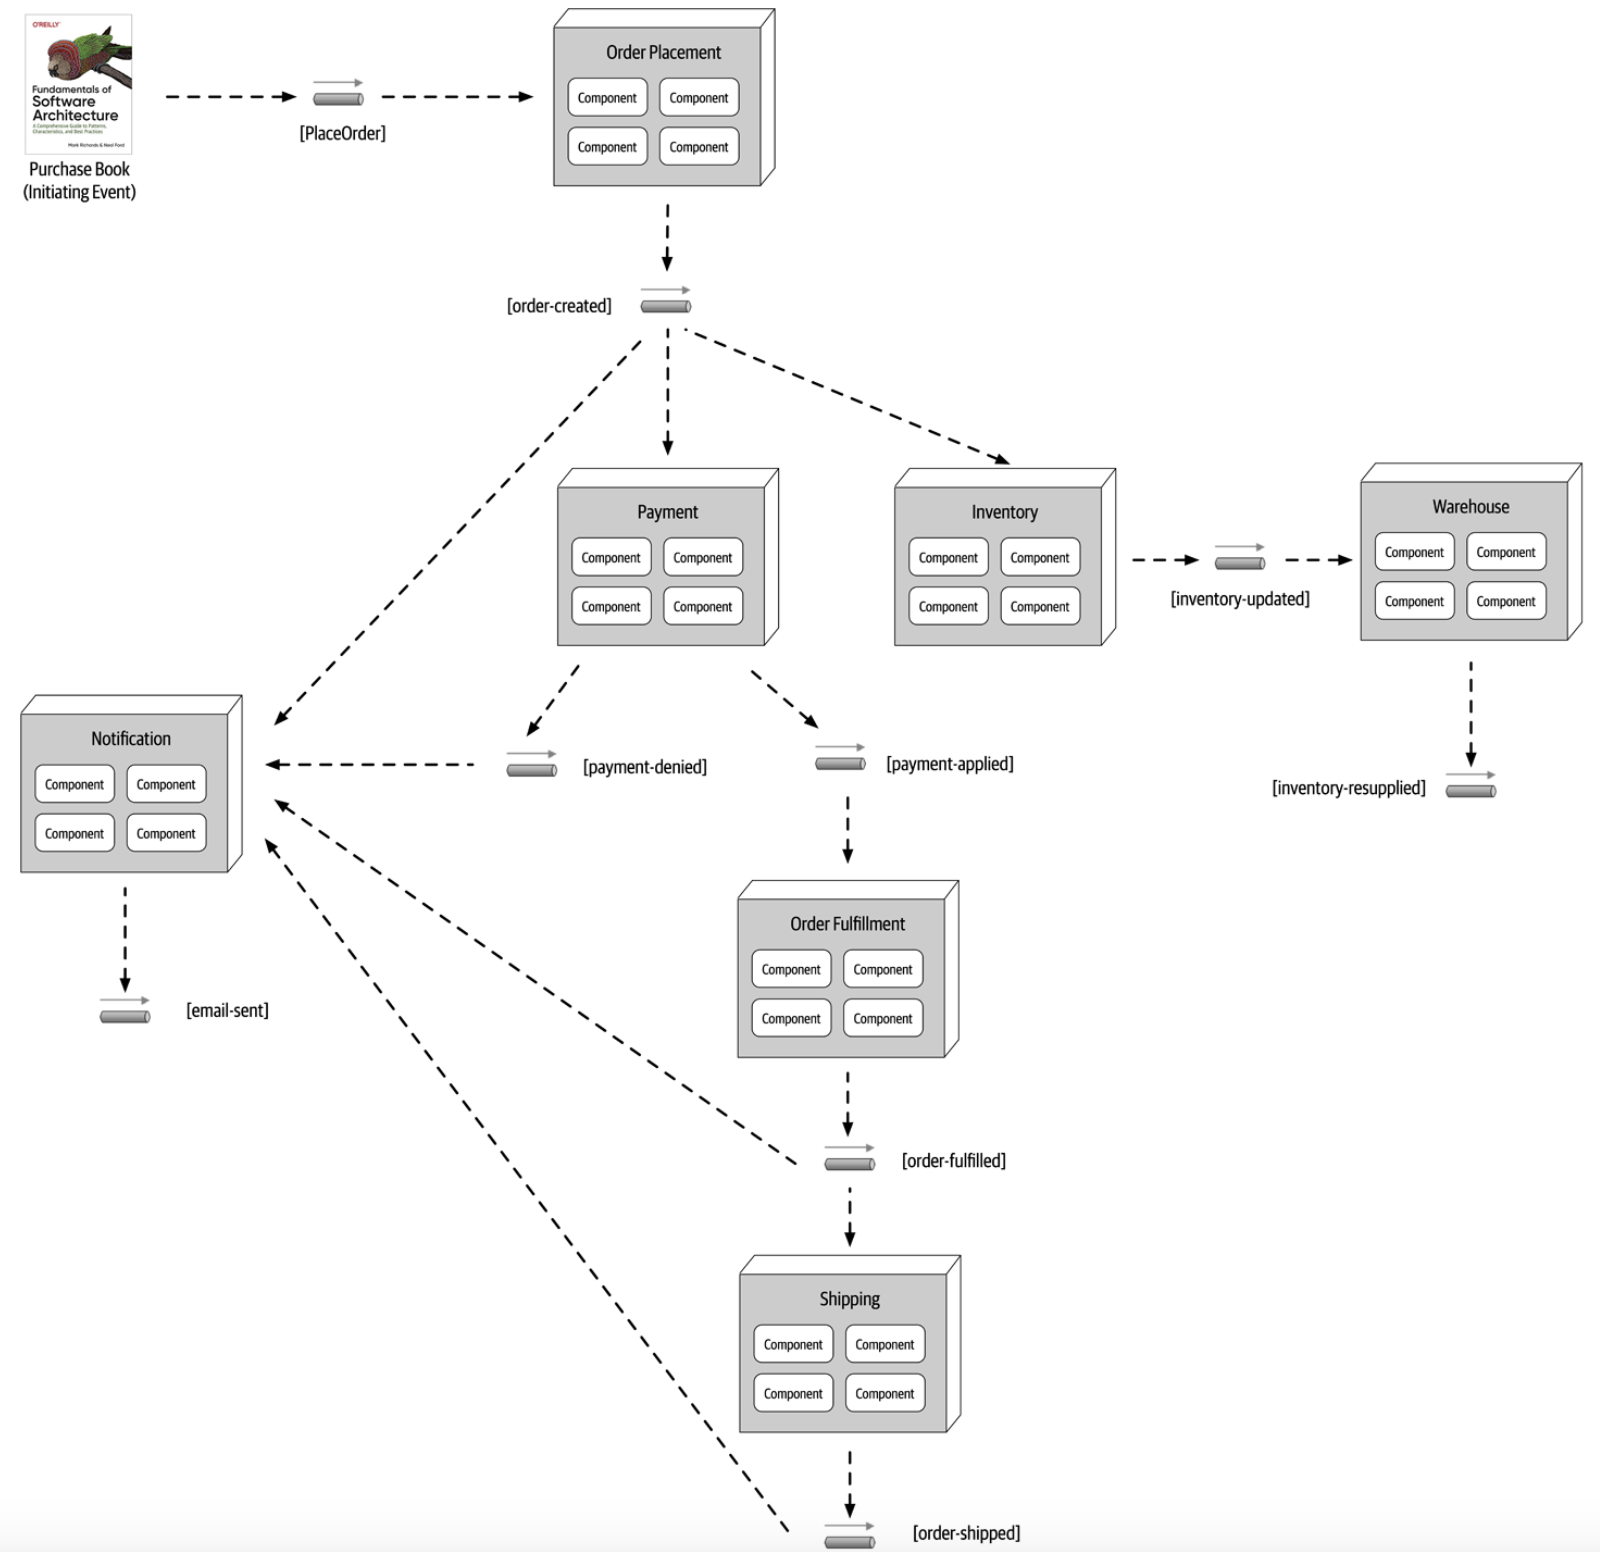
Топология брокера отличается от топологии медиатора тем, что нет центрального медиатора событий. Скорее, поток сообщений распределяется по компонентам процессора событий цепным способом через легкий брокер сообщений (например, RabbitMQ, ActiveMQ и так далее). Эта топология полезна, когда у вас относительно простой поток обработки событий, и вам не нужна центральная координация событий.
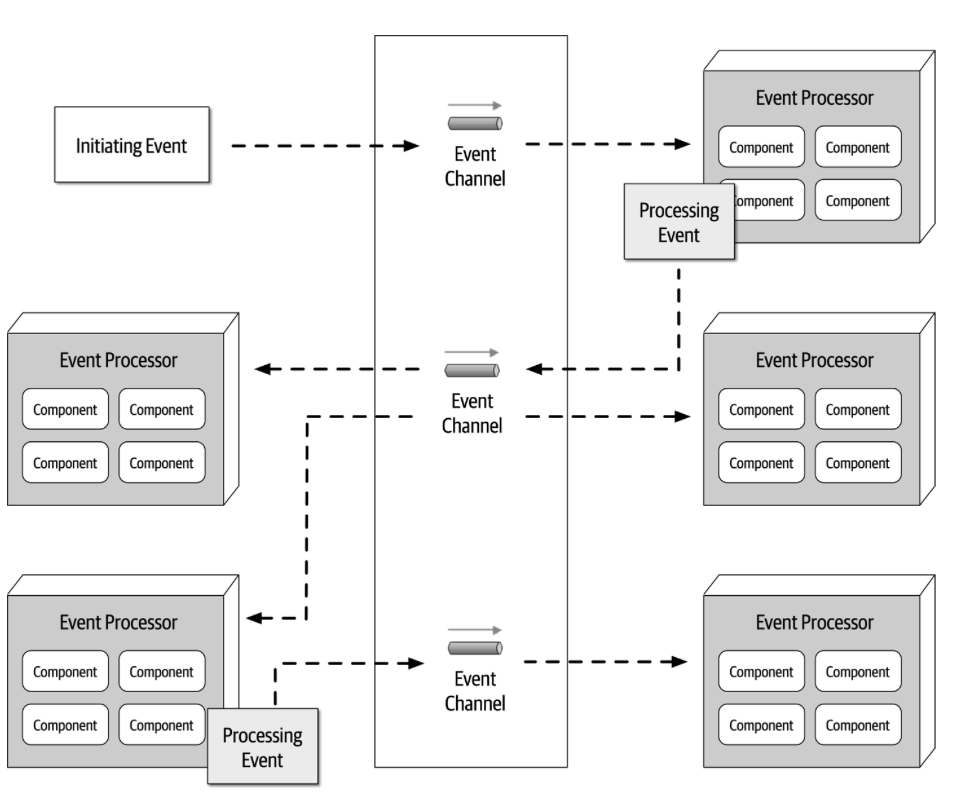
На рисунке изображена типичная топология без центрального медиатора. Классическая хореография.
На примере ниже можно понять насколько становится сложно управлять рабочим процессом. Логика рабочего процесса разнесена по всем компонентам рабочего процесса.
Преимущества | Недостатки |
|---|---|
Сильная развязанность обработчиков событий | Контроль рабочего процесса |
| Высокая масштабируемость | Обработка ошибок |
Высокая отзывчивость | Восстанавливаемость |
| Высокая производительность | Возможности перезапуска |
Высокая отказоустойчивость | Неконсистентность данных |
Топология медиатора
Топология медиатора событийной архитектуры устраняет некоторые недостатки топологии брокера, описанные в предыдущем разделе. Центральное место в этой топологии занимает посредник событий, который управляет и контролирует рабочий процесс для инициирования событий, требующих координации нескольких обработчиков событий. Компонентами архитектуры, составляющими топологию медиатора, являются инициирующее событие, очередь событий, посредник событий, каналы событий и обработчики событий.
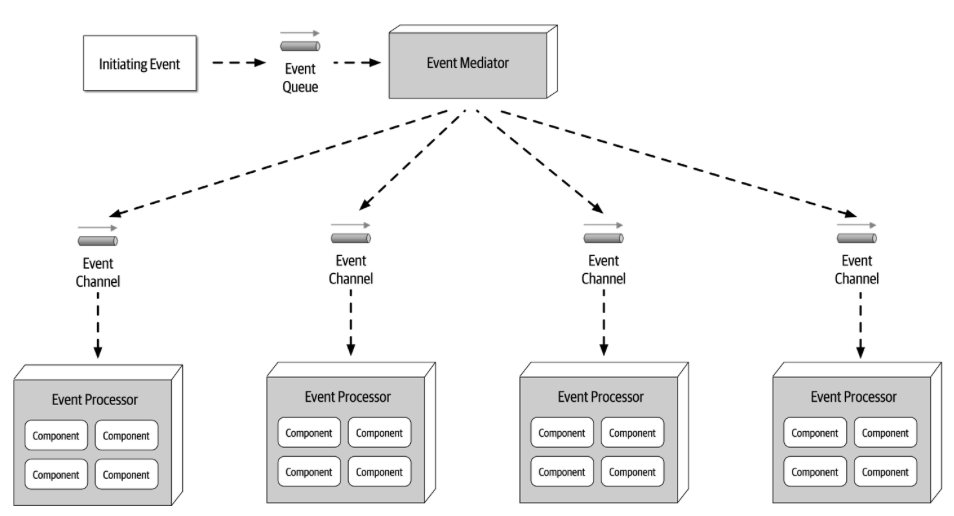
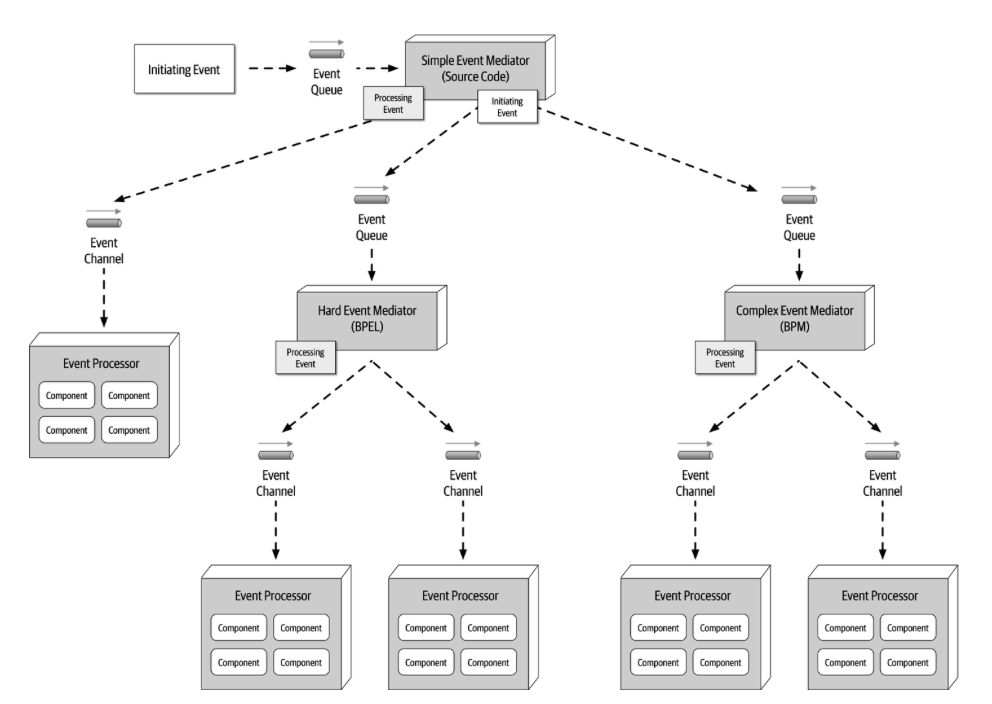
Медиатор можно реализовать разными технологиями:
- медиаторы для простых рабочих процессов
- Apache Camel
- Mule ESB
- Spring Integration
- ...
- медиаторы для сложных рабочих процессов на основе BPEL
- Apache ODE
- ...
- медиаторы для сложных процессов с ручными шагами на основе BPM
- jBPM
- Camunda
- ...
При выборе медиатора полагайтесь на сложность рабочего процесса. Использование BPM будет перебор для простых рабочих процессов, вы потратите слишком много времени на изучение и адаптацию инструмента. Выбрав Apache Camel для сложных процессов с ручными шагами вы попадаете на большую и долгую разработку.
В большинстве реализаций топологии медиатора существует несколько медиаторов, обычно связанных с определенной областью или группой событий. Это уменьшает проблему с единой точкой сбоя, связанную с этой топологией, а также увеличивает общую пропускную способность и производительность.
Преимущества | Недостатки |
|---|---|
Контроль рабочего процесса | Больше связи обработчиков событий |
Обработка ошибок | Низкая масштабируемость |
| Восстанавливаемость | Низкая производительность |
Возможности перезапуска | Низкая отказоустойчивость |
Улучшенная согласованность данных | Моделирование сложных рабочих процессов |
Выбор между топологией брокера и посредника, по сути, сводится к компромиссу между управлением рабочим процессом и возможностью обработки ошибок по сравнению с высокой производительностью и масштабируемостью. Хотя производительность и масштабируемость все еще хороши в топологии медиатора, они не так высоки, как в топологии брокера.
Практики
Error Handling
Шаблон событий рабочего процесса реактивной архитектуры является одним из способов решения проблем, связанных с обработкой ошибок в асинхронном рабочем процессе. Этот шаблон представляет собой шаблон реактивной архитектуры, который учитывает как отказоустойчивость, так и отзывчивость. Другими словами, система может быть устойчивой с точки зрения обработки ошибок без влияния на отзывчивость.
Предположим, что в нашей событийной архитектуре произошла ошибка, что будет, если мы будем пытаться ее обработать непосредственно потребителем?
Все остальные сообщения в очереди встанут в очередь и будут ждать выполнения сообщения с ошибкой. Хорошей стратегией для решения этой проблемы будет паттерн workflow processor. В случае возникновения ошибки на потребителе, он немедленно делегирует эту ошибку workflow processor и переходит к следующему сообщению в очереди событий. Таким образом, общая отзывчивость не ухудшается, потому что следующее сообщение обрабатывается немедленно.
Как только workflow processor получает сообщение с ошибкой, он пытается выяснить, что не так с сообщением. Если он может исправить сообщение, он это делает и отправляет сообщение в очередь потребителю как новое. В противном случае workflow processor отправляет сообщение с ошибкой в другую очередь для ручного анализа. Такое сообщение будет рассмотрено оператором в ручном режиме, по возможности исправлено и отправлено в очередь потребителю.
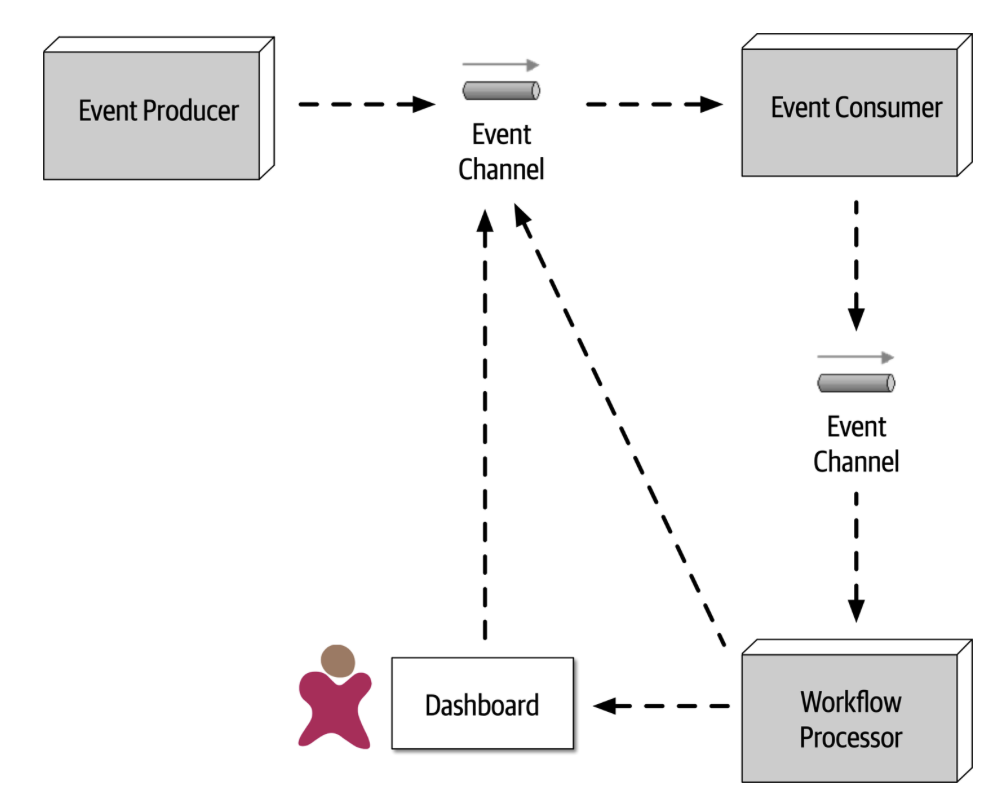
Перед отправкой сообщения в workflow processor стоит понимать, восстановимая ошибка вообще или нет. Недоступная третья система будет попрежнему недоступна и для нового сообщения. Вероятно стоит подождать ее восстановления.
Preventing Data Loss
Потеря данных всегда является основной проблемой при работе с асинхронной связью.
Рассмотрим три сценария потери данных:
- Сообщение никогда не попадает в очередь из Event Processor A или брокер не гарантирует отправку сообщения в Event Processor B. Для решений этих проблем есть два механизма:
- Event Processor B забирает из очереди следующее доступное сообщение и вылетает, прежде чем сможет обработать событие.
- Event Processor B не может сохранить сообщение в базе данных из-за некоторой ошибки.
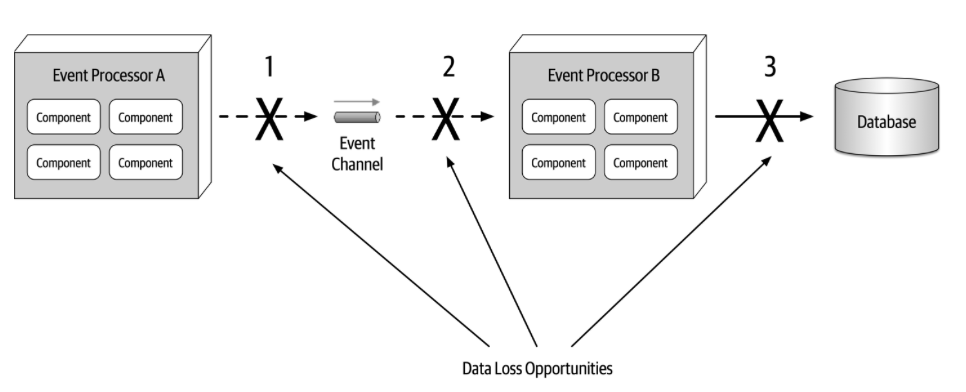
Решение в том же порядке:
- Synchronous send. Отправка сообщения блокируется до тех пор пока потребитель не даст подтверждение, что сообщение получено очередью. Persistent queues. Очередь должна сохранять сообщения не только в памяти, но и на диск. И при выходе очереди из строя данные не будут потеряны.
- Client acknowledge mode. Потребитель должен давать подтверждение, что сообщение обработано и не брать в обработку следующее сообщение.
- Используйте ACID транзакции или другие механизмы гарантированной фиксации сообщений в базе. Использование так называемой last participant support (LPS) удаляет сообщение из постоянной очереди, признавая, что обработка завершена и что сообщение было сохранено.
last participant support это протокол двухфазной транзакции. При вычитке сообщения из очереди она блокируется за тем потребителем, который прочитал это сообщение. А при подтверждении потребителем обработки, сообщение фиксируется и удаляется из очереди или производится смещение чтения на новое сообщение.
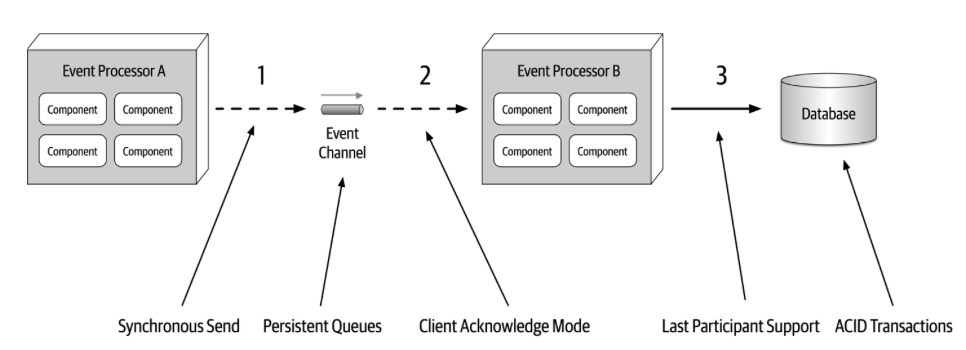
Третий пункт не так очевиден как кажется. А что, если стейт в базе обновился, а комит на стороне брокера не произошел? Сообщение будет вычитано и обработано повторно.
Idempotent Consumer
Реализуйте идемпотентного потребителя, который является потребителем сообщений, который может правильно обрабатывать повторяющиеся сообщения. Некоторые потребители естественно идемпотентны. Другие должны отслеживать сообщения, которые они обработали, чтобы обнаруживать и отбрасывать дубликаты.
Вы можете сделать потребителя идемпотентным, записав в базу данных идентификаторы сообщений, которые он успешно обработал. При обработке сообщения потребитель может обнаруживать и удалять дубликаты, запрашивая базу данных. Есть несколько разных мест для хранения идентификаторов сообщений. Один из вариантов — потребитель может использовать отдельную PROCESSED_MESSAGES таблицу. Другой вариант заключается в том, чтобы потребитель сохранял идентификаторы в бизнес-сущностях, которые он создает или обновляет.
Transactional messaging
При работе с очередями рано или поздно возникает вопрос. Как надежно/атомарно обновлять базу данных и отправлять сообщения/события в очередь?
Какие варианты первыми приходят в голову:
- Записать сообщение в базу, а затем отправить в очередь. А, что будет если брокер или медиатор не доступен? Состояние в базе обновится, но нижестоящие потребители не узнают об изменении состояния в базу данных.
- Отправить сообщение в очередь, а затем обновить базу данных. А, что будет если база данных недоступна или вернула ошибку? По видимому сообщение с новым стейтом улетит потребителям, но оригинал не изменится.
- Может тогда открыть транзакцию, обновить стейт в базу, отправить сообщение в очередь, закомитить транзакцию. Что будет если комит не пройдёт? По видимому сообщение с новым стейтом улетит потребителям, но оригинал не изменится.
Очевидно, что ни один из этих вариантов не подходит. Какие же есть варианты решения этой проблемы?
Для решения этой проблемы существует целый ряд паттернов которые можно разбить условно на две категории:
- паттерны, записывающие события в "таблицу" EVENTS
- Transactional outbox. Сервис, использующая реляционную базу данных, вставляет сообщения/события в таблицу исходящих сообщений как часть локальной транзакции. Служба, использующая базу данных NoSQL, добавляет сообщения/события к атрибуту обновляемой записи (например, документа или элемента).
- Database triggers. Один или несколько триггеров базы данных вставляют события в
EVENTSтаблицу.
- паттерны, публикующие событие из EVENTS в очередь - паттерны-ретрансляторы.
- Polling publisher. Публикуйте сообщения, опрашивая таблицу исходящих сообщений базы данных.
- Transaction log tailing. Вычитка событий для публикации из transaction log (WAL) и ретрансляция сообщений в брокер сообщений.
Request-Reply
Предположим, что в событийной архитектуре пользователю необходимо дождаться ответа от потребителя. Для таких целей используются две очереди: очередь запросов и очередь ответов.
Производитель отправляет сообщение в очередь запросов и блокирует поток исполнения до тех пор, пока не получит ответное сообщение в очередь ответов.
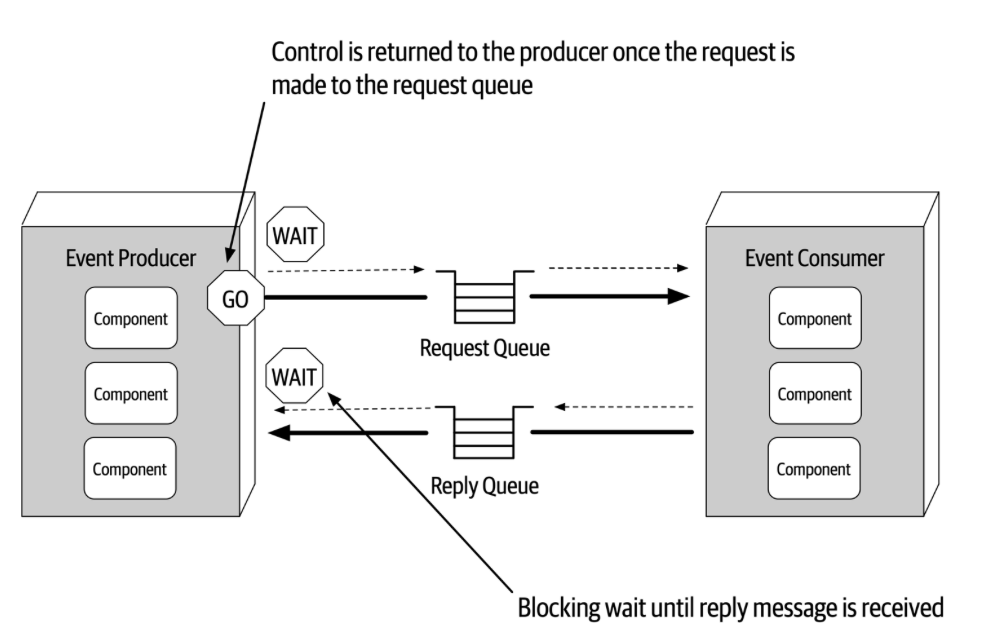
В контексте событийной архитектуры подход с блокировками производителя имеет место быть, но в случае гибридных архитектур проще вызвать синхронный метод.
Event Notification
Не редко в проектируемых нами системах требуется уведомить третью систему о факте совершения какого-то действия, но ждать ответа о подтверждении факта обработки этого уведомления не нужно. Такой подход может сократить время отклика, пропускную способность системы и повысить надежность решения.
Шаблон уведомления потребителя использует небольшое сообщение о событии, чтобы указать, что что-то изменилось (например, новый или обновленный заказ). Событие содержит ссылку на данные, которые изменились, но очень мало. Как и в случае с другими шаблонами распределенных событий, событие может быть предоставлено потребителям через канал подписки или может использовать посредника, такого как брокер сообщений.
Claim-Check
Архитектура, основанная на обмене сообщениями, в какой-то момент должна иметь возможность отправлять, получать и манипулировать большими сообщениями. Такие сообщения могут содержать что угодно, включая изображения (например, снимки МРТ), звуковые файлы (например, звонки в колл-центр), текстовые документы или любые двоичные данные произвольного размера.
Сохраните всю полезную нагрузку сообщения во внешней службе, например в базе данных. Получите ссылку на сохраненную полезную нагрузку и отправьте только эту ссылку на шину сообщений. Клиенты, заинтересованные в обработке этого конкретного сообщения, могут использовать полученную ссылку для извлечения полезной нагрузки, если это необходимо.
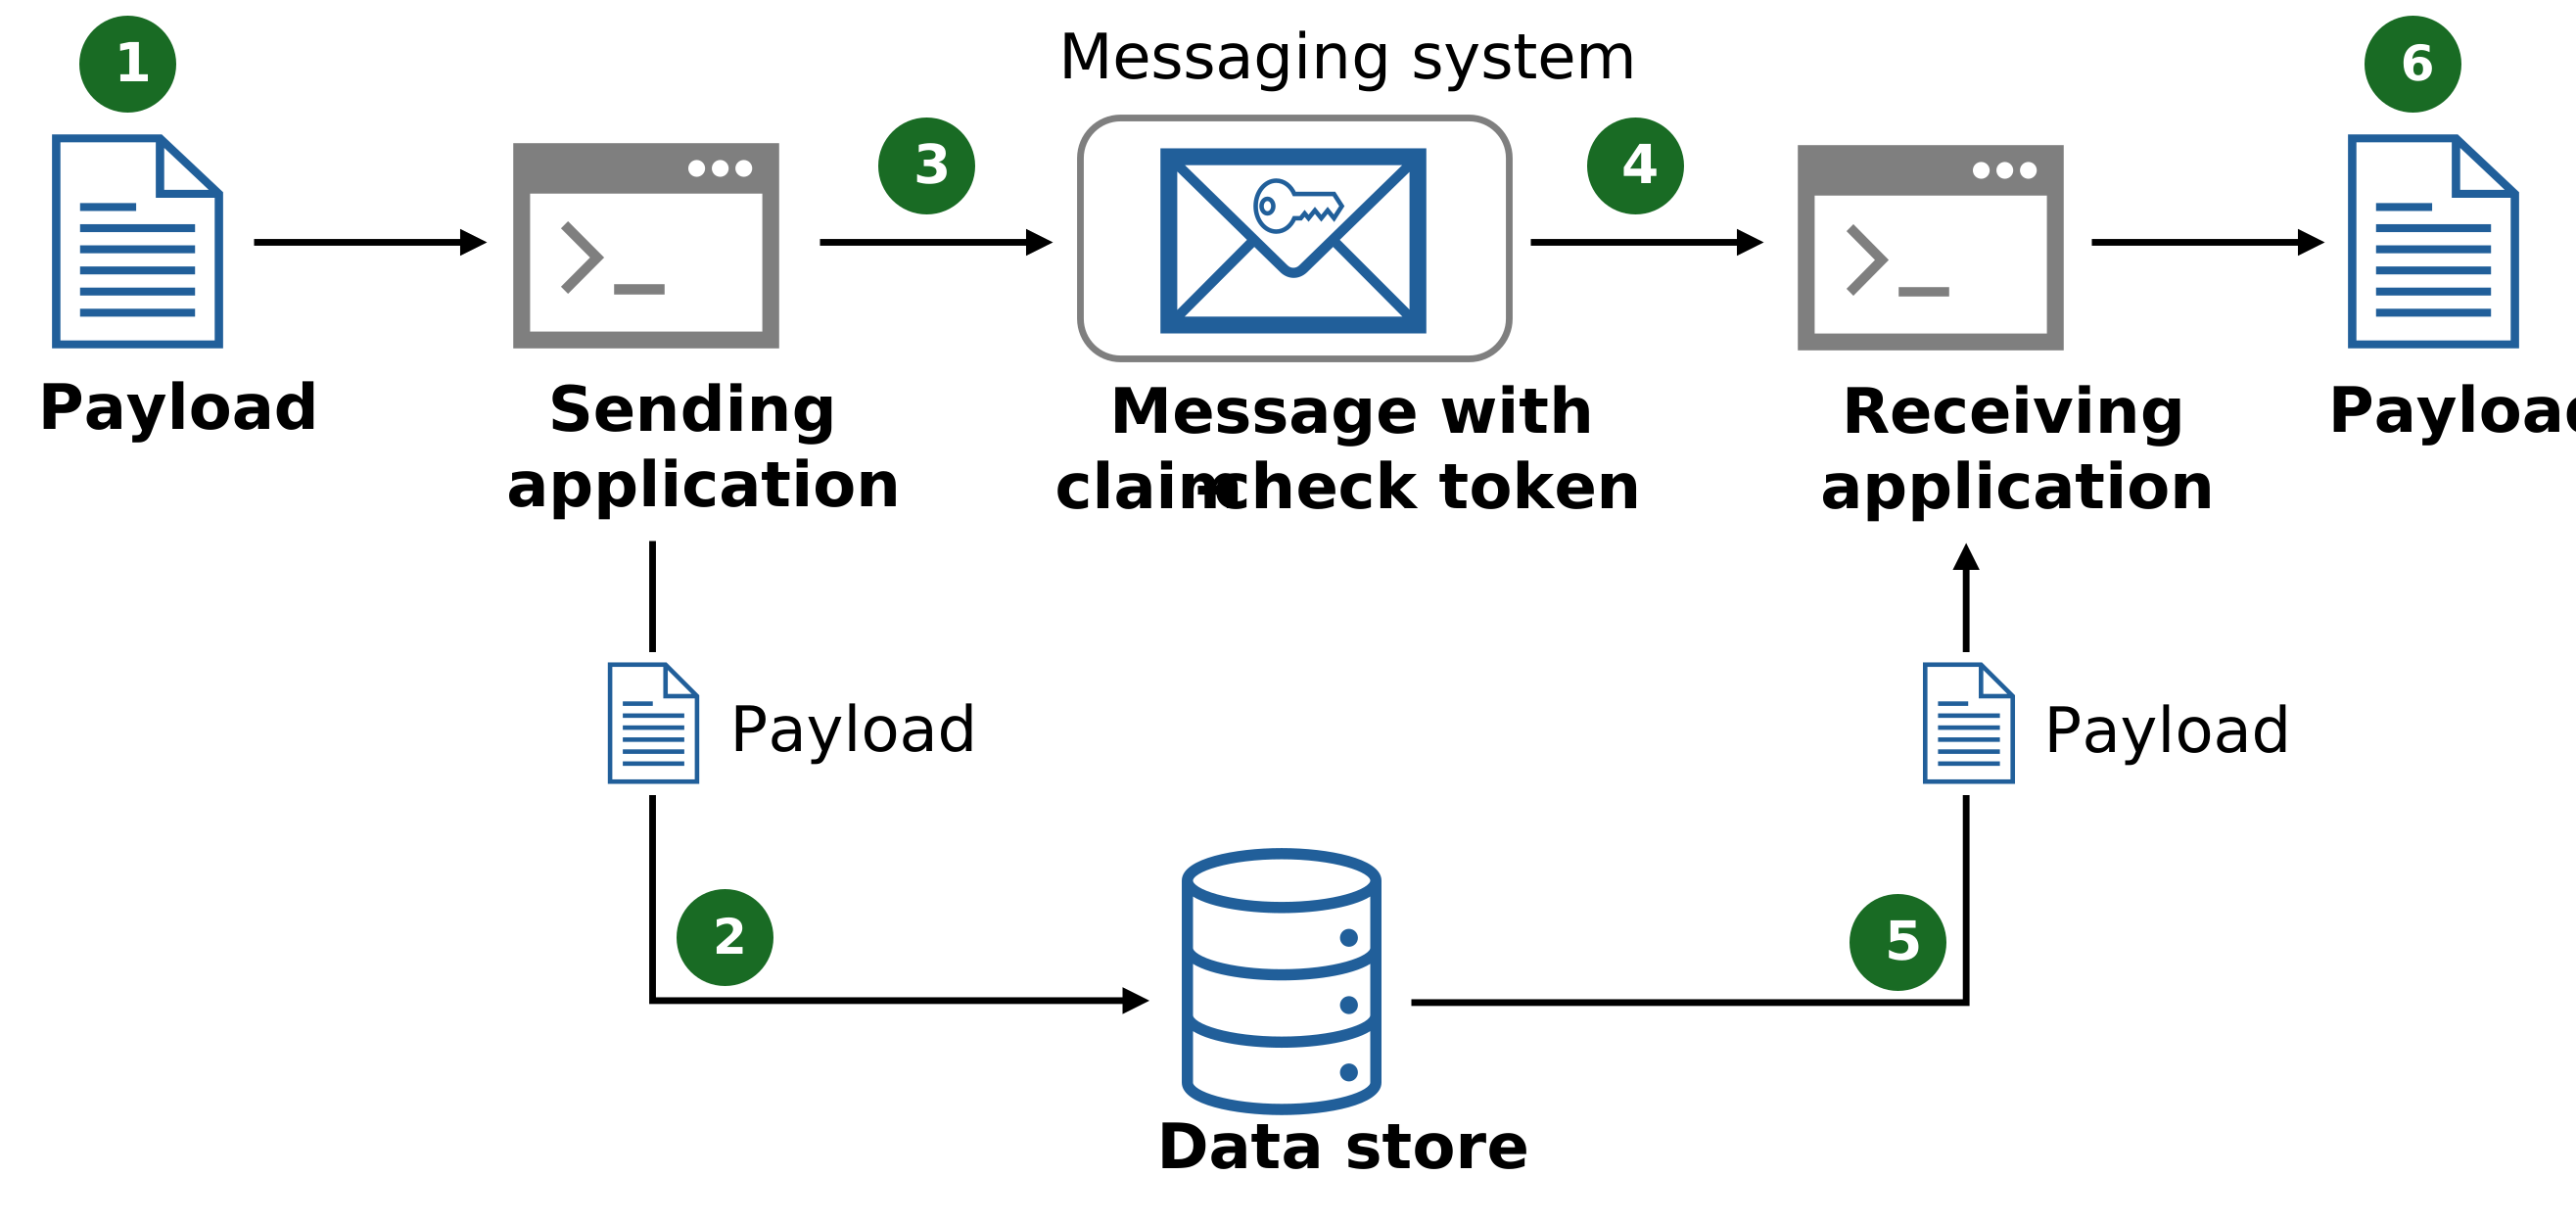
- Полезная нагрузка
- Сохранение полезных данных в хранилище данных.
- Создайте маркер проверка утверждения и отправьте сообщение с помощью маркера проверка утверждения.
- Получение сообщения и чтение маркера утверждения проверка.
- Извлеките полезные данные.
- Обработка полезных данных.
Event-Carried State Transfer
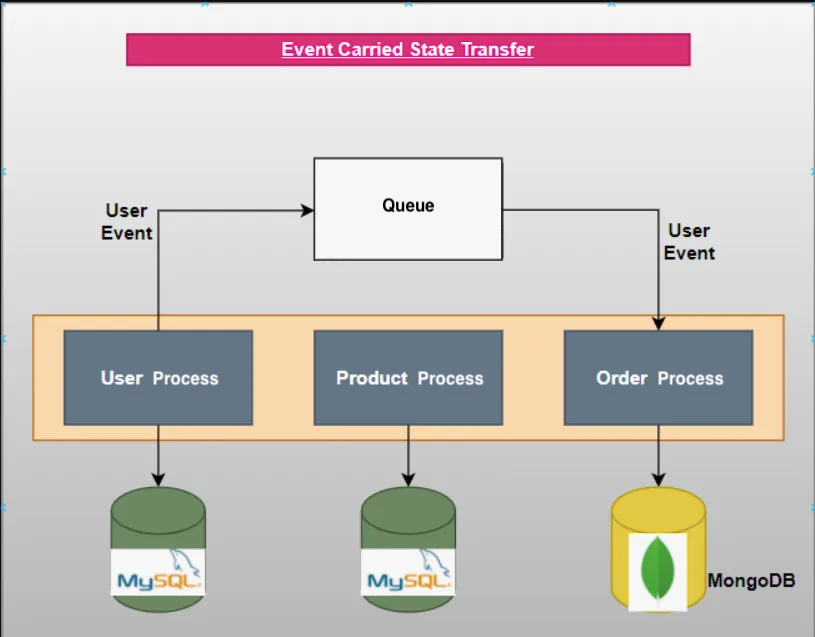
В распределенной среде доступ к чужим данным может стать дорогой операцией. Как с точки зрения производительности, так и с масштабированием и отказоустойчивостью. Представьте, что для потребителя событий информации в событии недостаточно для совершения какого-то действия. За информацией придется идти к производителю. В итоге мы попадаем в ситуацию, при которой потребитель полностью зависит от производителя для выполнения своей логики.
Один из способов совместного использования данных — использование событий, которые запускаются, когда компонент, владеющий данными, изменяет их. Событие будет нести с собой всю новую версию данных . Компоненты, заинтересованные в этих данных, будут прослушивать эти события и реагировать на них, сохраняя локальную копию этих данных. Таким образом, когда им понадобятся эти внешние данные, они будут иметь их локально, им не нужно будет запрашивать их у другого компонента.
Trade-Offs
| Преимущества | Недостатки |
|---|---|
Улучшенный отклик для пользователя на изменяющийся контент. Системы управляемые событиями позволяют строить независимые представления одних и тех же данных, оптимизированные под конкретный сценарий. | Поддерживает только конечную согласованность |
Лучшая масштабируемость и эластичность. Разделение производителей и потребителей позволяет их масштабировать независимо, а промежуточный буфер в виде брокера позволяет переживать пики нагрузки между ними без необходимости добавления ресурсов. | Неэкономичность. Системы, управляемые событиями, более требовательны у ресурсам. Добавляется брокер сообщений. И некоторые из паттернов подразумевают дублирование данных. |
Лучшая гибкость и управление изменениями. Broadcast даёт нам возможность подключать новые потребители не изменяя при этом производителя. По сути производитель может и не знать кто к нему подключен. | Меньший контроль над потоком обработки. |
Лучшая отзывчивость и производительность. Системы управляемые событиями не обязаны дожидаться завершения исполнения задания. | Сложно тестировать и отлаживать. |
Устойчивость к сбоям. Выход одного компонента из строя не приводит к недоступности всей системы. | Сложность в разработке. Событийные системы сложнее для разработки. Разработчику привычнее воспринимать системы в request-based парадигме. При котором завершение запроса гарантирует изменение состояния системы. При событийной архитектуре изменения в системе произойдёт когда-то в будущем, что не так тривиально для понимания. |
Когда использовать
Стиль хорошо подходит, когда важен:
- высокий уровень развязанности архитектуры. Отправители и получатели независимы друг от друга. Нет точек интеграции. Очень легко добавлять в систему новые объекты-получатели.
- высокая масштабируемость. Производители и потребители масштабируются независимо друг от друга
- отзывчивость и надежность. Выход из строя производителя никак не повлияет на потребителя
Сложности
- Гарантированная доставка. В некоторых системах важно гарантировать доставку событий.
- Обработка событий в строгом порядке и (или) строго один раз. Каждый тип потребителя обычно выполняется на нескольких экземплярах, чтобы обеспечить надежность и масштабируемость. Это может создать проблему, если события должны обрабатываться в строго определенном порядке или не реализована логика обработки идемпотентных сообщений.
Сам по себе этот архитектурный стиль не существует, это всегда гибрид с какой-то другой архитектурой, такой как: Service-Oriented Architecture, Space-Based Architecture, Microservices Architecture.
Связанные шаблоны
| Название | Описание | Позитивные драйверы | Негативные драйверы |
|---|---|---|---|
| Event-Carried State Transfer | Полное событие позволяющее построить на стороне потребителя текущее представление объекта | Reliability, Performance, Scalability, Maintainability | Simplicity |
| Claim-Check | Разделите большое сообщение на уведомление и полезную нагрузку. Отправьте уведомление на платформу обмена сообщениями и сохраните полезные данные во внешней службе. Этот шаблон позволяет обрабатывать большие сообщения, защищая при этом шину сообщений и клиент от перегрузки или замедления. Этот шаблон также помогает снизить затраты, поскольку хранение обычно дешевле, чем единицы ресурсов, используемые платформой обмена сообщениями. Этот шаблон также известен как «Обмен сообщениями на основе ссылок» | Performance efficiency | |
| Priority Queue | Приоритизируйте запросы, отправляемые сервисам, чтобы запросы с более высоким приоритетом получали и обрабатывали быстрее, чем запросы с более низким приоритетом. Этот шаблон полезен в приложениях, которые предлагают разные гарантии уровня обслуживания для отдельных клиентов. | Performance, Reliability | |
| Event Sourcing | Вместо того, чтобы хранить только текущее состояние данных в домене, используйте хранилище только для добавления, чтобы записывать полную последовательность действий, предпринятых с этими данными. Хранилище действует как система записи и может использоваться для материализации объектов предметной области. Это может упростить задачи в сложных доменах, устраняя необходимость синхронизации модели данных и бизнес-домена, повышая при этом производительность, масштабируемость и скорость отклика. Он также может обеспечивать согласованность транзакционных данных и поддерживать полные контрольные журналы и историю, что позволяет выполнять компенсирующие действия. | Performance, Supportability, Scalability | Simplicity |
| Event Notification | Шаблон уведомления потребителя о совершении какого-либо действия. Он несет только достаточно данных, чтобы слушатель знал, что произошло, и выполнял свой код. | Reliability, Performance, Scalability, Maintainability | Simplicity |
| Asynchronous Request-Reply | Отделите серверную обработку от внешнего хоста, где внутренняя обработка должна быть асинхронной, но внешний интерфейс по-прежнему нуждается в четком ответе. | Simplicity, Performance efficiency |
Рейтинг атрибутов качества
| Атрибуты качества | Рейтинг |
|---|---|
| Тип деления на модули | Техническое |
| Число квантов | 1-N |
| Deployability |  |
| Elasticity | |
| Maintainability | |
| Overall cost | |
| Performance | |
| Reliability | |
| Scalability | |
| Simplicity | |
| Testability | |
Наименьший балл получает простота использования. По праву это один из самых сложных архитектурных стилей. Множество нюансов, которые приходится учесть: как работать с конечной консистенцией, как обрабатывать ошибки, как добиться идемпотентности и тд.
Тестируемость тоже не самая сильная сторона такой архитектуры. Тестирование асинхронный поток, взаимосвязанных событий может оказаться адом.
Эволюционность, производительность, масштабируемость и отказоустойчивость является основными сильными сторонами этого архитектурного стиля. Высокая эволюционность достигается по нескольким факторам: broadcast message и Event-Carried State Transfer. Высокая производительность достигается благодаря асинхронной связи в сочетании с высокопараллельной обработкой. Высокая масштабируемость достигается за счет программной балансировки нагрузки процессоров событий (также называемых конкурирующими потребителями).