BigData Architecture
Описание
Архитектуру больших данных невозможно рассматривать в рамках архитектурных стилей. Мы не можем дать ей оценку релевантную рассмотренным архитектурам ранее, но и обойти стороной мы её тоже не можем.
В то время как рос IT росла и конкуренция. Анализ поведения пользователей стал важной задачей в эру высокой конкуренции. Какое-то время старые решения анализа данных справлялись, но быстро был достигнут предел. На смену пришли сложные распределенные системы. И у них была своя эволюция.
Далее рассмотрены 3 поколения платформ для сбора данных и аналитики: Data Warehouse, Data Lake, Data Mesh.
Все 3 поколения хорошо рассмотрены в главах Learning Domain-Driven Design и Hard Parts:
- “Chapter 16. Data Mesh.” In Learning Domain-Driven Design: Aligning Software Architecture and Business Strategy, First edition. O’Reilly, 2021.
- “Chapter 14. Managing Analytical Data.” In Software Architecture: The Hard Parts: Modern Trade-off Analysis for Distributed Architectures, First edition. O’Reilly Media, 2021.
Также эти темы разбирали в книжном клубе Code of Architecture:
Data Warehouse
Data Warehouse (DWH) был первой реализацией BigData архитектуры.
Топология
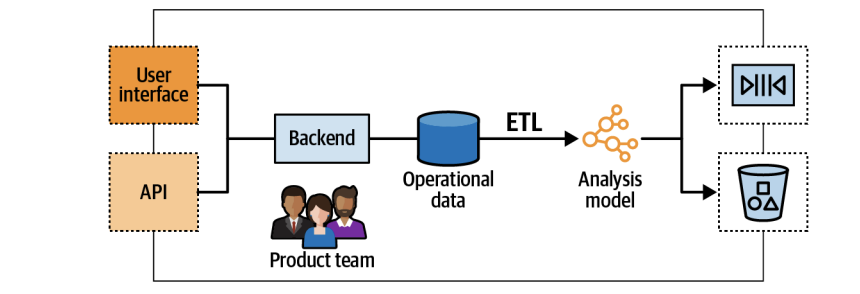
Архитектура хранилища данных (DWH) обладает довольно простой концепцией. Она включает в себя несколько ключевых этапов:
- На первом этапе происходит извлечение данных из различных операционных систем, где они изначально хранятся
- Затем собранные данные проходят процесс трансформации, в ходе которого они преобразуются в формат, удобный для аналитики. Это может включать очистку данных, их объединение или агрегацию.
- На финальном этапе происходит загрузка обработанных данных в специализированную базу данных, разработанную именно для целей анализа.
Эта архитектура управления данными основана главным образом на сценариях извлечения-преобразования-загрузки (Extract-Transform-Load, ETL). Данные могут поступать из различных источников: оперативные базы данных, потоковые события, журналы и так далее.
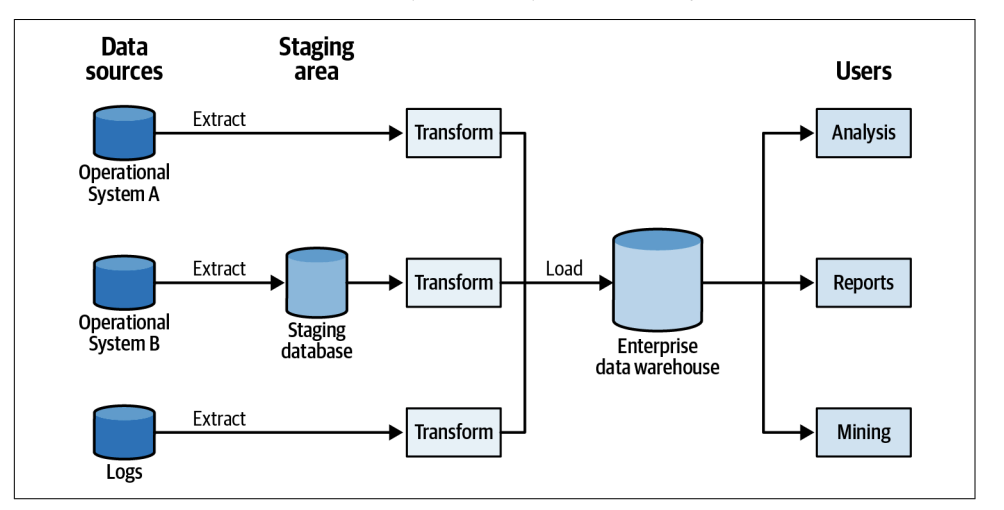
Основные характеристики DWH решения:
- Данные загружаются из множества источников
- Данные преобразуются в единую схему
- Данные загружаются в единое хранилище
- Анализ проводится в хранилище
- Пользователи: аналитики данных
- Результат работы: BI отчеты и дашборды
- SQL-like язык для запросов
Trade-Offs
| Преимущества | Недостатки |
|---|---|
| Простое решение | Архитектура построена на общей модели данных, что потенциально ведет в тупик. Примером этому может служить Service-Oriented Architecture. |
| Централизованная консолидация данных | Операционная база имеет сильную связь с аналитической моделью, что затрудняет эволюционность и формирует интеграционную хрупкость: любые изменения на уровне продукта могут привести к сбоям в работе аналитики. |
| Зона ответственности размазывается, что приводит к плохому качеству данных. Специалисты больших данных — это технические специалисты. С предметной областью они знакомы слабо. |
Обсуждение
Модель DWH - хороший пример технического разделения в архитектуре программного обеспечения: разработчики хранилища преобразуют данные в схему, которая облегчает запросы и анализ, но при этом теряется любое доменное разделение. Это происходит потому, что основная цель DWH — создать единую модель данных для всего предприятия. При необходимости домены воссоздаются в запросах.
Сильная связь операционных и аналитических данных приводит к тому, что 90% временя data инженеры исправляют совместимость с операционными данными, а оставшиеся 10% пытаются разобраться в домене.
Data Lake
Data Lake пытается закрыть часть проблем DWH. В частности общей модели.
Топология
Data Lake старается решить проблему общий схемы предприятия сохраняя данные в неструктурированном виде (в формате изначального операционного хранилища) в так называемом озере (Lake). Трансформация данных выполняется фактически по необходимости. Когда аналитикам данных потребуется работать с сырыми данными, они будут отправлены в DWH по средством ETL из lake. Таким образом разные аналитики данных могут использовать нужную только им модель.
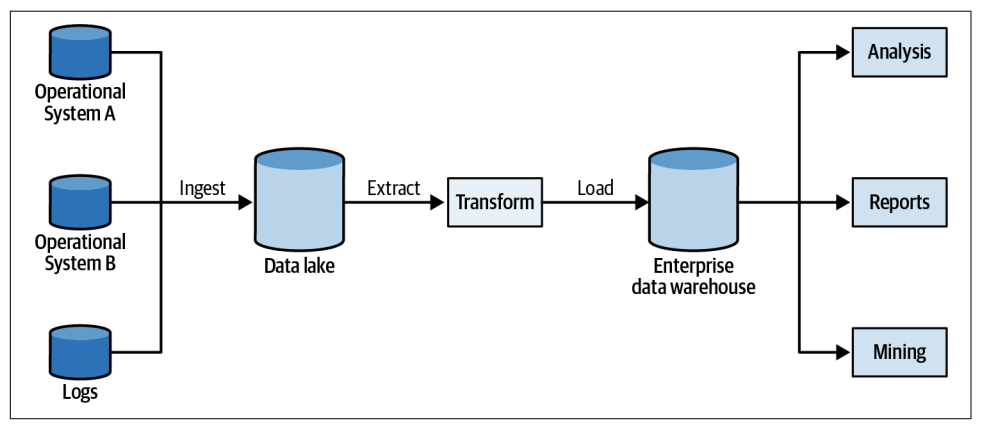
Основные характеристики Data Lake решения:
- Данные загружаются из множества источников
- Данные загружаются в lake - хранилище неструктурированных данных
- Пользователи: data scientists. Ищут данные в lake и выполняют любые агрегации, композиции и другие преобразования, необходимые для ответа на конкретные вопросы.
Trade-Offs
| Преимущества | Недостатки |
|---|---|
| Разделение схемы данных позволило операционным подразделениям эволюционировать свою схему | С неструктурированными данными становится сложно работать. Уже никто не гарантирует целостности модели. Операционная модель эволюционирует, а аналитическая становится помойкой данных |
| Появилась возможность работать с разными аналитическими моделями в зависимости от сценария | Сильно усложнилась работа аналитиков данных и самой системы |
| Преобразование из сырых данный в нужную модель занимает много времени | |
| Зона ответственности размазывается, что приводит к плохому качеству данных. Специалисты больших данных это технические специалисты с предметной областью они не знакомы | |
| Возникает множественное копирование данных в разных представлениях: Операционное, Lake, DWH. |
Обсуждение
Data Lake, по сути, является обратной стороной DWH. Сохраняя централизованную модель и конвейеры, он инвертирует модель хранилища данных "преобразование и загрузка" в модель "загрузка и преобразование".
По сравнению с DWH, Data Lake является schema-less решением. Контроль схемы ложится на аналитиков, которые преобразуют данные в удобный для текущей задачи формат. Но в результате проблема совместимости с операционными данными просто немного откладывается. А также порождает хаос в неструктурированных данных внутри Lake и в многочисленных трансформациях. Преобразование операционных моделей в аналитические сводится к тысячам необслуживаемых, специальных сценариев ETL в масштабе.
Ссылки
- Fowler, Martin. “Data Lake”
- The Curse of the Data Lake Monster
Оптимизации Data Lake
Отдельно выделяют поколение платформ направленных на оптимизацию Data Lake решений. Они добавляют:
- потоковую передачу данных в режиме реального времени с помощью таких архитектур, как Kappa
- объединение пакетной и потоковой обработки для преобразования данных с помощью таких фреймворков, как Apache Beam
- внедрение облачных управляемых сервисов для хранения, механизмов выполнения конвейеров данных и платформ машинного обучения
Примером подобного решения может быть Lakehouse система, например Delta Lake. В данном курсе не углубляемся в детали подобных систем и приводим как промежуточный шаг в развитии BigData архитектур.
Ссылки
- Armbrust, Michael, Ali Ghodsi, Reynold Xin, and Matei Zaharia. “Lakehouse: A New Generation of Open Platforms That Unify Data Warehousing and Advanced Analytics” 2021.
- Dehghani, Zhamak. “How to Move Beyond a Monolithic Data Lake to a Distributed Data Mesh”
Data Mesh
Data Mesh третья и на данный момент последняя попытка обуздать большие данные. Автором и основным идеологом этой парадигмы является Жамак Дегани.
Data Mesh - это социотехнический подход к децентрализованному обмену, доступу и управлению аналитическими данными. Он отвечает разнообразным аналитическим потребностям, включая составление отчетов и обучение моделей машинного обучения. Это достигается за счет передачи ответственности за аналитические данные в команды бизнес-доменов и обеспечения возможности однорангового потребления данных.
Архитектура Data Mesh в определенной степени можно считать аналогом Domain-Driven Design (DDD) для аналитических данных. В то время как различные паттерны DDD (например, Bounded Context и Domains) устанавливают четкие границы и определяют ответственность за свои компоненты, архитектура Data Mesh фокусируется на определении и защите границ моделей и прав собственности на аналитические данные, что способствует более эффективному управлению и использованию информации в рамках организации.
Необходимо отметить, что данный подход во многом организационный. Это можно будет увидеть из принципов, которые рассмотрены ниже. Именно поэтому данный подход называют социотехническим.
Топология
Архитектура Data Mesh основана на четырех основных принципах:
- Разложение данных по доменам (Domain Ownership)
- Данные как продукт (Data as a Product)
- Платформа данных (Self-Serve data platform)
- Федеративный орган управления (Federated Governance)
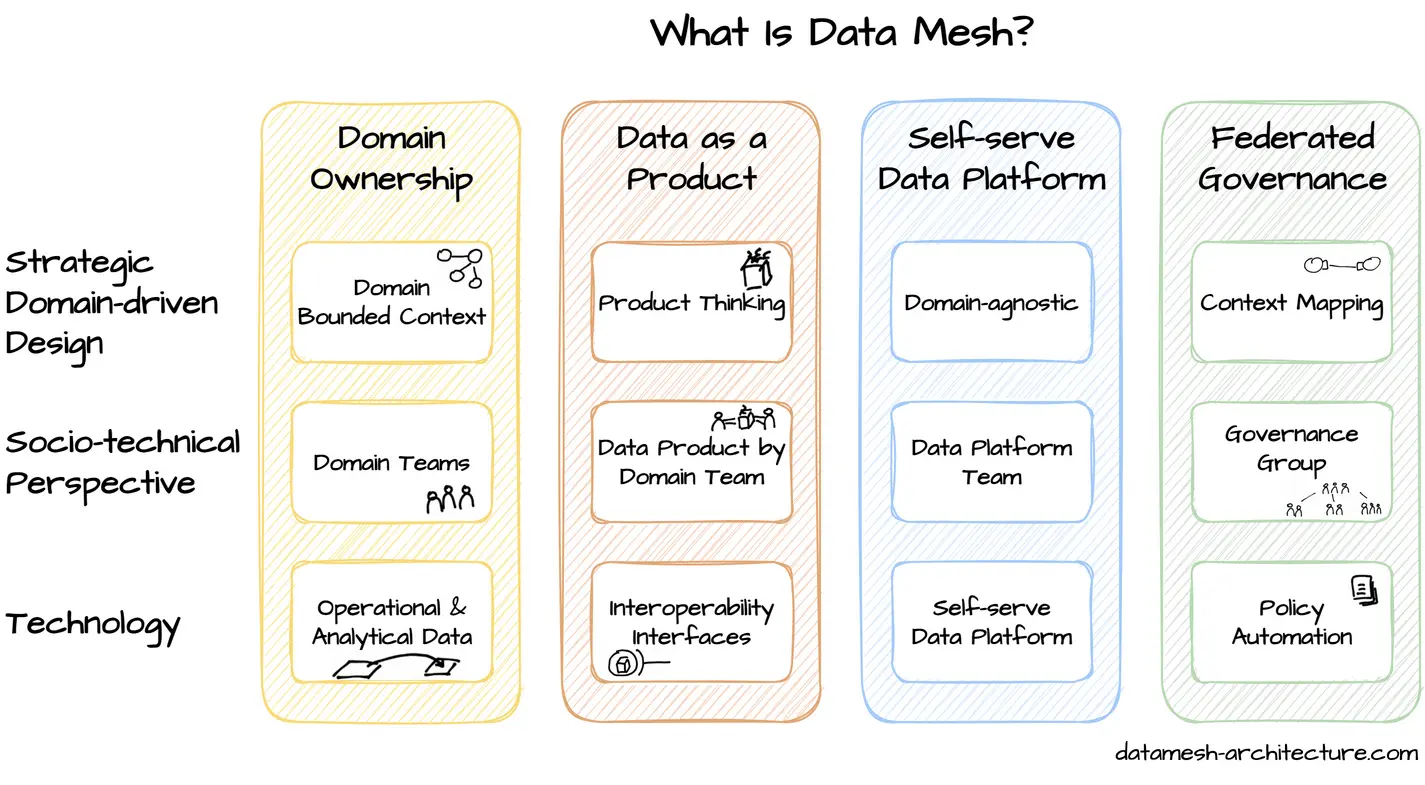
Разложение данных по доменам
Вместо создания монолитной аналитической модели архитектура Data Mesh требует использовать несколько аналитических моделей и согласовывать их с источником данных. Это естественным образом выравнивает границы владения аналитическими моделями с границами ограниченных контекстов (Bounded Context). А генерация аналитических данных становится ответственностью доменных команд.
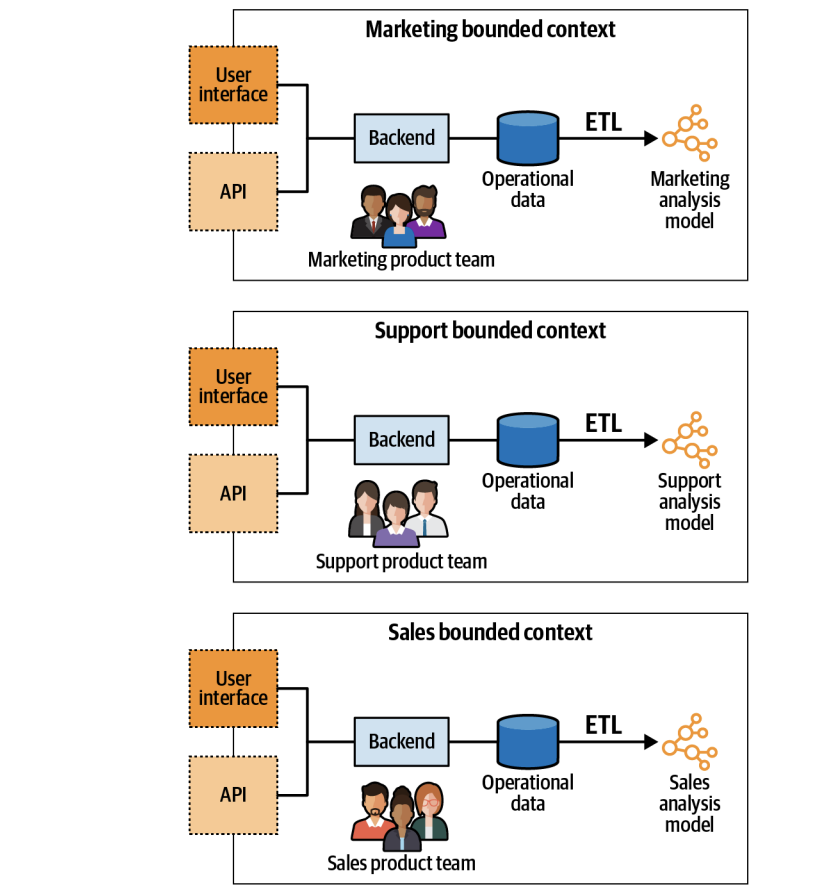
Данные как продукт
Принцип «данные как продукт» требует относиться к аналитическим данным как к части продукта (продуктовой команды). Вместо того чтобы аналитические системы получали рабочие данные из сомнительных источников (внутренняя база данных, файлы журналов и т. д.), в системе на основе Data Mesh ограниченные контексты обслуживают аналитические данные через четко определенные выходные порты. Аналитические данные должны рассматриваться так же как и любой публичный API: формироваться контракты с учетом запросов потребителей, использоваться независимый формат данных, поддерживаться обратная совместимость и т.д. При этом доменные события являются отличным кандидатом для подобного аналитического API, который может выглядеть как поток данных полезных как для аналитики, так и соседних доменов.
Платформа данных
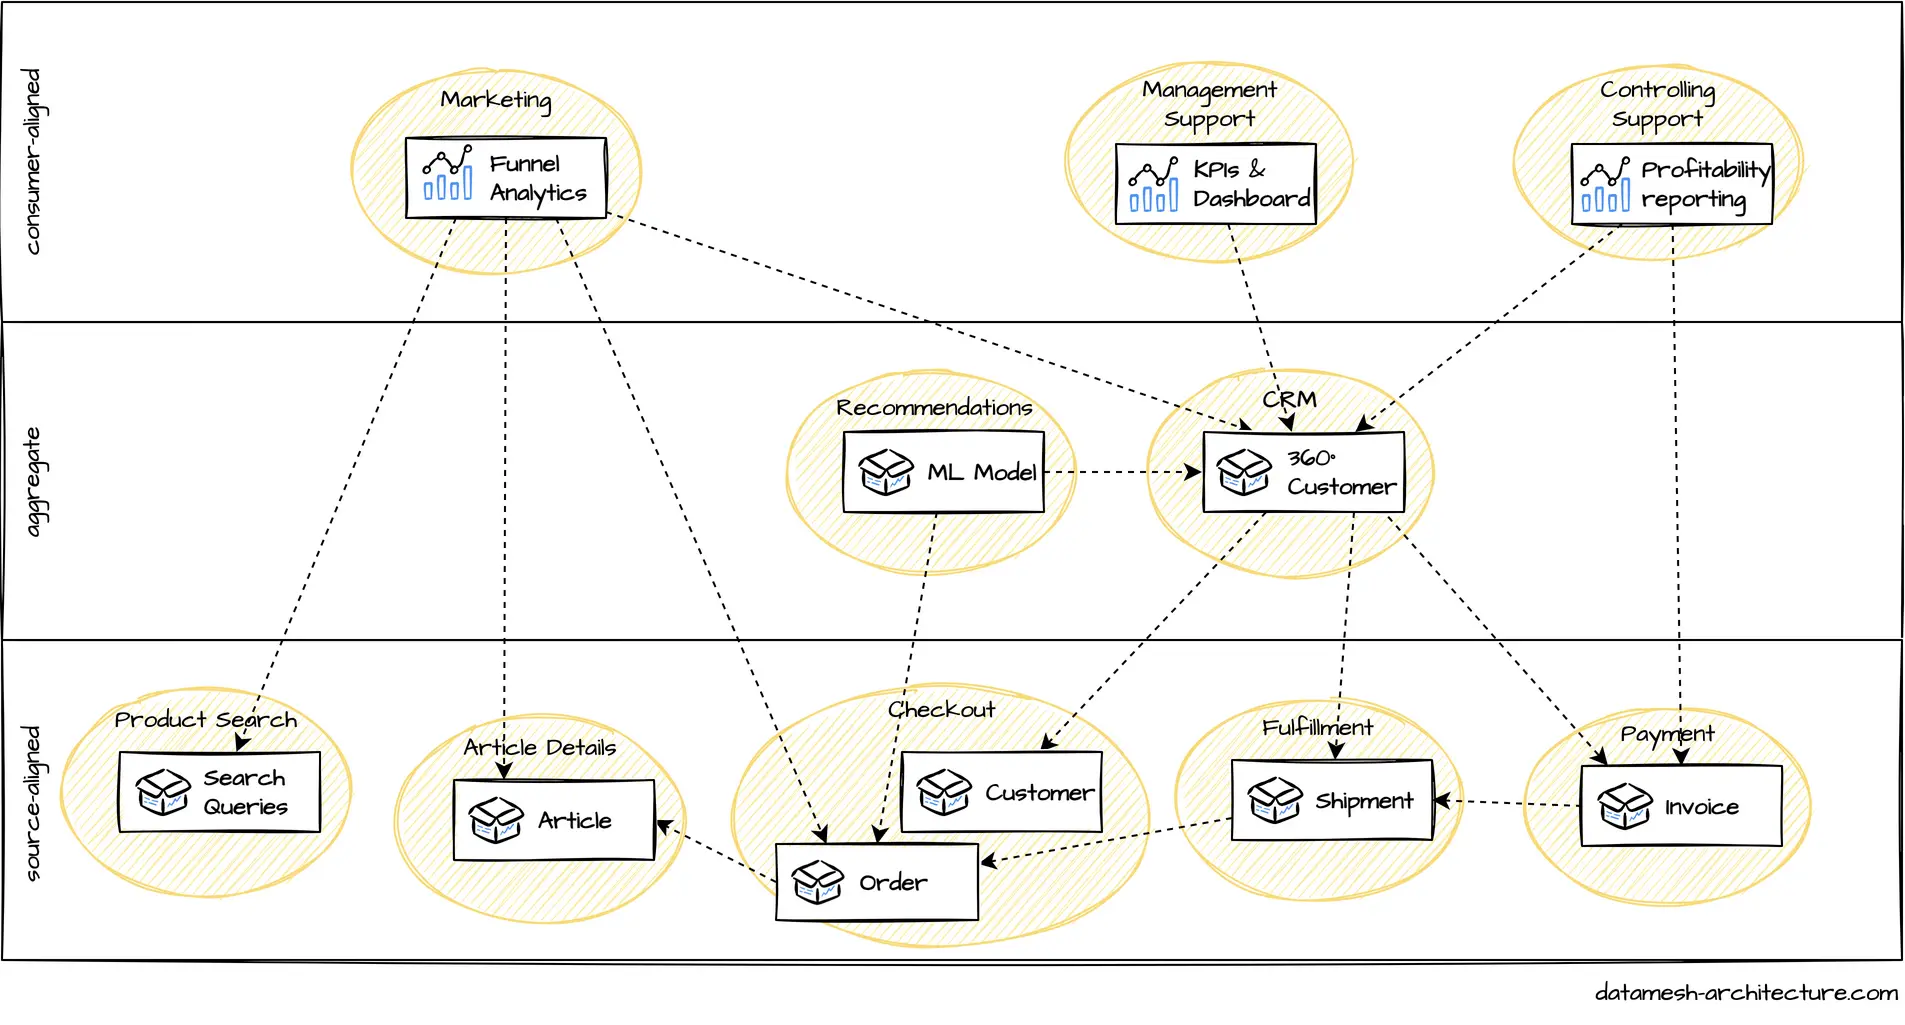
Команды разработчиков должны иметь возможность как создавать свои собственные продукты данных, так и использовать продукты данных, обслуживаемые другими ограниченными контекстами. Как и в случае с ограниченными контекстами, продукты данных должны быть совместимы.
Фактически появляется возможность подписываться на стрим данных от соседнего домена, обогащать его своими данными и сформировать новый аналитический стрим достаточный для конечной задачи, например в виде определенного отчета.
Mesh появляется именно из этого принципа. Домены так же как и микросервисы интегрируются на уровне аналитических данных через зафиксированные контракты. И формируют сеть.
Единственный способ для команд автономно владеть своими продуктами данных — это иметь доступ к высокоуровневой абстракции инфраструктуры, которая устраняет сложность при предоставлении и управлении жизненным циклом данных. Это требует построения целой платформы.
Платформу для данных можно рассматривать, как расширение платформы доставки, уже существующей для запуска и мониторинга сервисов. Однако технологический стек для работы с продуктами данных сегодня выглядит совершенно иначе, чем платформа доставки сервисов. Это связано с расхождением технологических стеков больших данных и операционных платформ. Например, доменные команды могут развертывать свои сервисы в виде контейнеров Docker в k8s. Но для аналитических данных единицей деплоя будет pipeline, например, в виде Spark джоб в Databricks кластере.
Федеративный орган управления
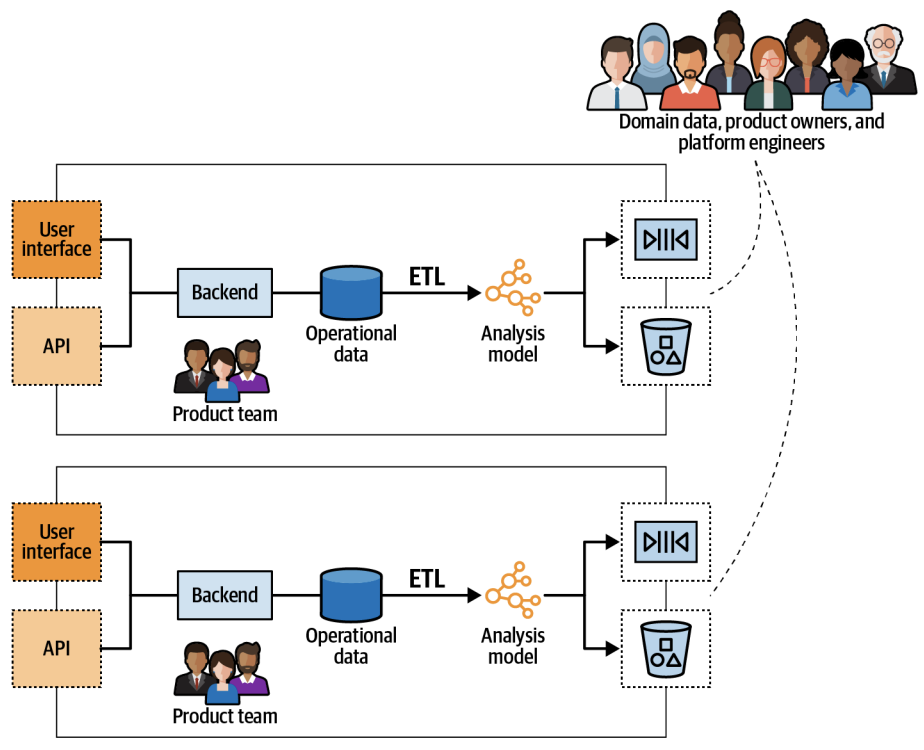
Последним шагом к созданию системы Data Mesh является назначение федеративного органа управления для обеспечения функциональной совместимости и экосистемного мышления в области аналитических данных. Как правило, это группа, состоящая из владельцев данных и продуктов ограниченных контекстов, а также представителей команды платформы инфраструктуры данных. Ответственность этой группы сформулировать правила для обеспечения здоровой и совместимой экосистемы и поддерживать их соблюдение.
Trade-Offs
| Преимущества | Недостатки |
|---|---|
| Разделение схемы данных позволило операционным подразделениям эволюционировать свою схему | Уровень зрелости компании/команд должен быть высоким |
| Появилась возможность работать с разными аналитическими моделями в зависимости от сценария | Требуется согласование контрактов |
| Зона ответственности за данные остается в продуктовой команде, что улучшает качество данных |
Обсуждение
Суммарно на основе обозначенных принципов архитектура Data Mesh может выглядеть следующим образом:
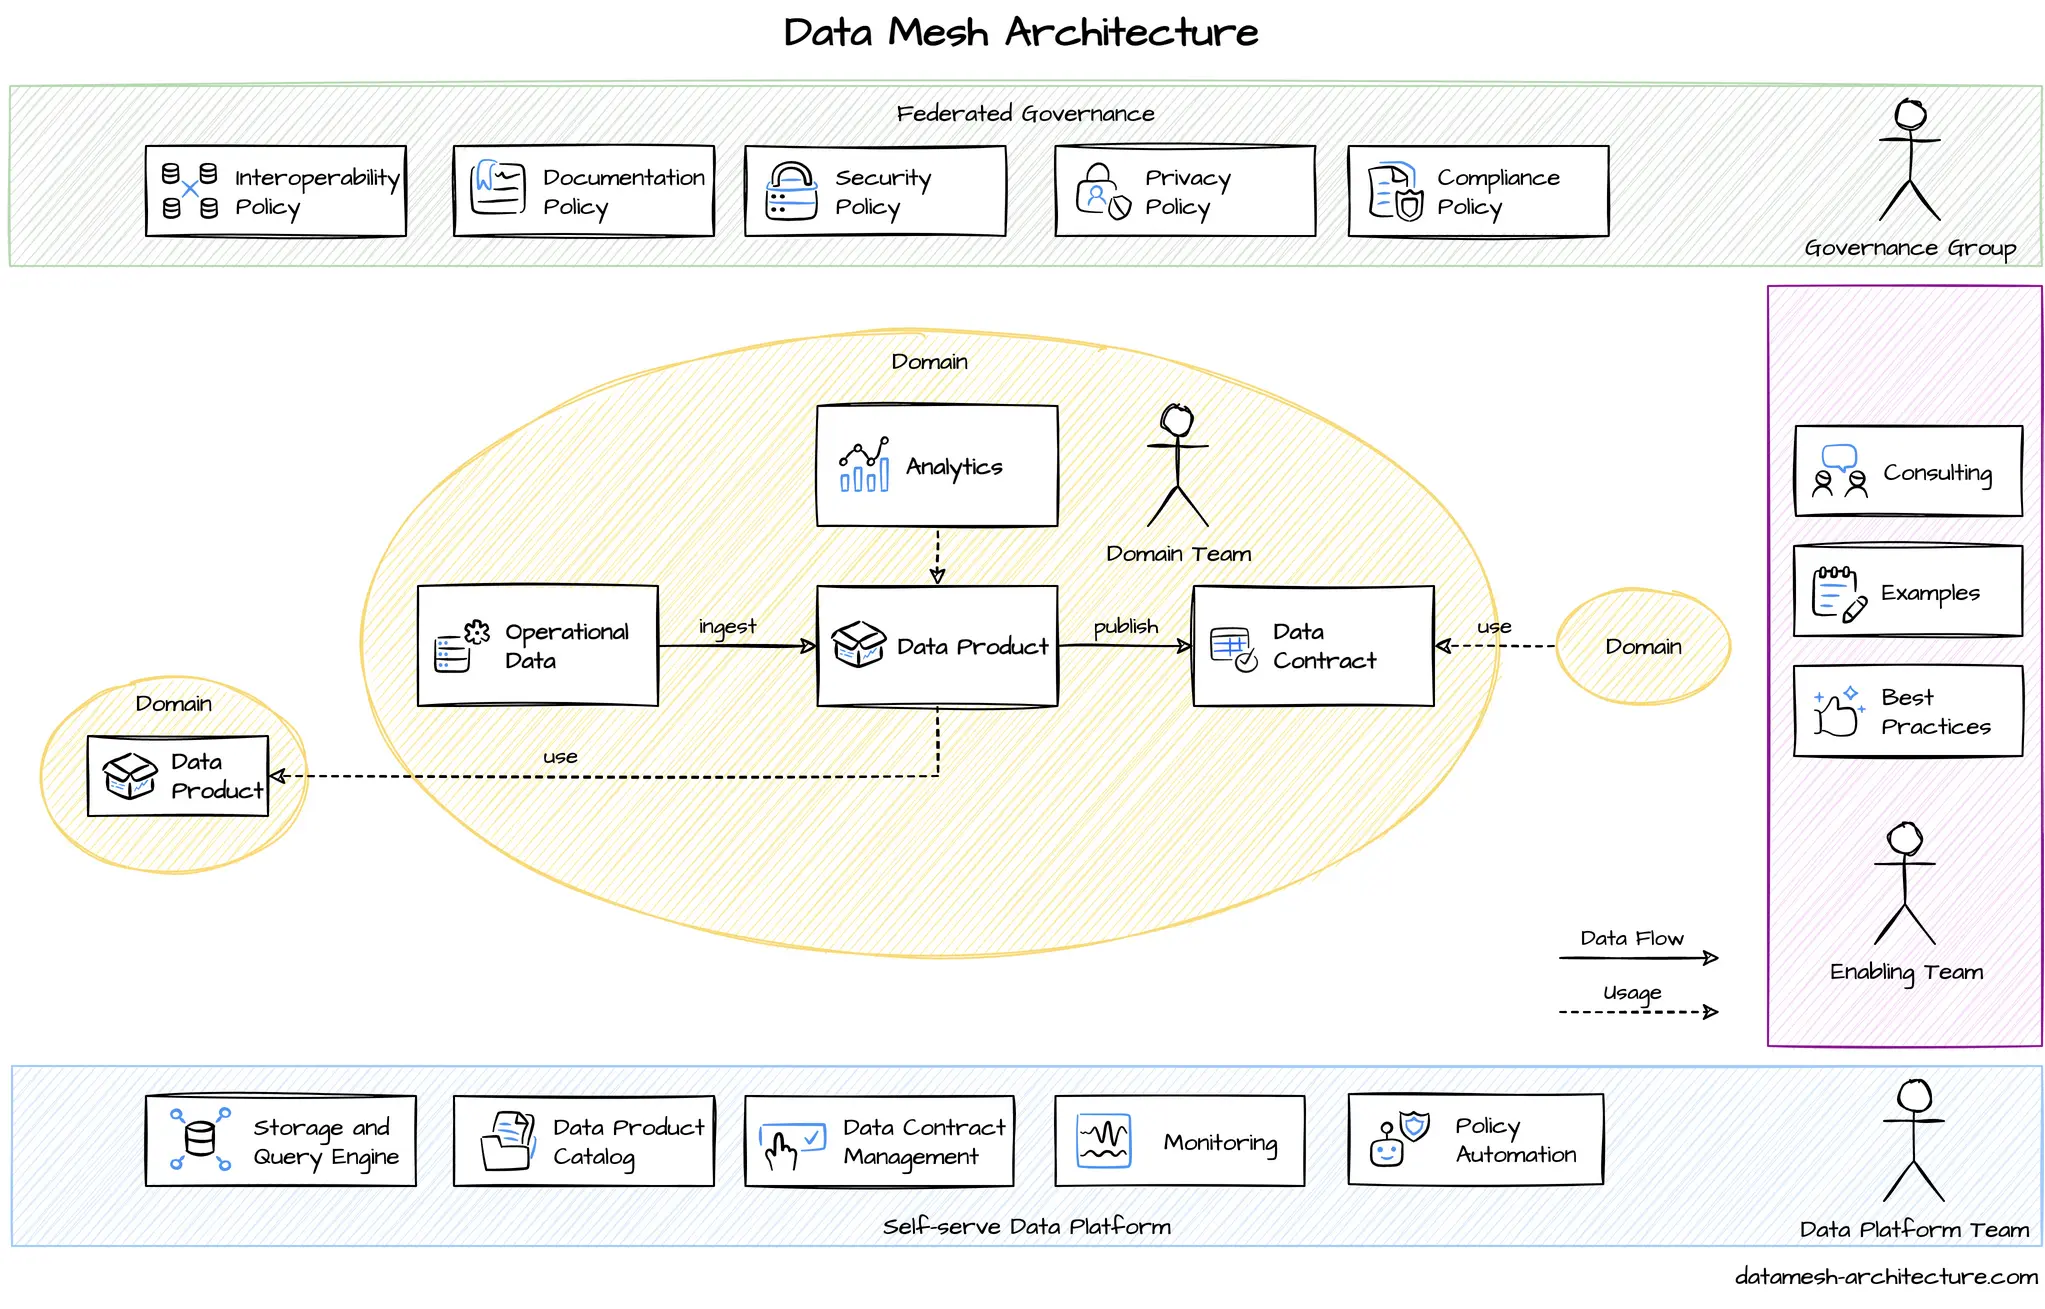
Основной недостаток Data Warehouse и Data Lake подходов, на которую обращает внимание автор Data Mesh: во время построения аналитических систем нарушаются границы ограниченных контекстов сформулированных в операционных/доменных сервисах. Знание о доменах сначала теряется при передаче данных в хранилища, а потом его восстанавливают во время аналитической работы. Data Mesh за счет достаточно крупных организационных изменений и смены "привычных" парадигм работы с аналитикой пытается сохранить границы ограниченных контекстов целыми.
Data Mesh в Tinkoff
Готовой платформы на текущий момент нет, но есть отдельные компоненты, которые частично реализуют описанные принципы. Также не сделаны все необходимые орг изменения.
Например, есть SDP. Это проект, который дает возможность описать стрим данных в виде avro схем. Фактически это реализация принципа "Данные как продукт". Кроме того через ревью схем насаждаются определенные правила ("Федеративный орган управления"). Но при этом на текущий момент данный инструмент воспринимается, как возможность залить данные в DWH. Интеграции по SDP между командами редкий сценарий.
Активно развивается платформа вокруг доступа к данным: Data Detective, Helicopter и другие инструменты. Но парадигмы с использованием DWH подходов сохраняются в командах. Потребуются немалые усилия, чтобы изменить эти парадигмы и перенести ответственность за аналитические данные в доменные команды.
Ссылки
- Dehghani, Zhamak. Data Mesh: Delivering Data-Driven Value at Scale. First edition. O’Reilly, 2022.
- Dehghani, Zhamak. “Data Mesh Principles and Logical Architecture”
- Dehghani, Zhamak. “How to Move Beyond a Monolithic Data Lake to a Distributed Data Mesh”
- Data Mesh Architecture