Архитектура распределения нагрузки
Существует множество поводов для распределения нагрузки по нескольким машинам:
- Масштабируемость. Если объем данных, нагрузка по чтению или записи перерастают возможности одной машины, то можно распределить эту нагрузку на несколько компьютеров.
- Отказоустойчивость/высокая доступность. Если приложение должно продолжать работать даже в случае сбоя одной из машин (или нескольких машин, или сети, или даже всего ЦОДа), то можно использовать избыточные компьютеры. При отказе одного из них выполнение задач делегируется другому.
Задержка. При наличии пользователей по всему миру необходимы серверы в разных точках земного шара, чтобы каждый пользователь обслуживался ЦОДом, географически расположенным максимально близко от него. При этом пользователям не нужно будет ждать, пока сетевые пакеты обойдут половину земного шара.
Принято считать, что существует три архитектуры распределения нагрузки: shared-memory architecture, shared-disk architecture, shared-nothing architectures. Ниже подробнее разберем каждую из аритектур.
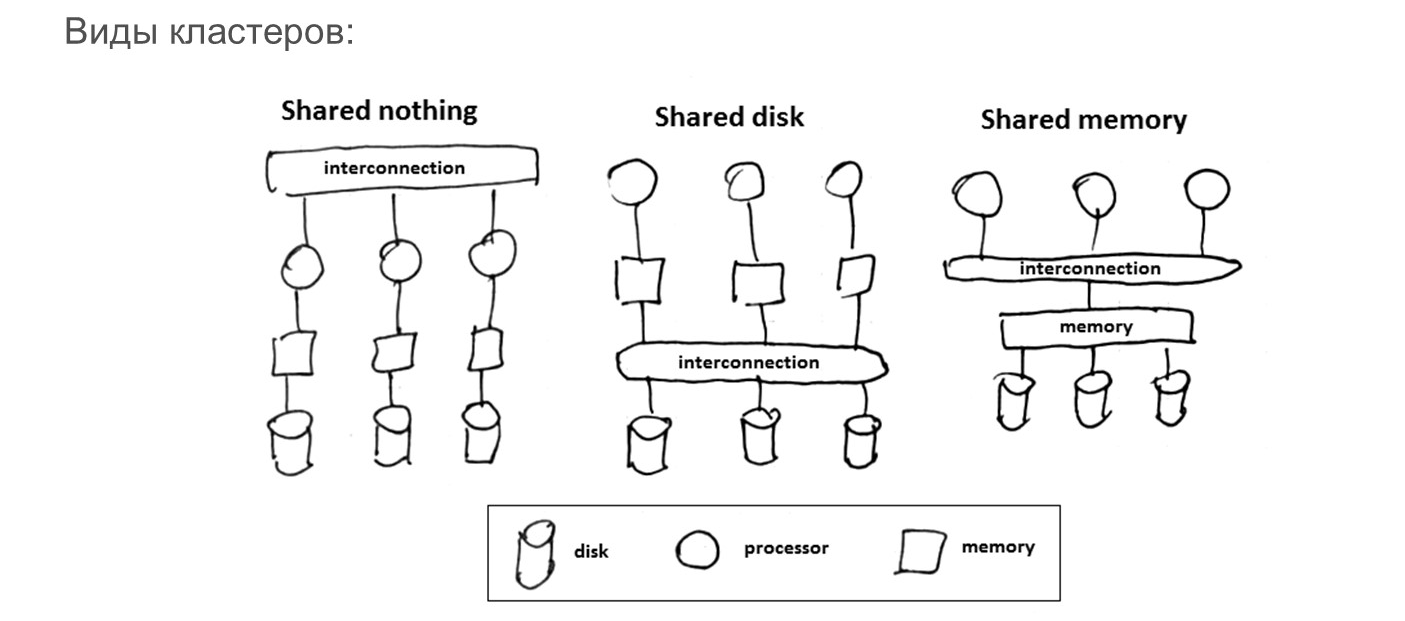
shared-memory architecture
Если вам всего лишь нужно масштабировать свою систему в расчете на более высокую нагрузку, то простейший способ — купить более мощную машину (обычно это называют вертикальным масштабированием). Можно объединить много процессоров, чипов памяти и жестких дисков под управлением одной операционной системы, а быстрые соединения между ними позволят любому из процессоров обращаться к любой части памяти или диска.
Trade-Offs
| Преимущества | Недостатки |
|---|---|
| До определенной нагрузки и обьемов данных такой подход может давать максимальное преимущество | стоимость растет быстрее, чем линейно: машина с вдвое большим количеством CPU, вдвое большим количеством памяти и двойным объемом дисков стоит отнюдь не вдвое дороже. Кроме того, вследствие узких мест вдвое более мощная машина не обязательно сможет справиться с двойной нагрузкой. |
Архитектура с разделяемой памятью обеспечивает ограниченную отказоустойчивость — в высокопроизводительных машинах есть возможность горячей замены компонентов (дисков, модулей памяти и даже CPU без отключения машины), — но она строго ограничена одной географической точкой. | |
shared-disk architecture
При таком подходе применяется несколько машин с отдельными CPU и оперативной памятью, но данные хранятся в массиве дисков, совместно используемых всеми машинами, подключенными с помощью быстродействующей сети.
Trade-offs
| Преимущества | Недостатки |
|---|---|
| Имеет преимущесво по сравнению с shared-memory architecture в масштабируемости и отказоустойчивости | Узким местом в таком подходе будет ограниченная масштабируемость шариного диска. |
shared-nothing architectures
При этом подходе каждый компьютер или виртуальная машина, на которой работает распределенная система, называется узлом (node). Все узлы используют свои CPU, память и диски независимо друг от друга. Согласование узлов выполняется на уровне программного обеспечения с помощью обычной сети. Такой подход принято называть горизонтальным масштабированием.
Trade-Offs
| Преимущества | Недостатки |
|---|---|
| Для таких систем не требуется какое-то специальное аппаратное обеспечение. Тем самым можно использовать оборудование имеющее оптимальные цена и производительность. | Такие архитектуры, как правило, сильно усложняют разработку |
| Shared-nothing архитектура позволяет, при необходимости, распределить данные по множеству географических регионов и таким образом снизить задержку для пользователей и потенциально сделать систему устойчивой к потере целого ЦОДа. | Ограничивают выразительность используемых моделей данных. В распределенных данных пропогандируется "модель на оборот". Модели строятся не от логического представления данных, а от запросов в систему. |
| Производительность таких систем гораздо выше конкурентов (но только на простые запросы) | В большинстве случаев обычная одноузловая система может показывать производительность выше чем распределенная |
Существует два распространенных способа распределения данных по нескольким узлам: репликация, партиционирование. В следующих разделах мы более подробно рассмотрим каждый из способов.