Data Lake
Data Lake пытается закрыть часть проблем DWH. В частности общей модели.
Топология
Data Lake старается решить проблему общий схемы предприятия сохраняя данные в неструктурированном виде (в формате изначального операционного хранилища) в так называемом озере (Lake). Трансформация данных выполняется фактически по необходимости. Когда аналитикам данных потребуется работать с сырыми данными, они будут отправлены в DWH по средством ETL из lake. Таким образом разные аналитики данных могут использовать нужную только им модель.
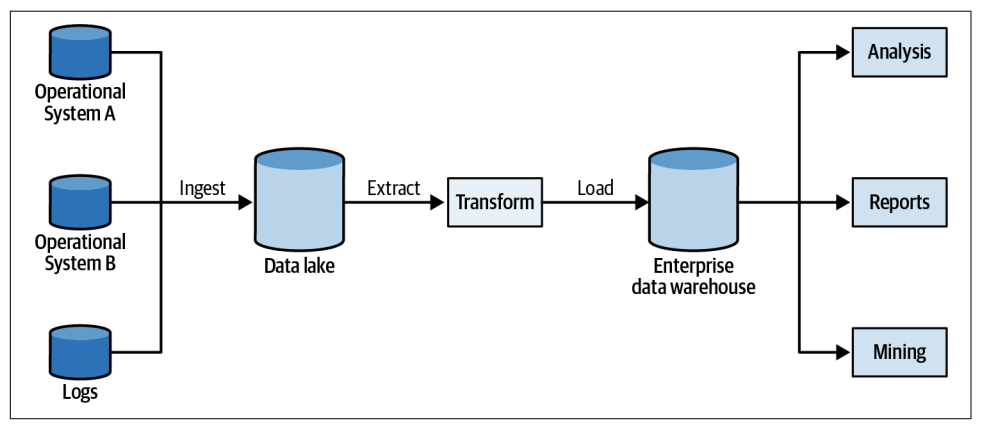
Основные характеристики Data Lake решения:
- Данные загружаются из множества источников
- Данные загружаются в lake - хранилище неструктурированных данных
- Пользователи: data scientists. Ищут данные в lake и выполняют любые агрегации, композиции и другие преобразования, необходимые для ответа на конкретные вопросы.
Trade-Offs
| Преимущества | Недостатки |
|---|---|
| Разделение схемы данных позволило операционным подразделениям эволюционировать свою схему | С неструктурированными данными становится сложно работать. Уже никто не гарантирует целостности модели. Операционная модель эволюционирует, а аналитическая становится помойкой данных |
| Появилась возможность работать с разными аналитическими моделями в зависимости от сценария | Сильно усложнилась работа аналитиков данных и самой системы |
| Преобразование из сырых данный в нужную модель занимает много времени | |
| Зона ответственности размазывается, что приводит к плохому качеству данных. Специалисты больших данных это технические специалисты с предметной областью они не знакомы | |
| Возникает множественное копирование данных в разных представлениях: Операционное, Lake, DWH. |
Обсуждение
Data Lake, по сути, является обратной стороной DWH. Сохраняя централизованную модель и конвейеры, он инвертирует модель хранилища данных "преобразование и загрузка" в модель "загрузка и преобразование".
По сравнению с DWH, Data Lake является schema-less решением. Контроль схемы ложится на аналитиков, которые преобразуют данные в удобный для текущей задачи формат. Но в результате проблема совместимости с операционными данными просто немного откладывается. А также порождает хаос в неструктурированных данных внутри Lake и в многочисленных трансформациях. Преобразование операционных моделей в аналитические сводится к тысячам необслуживаемых, специальных сценариев ETL в масштабе.
Ссылки
- Fowler, Martin. “Data Lake”
- The Curse of the Data Lake Monster
Оптимизации Data Lake
Отдельно выделяют поколение платформ направленных на оптимизацию Data Lake решений. Они добавляют:
- потоковую передачу данных в режиме реального времени с помощью таких архитектур, как Kappa
- объединение пакетной и потоковой обработки для преобразования данных с помощью таких фреймворков, как Apache Beam
- внедрение облачных управляемых сервисов для хранения, механизмов выполнения конвейеров данных и платформ машинного обучения
Примером подобного решения может быть Lakehouse система, например Delta Lake. В данном курсе не углубляемся в детали подобных систем и приводим как промежуточный шаг в развитии BigData архитектур.
Ссылки
- Armbrust, Michael, Ali Ghodsi, Reynold Xin, and Matei Zaharia. “Lakehouse: A New Generation of Open Platforms That Unify Data Warehousing and Advanced Analytics” 2021.
- Dehghani, Zhamak. “How to Move Beyond a Monolithic Data Lake to a Distributed Data Mesh”