CQRS pattern
Проблема
В традиционных архитектурах одна и та же модель данных используется для запроса и обновления базы данных. Это просто и хорошо работает для основных операций CRUD. Однако в более сложных приложениях этот подход может стать громоздким. Например, на стороне чтения приложение может выполнять множество различных запросов, возвращая объекты передачи данных (DTO) с различными формами. Отображение объектов может стать сложным. На стороне записи модель может реализовывать сложную проверку и бизнес-логику. В результате вы можете получить слишком сложную модель, которая делает слишком много.
Решение
CQRS разделяет операции чтения и записи на разные модели, используя команды для обновления данных и запросы для чтения данных.
- Команды должны быть основаны на задачах, а не на данных. («Забронировать номер в гостинице», а не «установить для ReservationStatus значение «Зарезервировано»).
- Команды могут быть помещены в очередь для асинхронной обработки , а не для синхронной обработки.
- Запросы никогда не изменяют базу данных. Запрос возвращает DTO, который не инкапсулирует какие-либо знания предметной области.
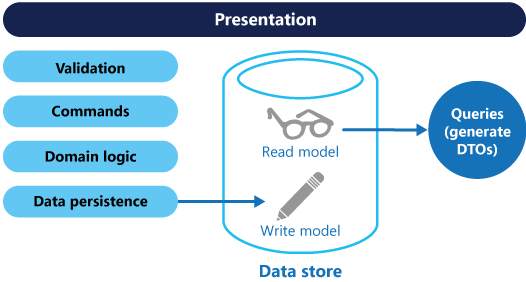
Наличие отдельных моделей запросов и обновлений упрощает проектирование и реализацию. Однако одним из недостатков является то, что код CQRS не может быть автоматически создан из схемы базы данных с помощью механизмов автоматической генерации, таких как средства ORM.
Для дополнительной изоляции можно физически разделить данные для чтения и данные для записи. В этом случае в базе данных для чтения можно оптимизировать схему данных так, чтобы максимально эффективно выполнять запросы.
Если используются отдельные базы данных чтения и записи, они должны храниться в синхронизации. Обычно это достигается путем публикации события модели записи при каждом обновлении базы данных.
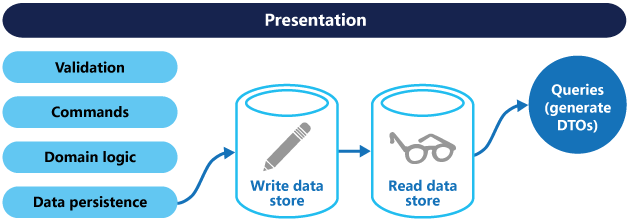
В качестве хранилища для чтения можно использовать реплику хранилища для записи с доступом на чтение. Более того, это могут быть хранилища с совершенно разными структурами данных. Использование нескольких реплика только для чтения может повысить производительность запросов, особенно в распределенных сценариях, где реплика только для чтения находятся рядом с экземплярами приложения.
Разделение хранилищ для чтения и записи позволяет правильно масштабировать каждое из них в соответствии с нагрузкой. Традиционно нагрузка на хранилища для чтения намного выше, чем на хранилища для записи.