Clean
Описание
Подробнее всего чистая архитектура описана в книге Роберта Мартина «Clean Architecture» Сама архитектура расписана размыто, в ней мало конкретики и нет примера реализации, есть только набор принципов. Но несмотря на это можно выделить ряд основных моментов:
- В основе чистой архитектуры лежит бизнес логика (правила).
- Бизнес-правила должны оставаться в неприкосновенности, незапятнанными низкоуровневыми аспектами, такими как пользовательский интерфейс или база данных.
- В идеале код, представляющий бизнес-правила, должен быть сердцем системы, а другие задачи — просто подключаться к ним.
- Реализация бизнес-правил должна быть самым независимым кодом в системе, готовым к многократному использованию. Она не должна зависеть ни от каких фреймворков или библиотек. Достигается это за счет выделения бизнес правил в отдельный слой, а работа с ней посредством одного из принципа SOLID - Dipendency Inversion Principle (DIP)
Чистая архитектура способствует созданию систем:
- Независимость от фреймворков
- Простота тестирования
- Независимость от пользовательского интерфейса
- Независимость от базы данных
- Независимость от любых внешних агентов
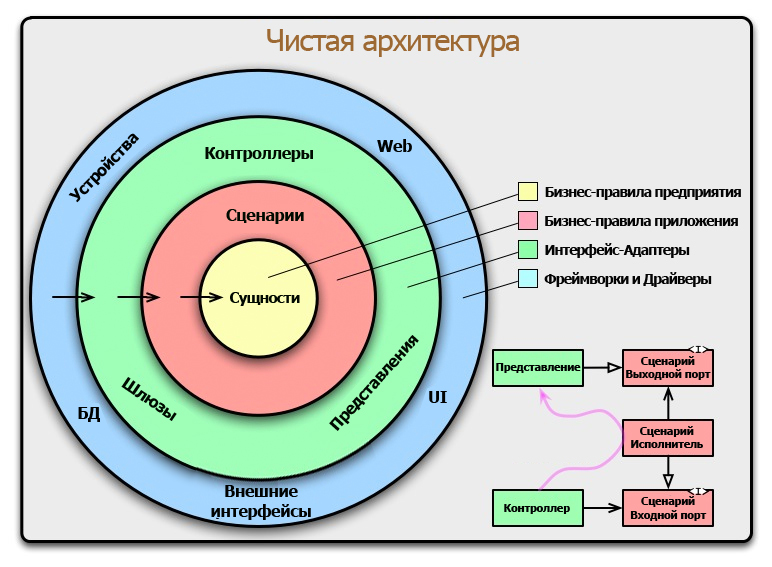
Автор выделяет следующий набор слоев:
- Entity (сущности). Включают в себя критические бизнес правила уровня предприятия. Здесь описывает то, вокруг чего строится бизнес логика.
- Use cases. Тут описываются бизнес-правила описывающие поведение системы.
- Controllers (Адаптеры интерфейсов). Связывают внешние запросы (например, от веб-интерфейса или API) с бизнес-логикой приложения. Преобразует низко-уровневые данные в более высокоуровневым, например в entity и наоборот.
- Фреймворки и драйверы. Связующее звено внешнего мира с вашим приложением. Тут находятся веб-фреймворки, базы данных и т.д.
На практике еще можно добавить слой InfraStucture, domain services для анемичных моделей, Handlers в Use Case .
В свою очередь InfraStucture может делиться на отдельный компонент для интерфейса и реализации каждого адаптера типа базы, брокера, стороннего сервиса и т.д. первичные адаптеры тоже могут делиться на http-контроллеры, консюмеры, grpc-сервисы и бэкграунд-джобы.
Слоев может быть и больше, главное чтобы соблюдалось правило зависимостей.
Внешний круг должен зависеть только от внутренних.
Схематично это можно отобразить на картинке:
Реализация этого достигается посредством DIP.
Dipendency Inversion Principle (DIP)
Основной принцип используемый в чистой архитектуре.
Формулировка на русском языке:
- A. Модули верхних уровней не должны зависеть от модулей нижних уровней. Оба типа модулей должны зависеть от абстракций.
- B. Абстракции не должны зависеть от деталей. Детали должны зависеть от абстракций.
Суть принципа в том, что весь код разделяется на N слоев, аналогично Layered Architecture, но модули верхних уровней не могут зависеть от нижних напрямую.
Если модулям верхних уровней нужен нижний, то они его получают через абстракцию, при этом данная абстракция должна находиться в их слое.
При ситуации наоборот, нижним нужен верхний, то они могут его импортировать напрямую.
Рассмотрим пример:
Допустим у нас будет два слоя - core, data access.
Если core нужна зависимость от data access, то:
1) В core создаем абстракцию
2) Данная абстракция не должна зависеть от data access, только от core в идеале также не зависеть от фреймворка.
3) Импортируем и реализуем данную абстракцию в data access
4) Передаем в core инстанс data access с реализацией данной абстракции используя инъекцию зависимостей (Dependency injection, DI)
В обратном сценарии, когда data access нужно зависеть от core, то data access может импортировать core напрямую, без использования каких-либо абстракций.
Практика применения чистой архитектуры:
Слой Entities:
Сюда входят сервисы и anemic/reach models.
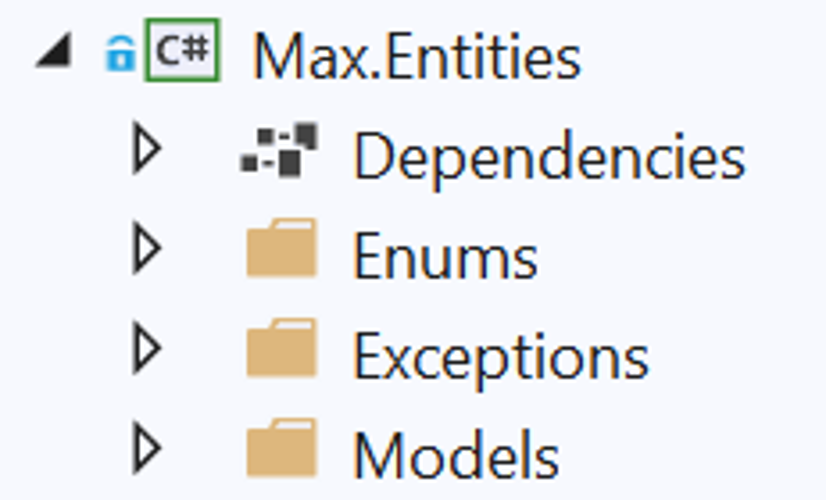
Пример структуры папок для Rich model:
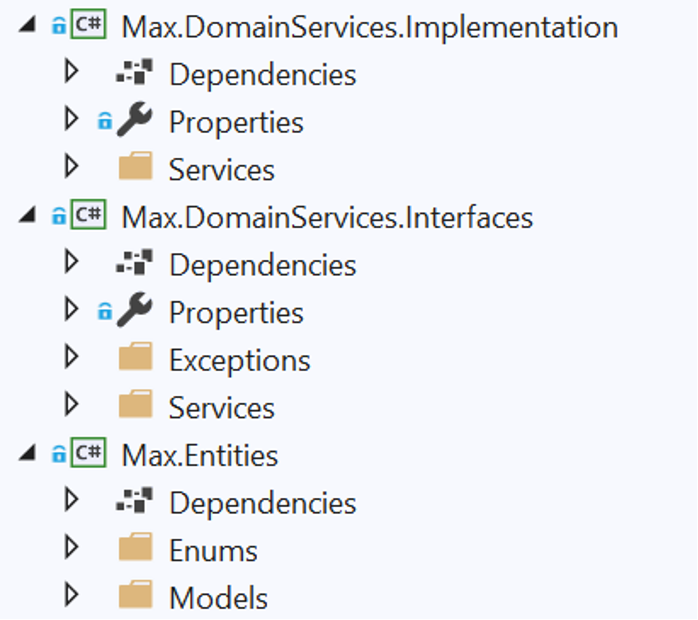
Пример структуры папок для Anemic model:
Добавляются интерфейсы domain services и их реализации
Слой Use Cases:
Рекомендуется на каждую роль выделять свой Use Case.
В слой входит:
- Логика приложения, не зависит от фреймворков (ORM, Web)
- Исключения (например, НельзяРассчитатьСтоимостьЗаказа)
- На каждую роль один Use Case
Слой Controllers:
- Зависят от фреймворков
- Контроллерам нельзя использовать инфрастуктуру напрямую, только через UseCase
В слой входит:
- HTTP, WebSocket, Grpc services
Слой Frameworks:
Сюда входят:
- База данных
- Тесты
- Внешние сервисы
- Фронтенд
- Веб-фреймворк
Слой Infrastucture:
Также можно добавить набор инструментов для работы с инфраструктурой.
Infrastucture нужно разделить на интерфейсы и реализации.
Интерфейсы кладем рядом с Use Case, т.к. явно он нигде не указан.
Что кладем в Infrastructure.Interfaces:
- Интерфейсы для доступа к данным
- Repository
- Интерфейсы для зависимостей веб-фреймворка
- Id, email и роли текущего пользователя
- Url генератор
- Интерфейсы для взаимодействия с внешними системами
- Отправка Email и Смс
- Сопутствующие DTO
Реализацию можно положить в слой Framework.
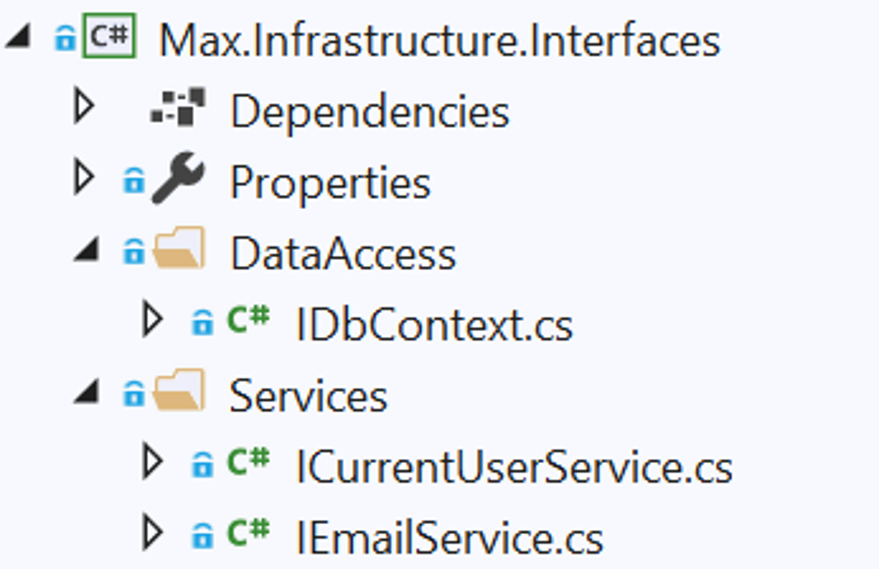
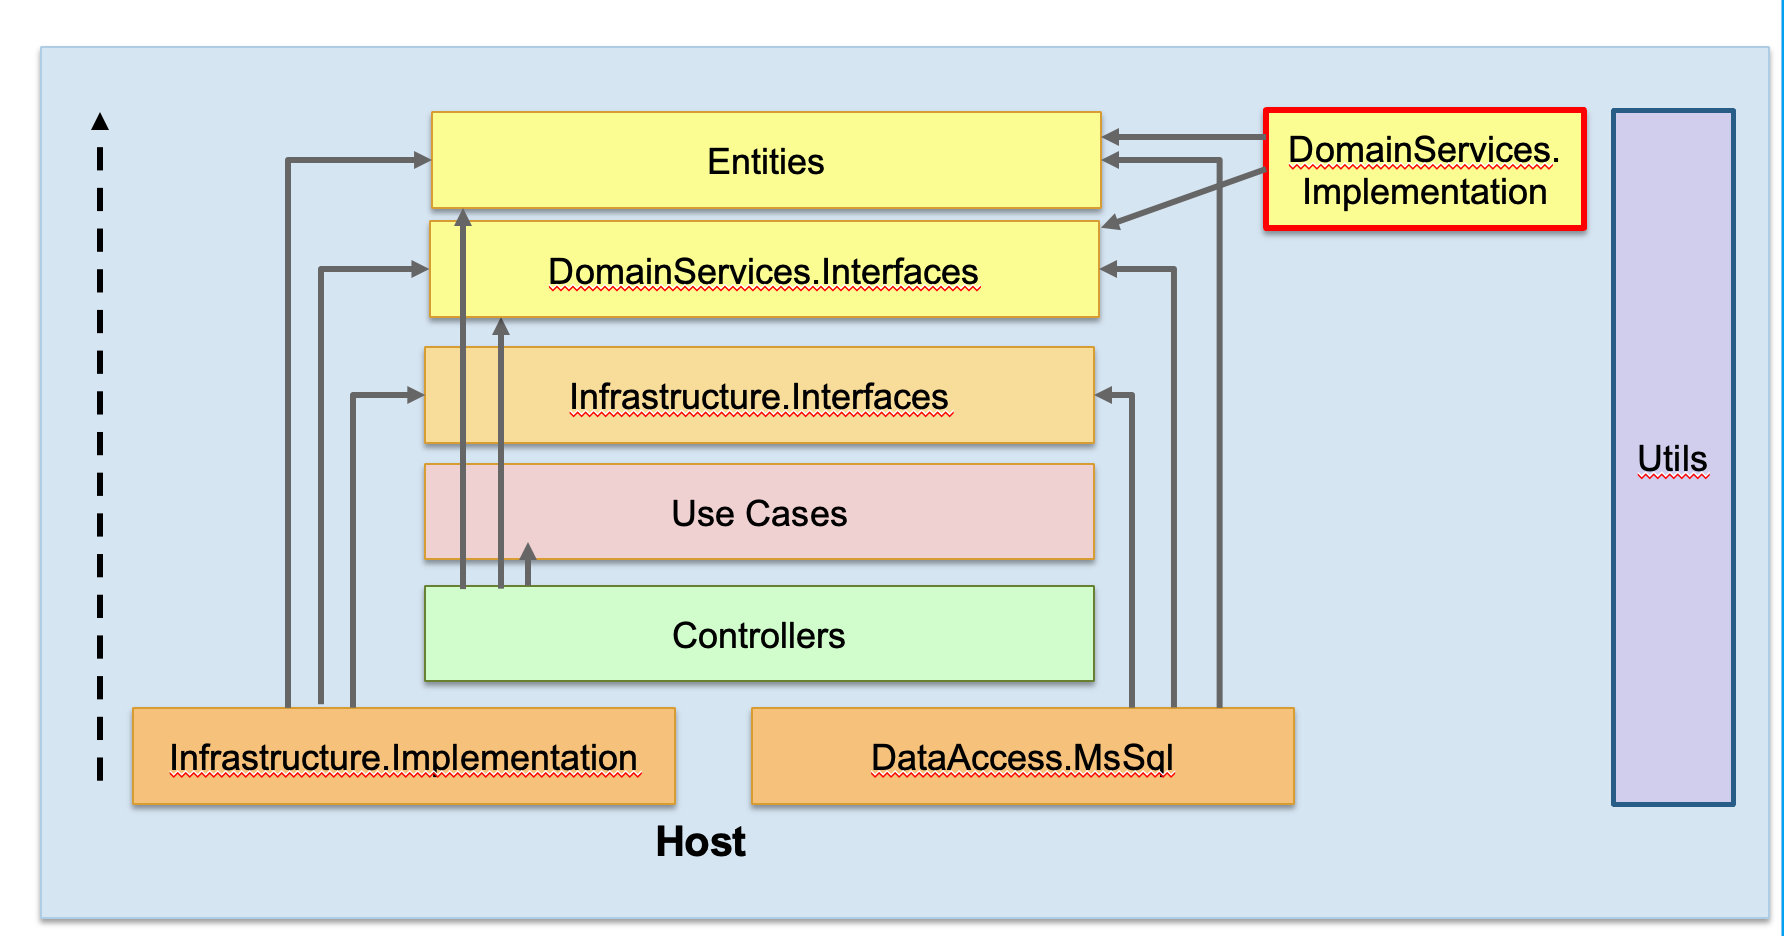
При этом порядок импортов интерфейсов инфраструктуры может быть между Entities и UseCases, а реализация самой последней.
Слой Utils:
Можно добавить слой утилит, к которому могут ссылаться все слои.
Главное чтобы в нем не было логики из других слоев.
В итоге порядок импортов слоев будет следующий:
Слой Tests:
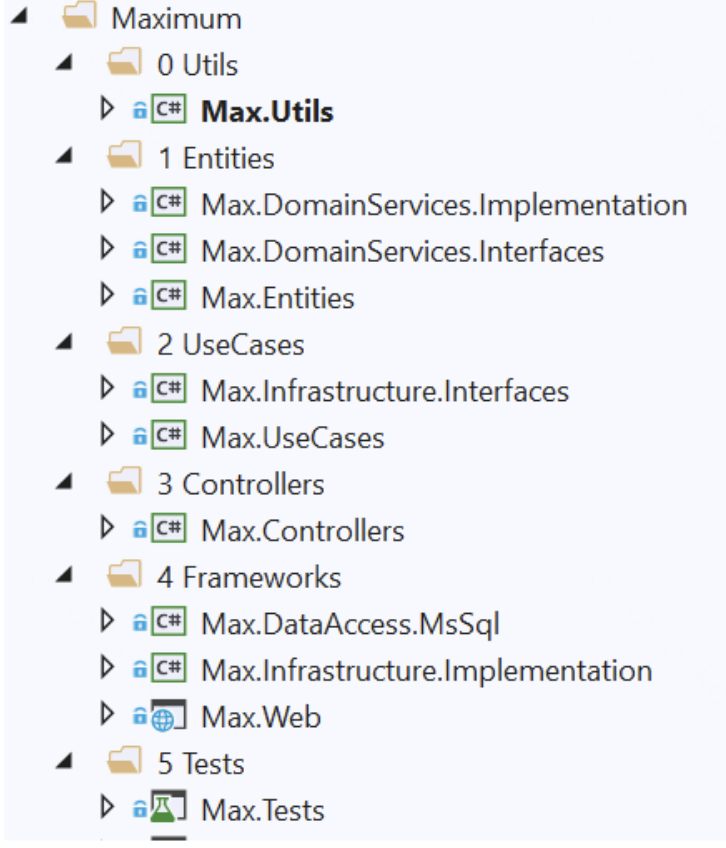
Тесты можно вынести в отдельный слой.
Резюмируя можно предложить такой пример реализации:
Реализация чистой архитектуры с поддержанием DIP и разбиением кода на слои помогает достичь следующих результатов:
- Независимость от фреймворка. Архитектура не зависит от существования какой-либо библиотеки. Это позволяет использовать фреймворк в качестве инструмента, вместо того, чтобы втискивать свою систему в рамки его ограничений.
- Тестируемость. Бизнес-правила могут быть протестированы без пользовательского интерфейса, базы данных, веб-сервера или любого другого внешнего компонента.
- Независимоcть от UI. Пользовательский интерфейс можно легко изменить, не изменяя остальную систему. Например, веб-интерфейс может быть заменен на консольный, без изменения бизнес-правил.
- Независимоcть от базы данных. Вы можете поменять Oracle или SQL Server на MongoDB, BigTable, CouchDB или что-то еще. Ваши бизнес-правила не связаны с базой данных.
- Независимость от какого-либо внешнего сервиса. По факту ваши бизнес правила просто ничего не знают о внешнем мире.
Trade-Offs (в сравнении с layered)
Преимущества | Недостатки |
|---|---|
Инфрастуктура не влияет на бизнес логику, в layered может. | Более высокий порог входа для разработчиков |
Компоненты взаимодействуют через абстракции (интерфейсы), что обеспечивает высокую гибкость. | Нужно писать больше кода (делать несколько шагов для передачи данных между слоями) |
Легче тестировать |
Когда использовать
В средних и больших проектах:
- если проект предполагает долгосрочное развитие;
- для систем с множеством взаимосвязанных компонентов, например монолитов;
- где нужно относительно легко вносить изменения, не боясь что что-то поломается, например если вы ожидаете, что технологии могут поменяться (например, смена базы данных, UI-фреймворка или API-интерфейса);
- в больших командах, где одни разработчики работают над бизнес-логикой, а другие над интерфейсами или инфраструктурой, такая архитектура упрощает разделение обязанностей;
- когда бизнес домен уже идентифицировался (границы бизнес домена/бизнес функциональности сформировались).
Описание
Хотя Layered архитектура дает множество преимуществ для разработки программного обеспечения, есть и некоторые потенциальные недостатки, которые следует учитывать. Реализация вертикальной бизнес-логики как правило затрагивает все слои, что плохо укладывается в принципы правильной модульности.
Vertical Slices архитектура направлена на организацию кода вокруг ограниченного контекста, а не на технические проблемы. В отличии от чистой архитектуры, для которой применяются закрытые и открытые слои со строгим разграничением ответственности, vertical slices архитектура по сути делает все горизонтальные слои открытыми. Из любого слоя мы можем вызвать любой слой без ограничения.
В vertical slices архитектуре бизнес функция реализуется на всех уровнях программного обеспечения, от пользовательского интерфейса до базы данных.
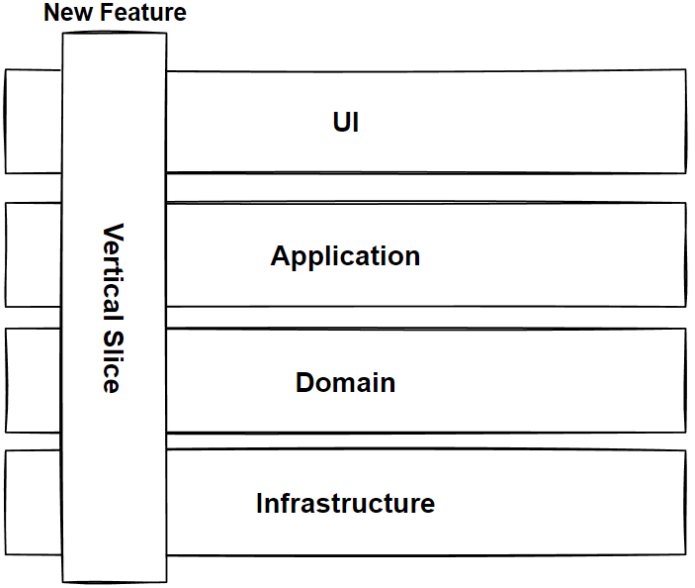
Идея vertical slices архитектуры заключается в том, что, вместо создания отдельных слоев кода для каждого технического проблем (таких как пользовательский интерфейс, доступ к данным и бизнес-логика), код организован вокруг конкретной бизнес функции. Это означает, что весь код, связанный с этой функцией, содержится в одном месте, что упрощает понимание, тестирование и изменение.
Trade-Offs
| Преимущества | Недостатки |
|---|---|
Благодаря архитектуре вертикального среза мы уменьшаем связь между функциями. Мы можем сосредоточиться на одном фрагменте при реализации функции, а не на разных уровнях, тем самым улучшая удобство обслуживания. | Архитектура вертикальных слоёв склонна к повышенной энтропии |
Каждый срез независим и взаимодействует с внешними ресурсами. Мы можем иметь разные срезы, используя разные способы сохранения данных, не мешая друг другу. |
Когда использовать
Архитектура вертикальных слоев хорошо подходит для случаев разделения монолита на ограниченные контексты. Эта архитектура может стать отличным стартом разработки. Энтропия внутри модулей, наверное, главная проблема вертикальной архитектуры.