Семейства баз данных
Семейство базы данных или модель данных — это фундаментальный аспект любой базы данных. Оно определяет, как данные будут логически
организованны, как они будут извлекаться и храниться. Различные базы данных поддерживают разные модели данных, и правильный выбор модели зависит от конкретных требований к приложению.
В этой обзорной главе я дам краткое введение в популярные модели баз данных и области их применения. Ниже обзор семейств которых мы коснемся:
- Sql
- relational database
- noSql
- Key-value database
- document-oriented database
- Graph database
- Column
- wide column/column family database
- column oriented/base column
- Text Search
- time series database
- Multi-model database
- newSql
- distributedSql
Sql/Relational DataBase
Реляционные базы данных – старейший тип до сих пор широко используемых баз данных общего назначения. Данные и связи между данными организованы с помощью таблиц. Каждый столбец в таблице имеет имя и тип. Каждая строка представляет отдельную запись или элемент данных в таблице, который содержит значения для каждого из столбцов.
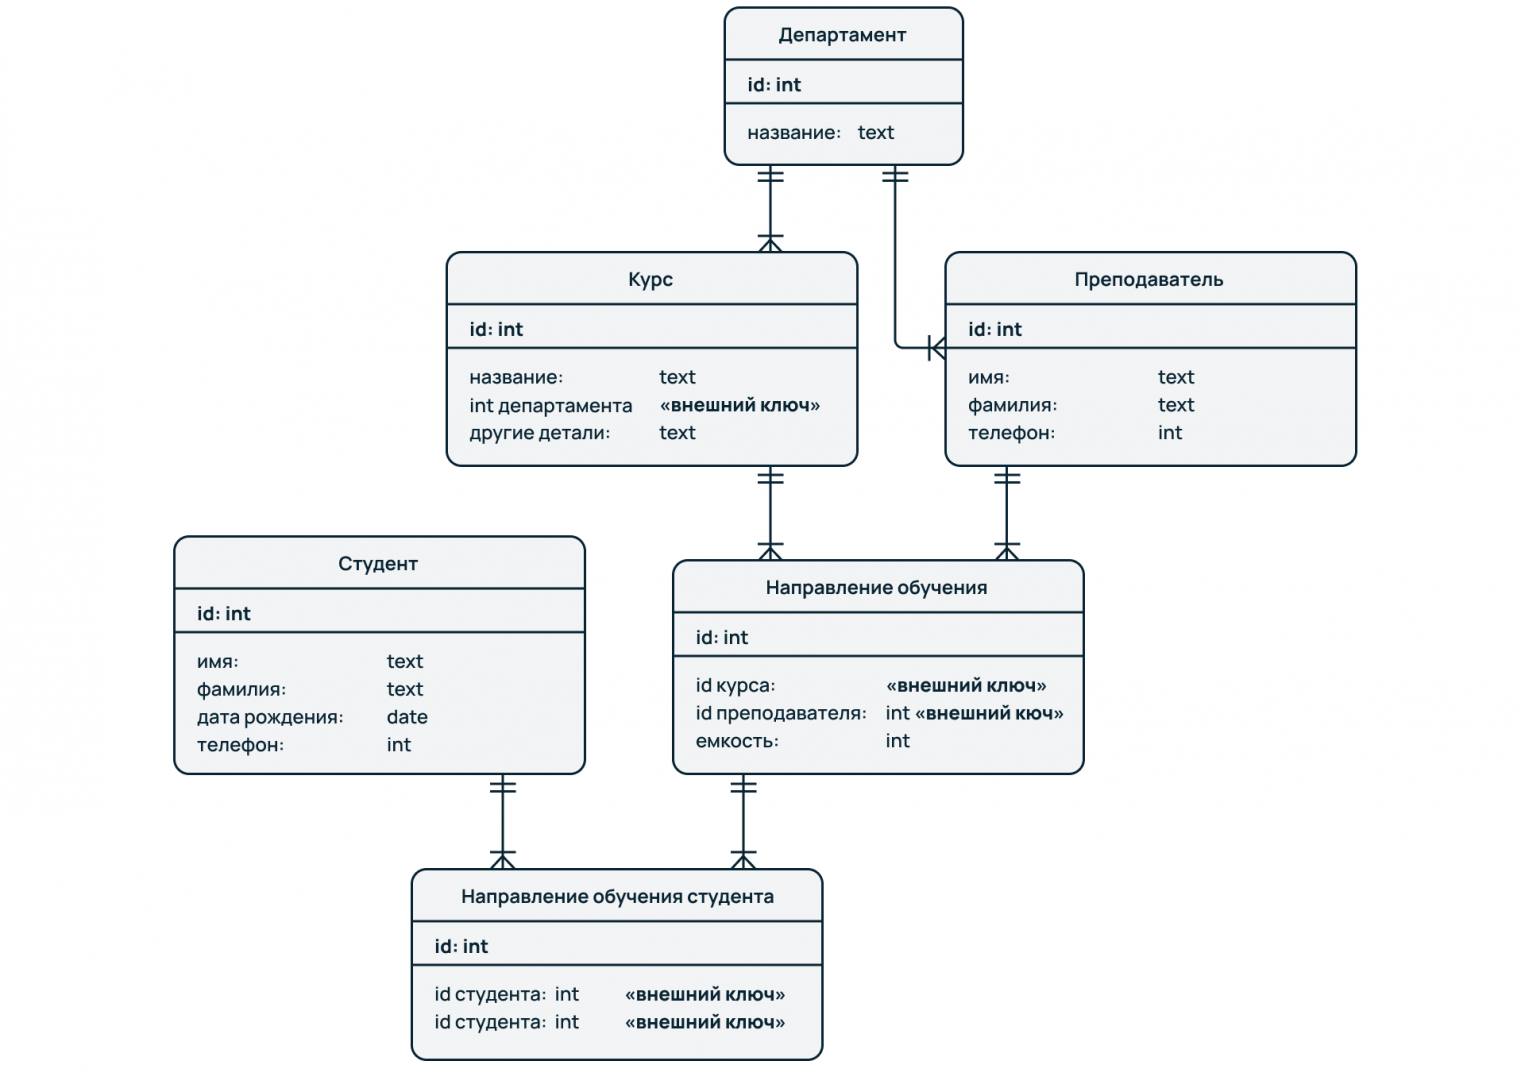
Основные принципы
Сложные взаимоотношения объектов в реляционных базе данных моделируются с помощью внешних ключей – ссылок на другие таблицы. Это позволяет подходить к вопросу проектирования базы данных с позиций нормализации – минимизации избыточности при описании свойств объектов.
Гарантии ACID. Все РСУБД поддерживают ACID с самими высокими гарантиями изоляции.
Trade-Offs
| Преимущества | Недостатки |
|---|---|
| Нормализованная структура имеет меньший объем по сравнению с денормализованной | Отсутствие масштабируемости на запись |
| Поддержка ACID на уровне всей базы в отличии от большинства NoSQL конкурентов. | Во всех специализированных сценариях будет проигрывать специализированным базам данных |
Моделирование сложных отношений | |
Универсальная база широкого назначения. Поддерживает как OLTP так и OLAP сценарии использования. Позволяет взглянуть на данные под любым углом. | |
Популярный язык запросов SQL | |
Богатая история развития и широкое распространение (основной инструмент при разработке различных приложений и сервисов). |
NoSql/Key-value DataBase
Модель данных «Ключ-Значение» является одной из наиболее простых и широко используемых моделей в NoSQL базах данных. Она основывается на простой абстракции, где каждая запись в базе данных представляет собой пару «ключ-значение».
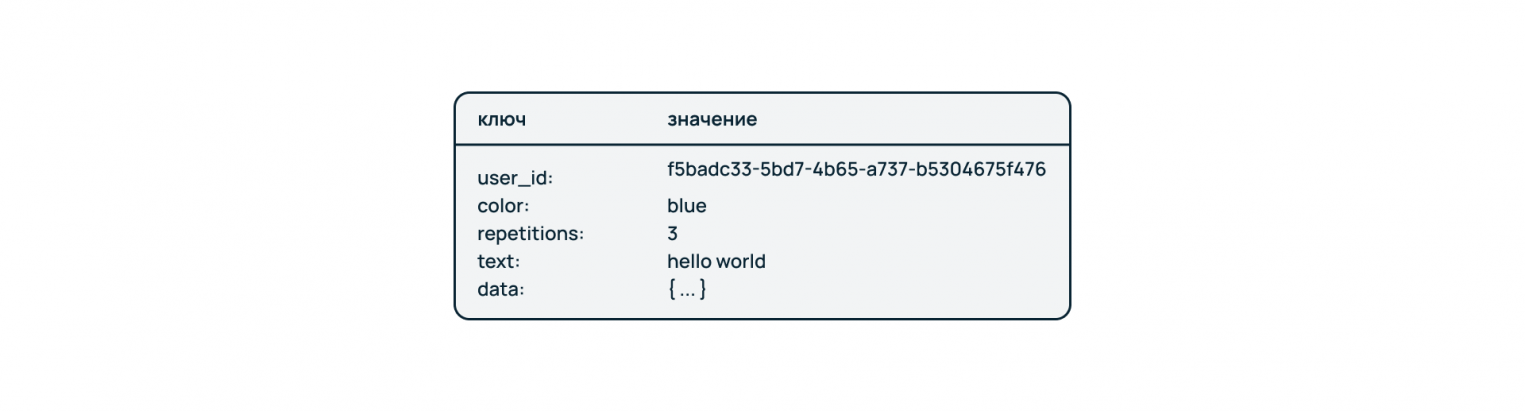
Основные принципы
В модели данных «Ключ-Значение» каждая запись хранится с уникальным ключом, который используется для идентификации и извлечения этой записи. Значение, связанное с ключом, может быть практически любого формата, включая строки, числа, JSON-объекты, бинарные данные и многое другое.
Trade-Offs
| Преимущества | Недостатки |
|---|---|
Высокая производительность: Быстрый доступ к данным по ключу делает эту модель отличным выбором для кэширования и быстрого поиска данных. | Отсутствие сложных запросов: Эта модель ограничивает способность выполнять сложные запросы и аналитику, характерные для реляционных баз данных. |
Гибкость: Значения могут быть разного типа, что позволяет хранить разнообразные данные. | Сложность в обработке связей: Если вам нужно хранить и работать с данными, имеющими сложные взаимосвязи, модель «Ключ-Значение» может потребовать дополнительной работы. |
Масштабируемость: Многие NoSQL базы данных с моделью «Ключ-Значение» могут масштабироваться горизонтально, обрабатывая большие объемы данных и высокие нагрузки. |
NoSql/Document-Oriented DataBase
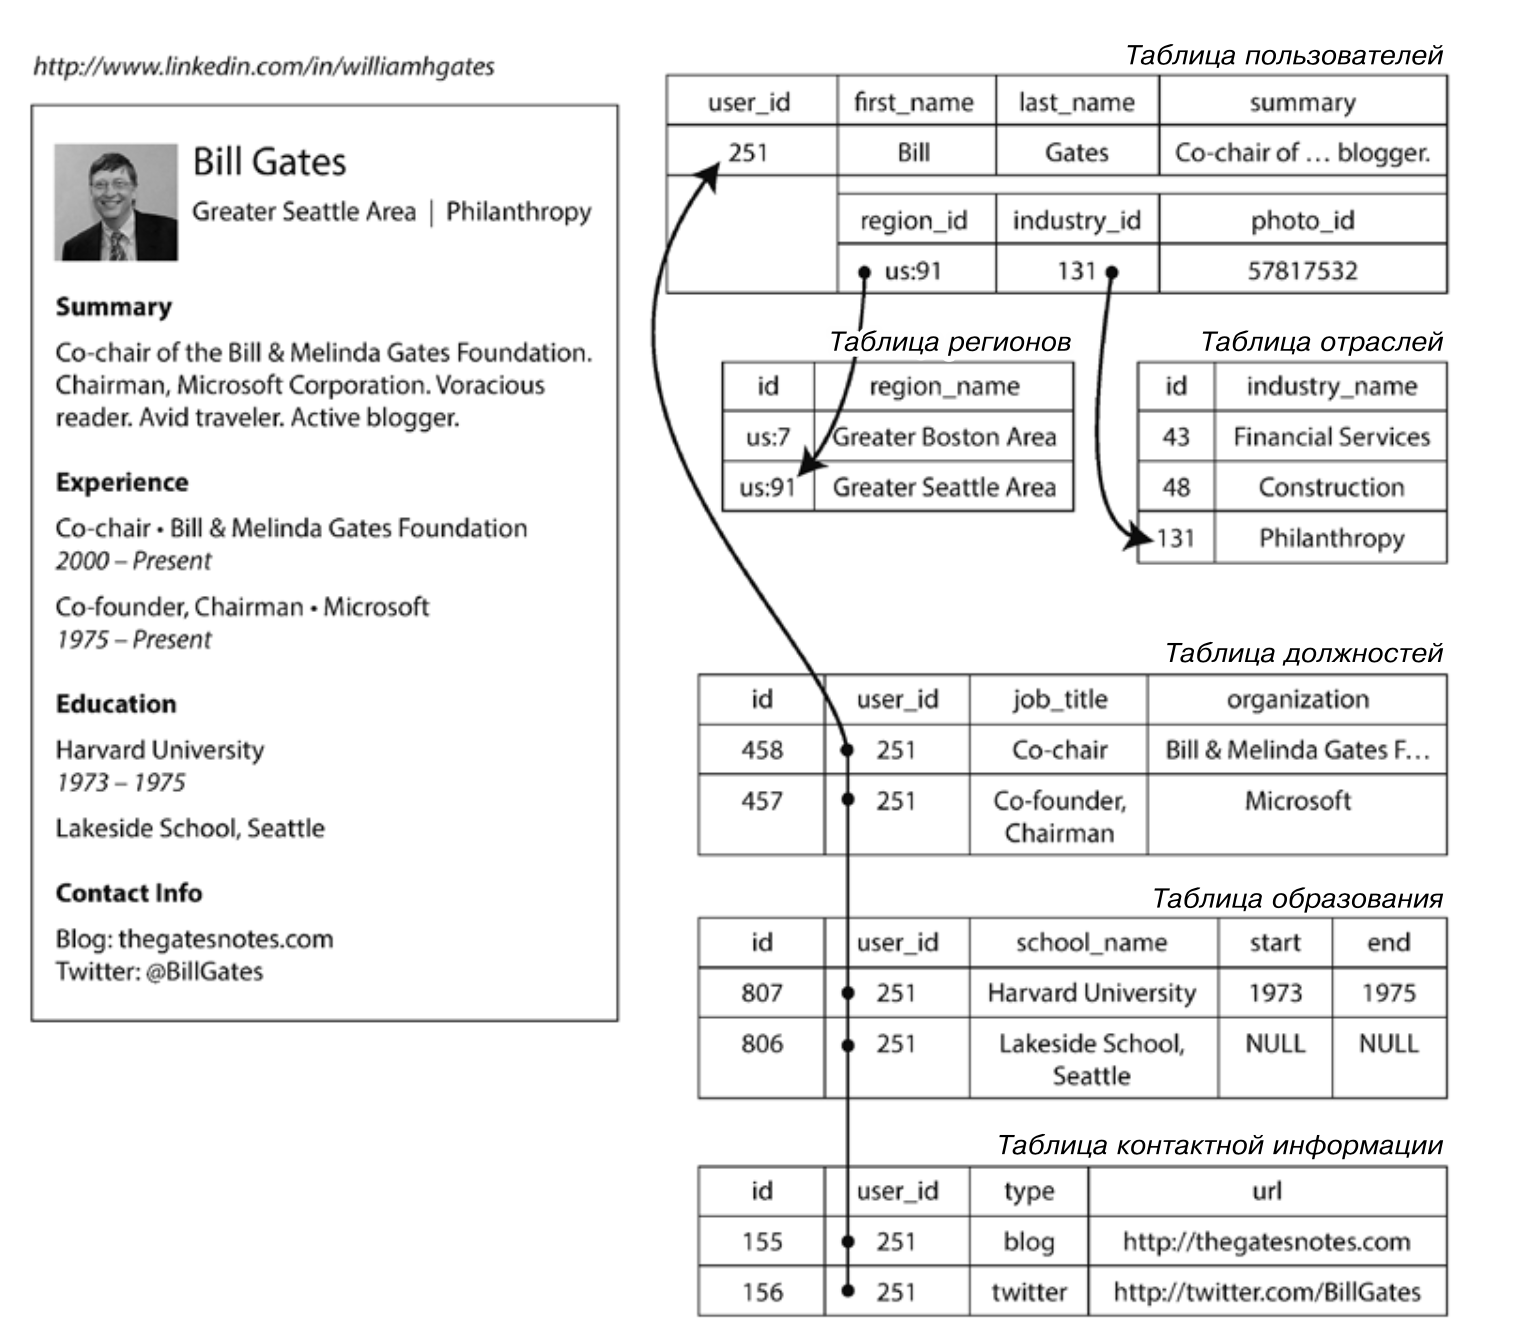
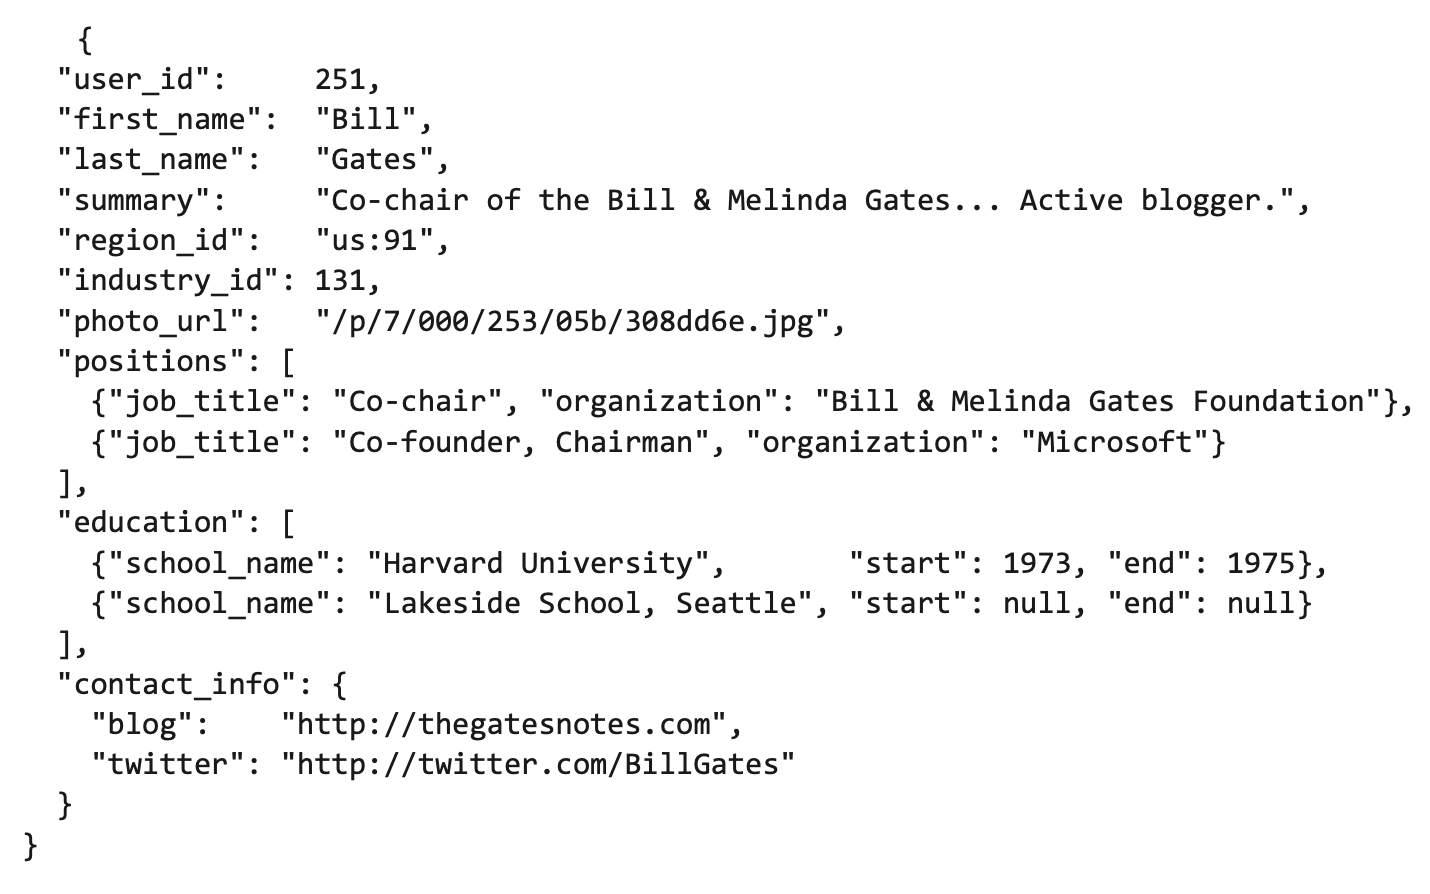
В отличие от баз типа «Ключ-значение» данные здесь хранятся в структурированных форматах – XML, JSON, BSON. Тем не менее, сохраняется адресный доступ к данным по ключу. При этом содержимое документа может иметь различный набор свойств.
Для примера можем рассмотреть как мог бы выглядеть профиль Билла Гейтся в LinkedIn.
Основные принципы
- Документы: Основная единица данных — документ. Документ может содержать структурированную информацию, включая вложенные документы и списки. Важно отметить, что документы могут иметь разную структуру в одной и той же коллекции.
- Уникальные идентификаторы: Каждый документ имеет уникальный идентификатор, который обеспечивает быстрый доступ к данным.
- Гибкая схемa: Документы в документо-ориентированных базах данных могут иметь разные поля и структуры, что делает схему данных более гибкой по сравнению с реляционными базами данных. Это означает, что вы можете добавлять и изменять поля в документах без необходимости изменения всей схемы.
Trade-offs
| Преимущества | Недостатки |
|---|---|
Гибкость: Схема данных является гибкой, что позволяет хранить и изменять данные без необходимости изменения всей схемы. Это особенно полезно в ситуациях, когда структура данных меняется с течением времени. Справедливости ради сложно это считать преимуществом. Схема все-равно есть, но смещается она на сторону потребителя. | Сложность запросов между документами: В сценариях, где требуется выполнение сложных запросов, связанных с данными из нескольких документов, документо-ориентированные базы данных могут оказаться менее удобными чем РСУБД |
Мощные запросы: Документо-ориентированные базы данных предоставляют мощные инструменты для запросов данных, включая возможность индексации, фильтрации и агрегации данных. | Избыточность данных: Поскольку данные могут дублироваться в разных документах, есть риск избыточности данных и несоответствия данных между документами. |
Скорость доступа: Документы могут быть быстро извлечены по уникальному идентификатору, что обеспечивает высокую производительность. Достигается за счет локальности данных. | Не подходит для связанных данных: В случае, когда требуется работать с данными, имеющими сложные взаимосвязи, такие как транзакции и связи между сущностями, модель документов может потребовать дополнительной обработки. Современые документные базы данных не страдают этой проблемой, но остаются ли они все еще документными? Кажется, что уже нет. |
Подходит для больших объемов данных: Многие документо-ориентированные базы данных могут масштабироваться для обработки больших объемов данных и высоких нагрузок. |
NoSql/Graph database
Это семейство баз предназначено для моделирования сложных отношений с помощью теории графов, где связями выступают ребра графа, а сами объекты – это узлы или вершины.
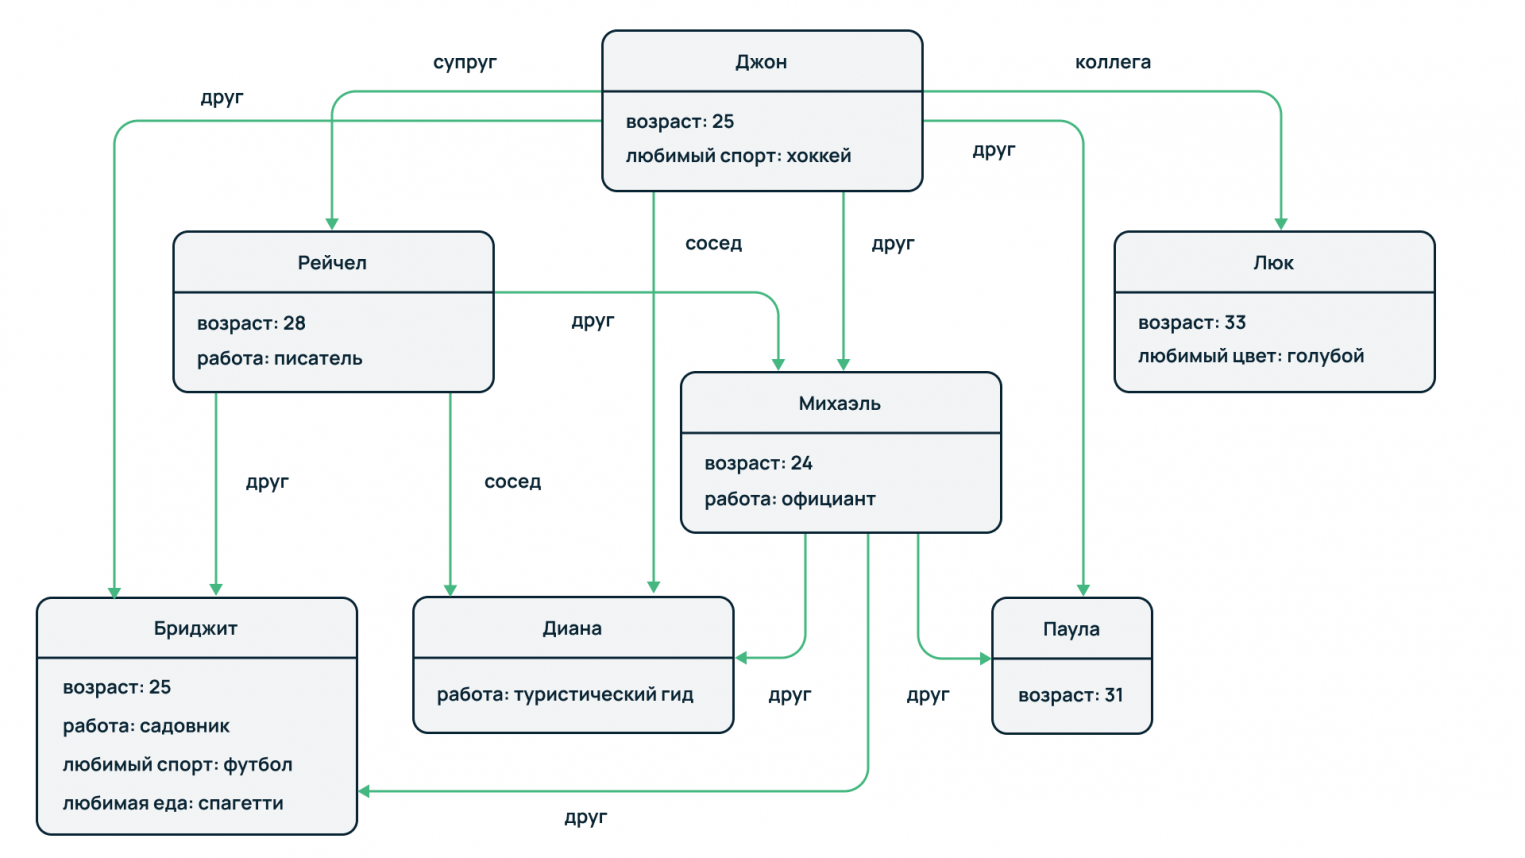
Такой подход может пригодиться при анализе профилей пользователей социальных сетей. Один пользователь подписан на обновления второго, другой пользователь подписан на определенное сообщество и так далее. Также технология может использоваться при анализе экономической активности контрагентов для выявления различных схем мошенничества. Например, можно отследить использование определенных счетов, карт или реквизитов контрагентов в различных операциях.
Основные принципы
Trade-Offs
| Преимущества | Недостатки |
|---|---|
Моделирование сложных отношений: Графовые базы данных идеально подходят для моделирования данных, где отношения между сущностями играют важную роль. Например, они могут использоваться для анализа социальных сетей, рекомендательных систем и семантических сетей. | Неэффективность для определенных запросов: Графовые базы данных могут оказаться неэффективными для запросов, которые не связаны с анализом отношений между сущностями. |
Гибкий и интуитивный запросы: Графовые базы данных предоставляют интуитивные средства запросов, которые позволяют легко находить и анализировать данные в графе. Языки запросов, такие как Cypher, спроектированы специально для работы с графами. | Сложность масштабирования: Масштабирование графовых баз данных может оказаться сложной задачей, особенно в случае больших и высоконагруженных графов. |
Высокая производительность для определенных задач: В задачах, где необходимо находить связи между вершинами, графовые базы данных могут обеспечивать высокую производительность и эффективность. |
NoSQL/Column/wide column/column family database
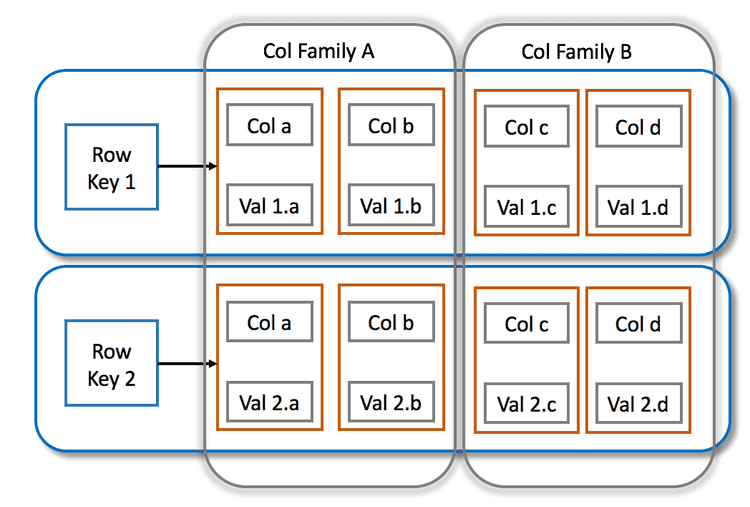
Базы данных широких колонок внешне похож на реляционные базы. Как и реляционные, семейства колонок хранят данные, используя строки и столбцы, но с иной связью между элементами.
В реляционных базах все строки должны соответствовать фиксированной схеме. Схема определяет, какие столбцы будут в таблице, типы данных и другие критерии. В семействе колонок вместо таблиц имеются структуры – «колоночные семейства». Семейства содержат строки, каждая из которых определяет собственный формат. Строка состоит из уникального идентификатора, используемого для поиска, за которым следуют наборы имён и значений столбцов.
Называть семейства колонок или базы широких колонак, столбцовыми означало бы вводить себя и других в заблуждение: внутри каждого семейства столбцов все столбцы из строки хранятся вместе наряду с ключом строки и сжатие столбцов там не используется. Следовательно, модель данных Bigtable является в основном построчной.
Основные принципы
Колонки: Данные хранятся в виде колонок, где каждая колонка представляет собой отдельный атрибут или поле данных. Это отличается от традиционных реляционных баз данных, где данные хранятся в виде строк, представляющих сущности целиком.
Семейства колонок: Колонки могут быть сгруппированы в семейства колонок, что позволяет организовать данные логически. Например, все данные о пользователях могут храниться в одном семействе колонок, а данные о продуктах — в другом. Таким образом мы можем минимизировать объем прочитанных с диска данных.
Семейства супер колонок: Семейства колонок могут быть сгруппированы в семейства супер колонок, что позволяет организовать данные логически. Такой подход позволяет при необходимости более эффективно прочитать разом несколько семейств колонок. Такая организация позволяет более эффективно работать с диском.
Trade-Offs
| Преимущества | Недостатки |
|---|---|
| Высокая производительность чтения: Базы данных широких колонок обеспечивают высокую производительность для запросов, которые требуют доступа к ограниченному набору колонок. | Сложность моделирования отношений: В модели баз данных широких колонок отношения между данными могут быть сложными для представления и обработки. |
Горизонтальное масштабирование: Многие колоночные базы данных, такие как Cassandra и HBase, поддерживают горизонтальное масштабирование, что позволяет обрабатывать растущие объемы данных. | Ограниченная поддержка транзакций: Некоторые базы данных широких колонок могут иметь ограниченную поддержку транзакций, что делает их менее подходящими для приложений, требующих высокой согласованности данных. |
NoSQL/Column/column oriented/base column
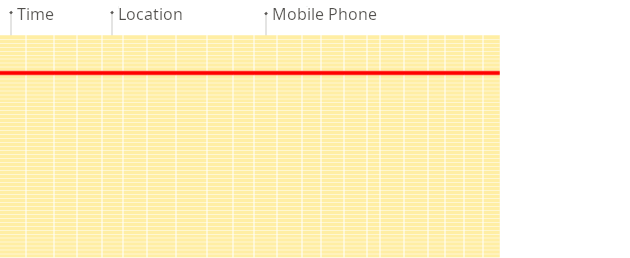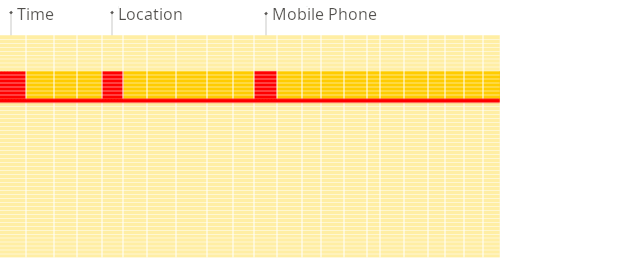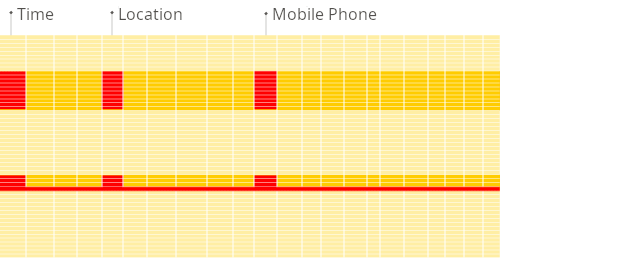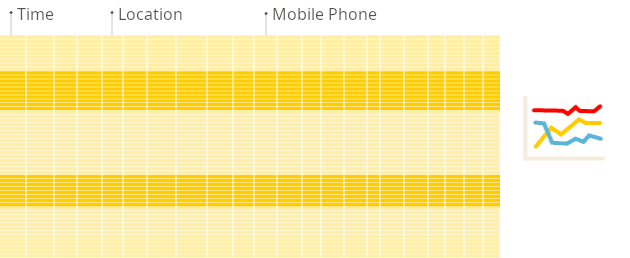
Базы данных ориентированные на колонки предназначены для работы с аналитическими сценариями. Такие базы группируют свои записи не по строкам как это делают релиационные базы, а по колонкам. Такая организация позволяет:
- считывать данные только из нужных колонок
- эффективно сжимать однотипную информацию
- физически сортировать данные по первичному ключу, что позволяет быстрее получать интересующую информацию
- использовать векторные вычисления по кусочкам столбцов, снижая издержки на диспетчеризацию (эффективно используется CPU)
Строковые СУБД
Столбцовые СУБД
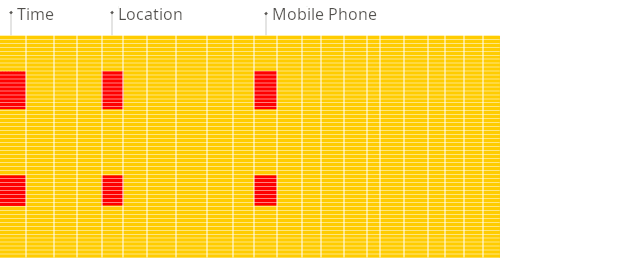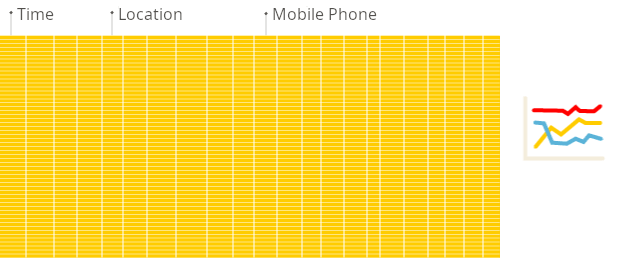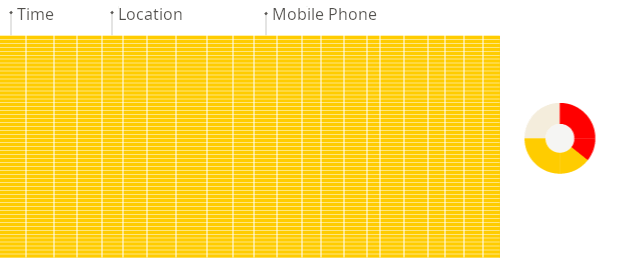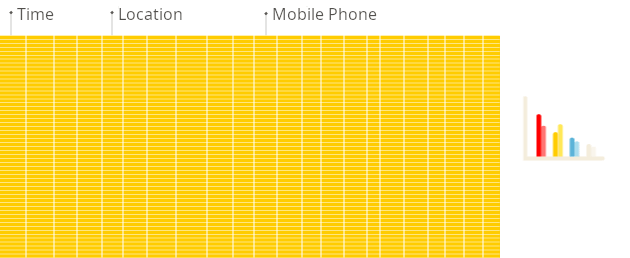
Trade-Offs
| Преимущества | Недостатки |
|---|---|
| Высокая производительность чтения OLAP сценариев: Ориентированные на колонки базы данных хорошо работают для аналитических запросов. | Не подходит для OLTP сценариев использования
|
| Как правило высокая масштабируемость: Обычно такие базы данных изначально спроектированы под высокие требования по масштабируемости | Сложность в моделировании данных |
NoSQL/Search Engine
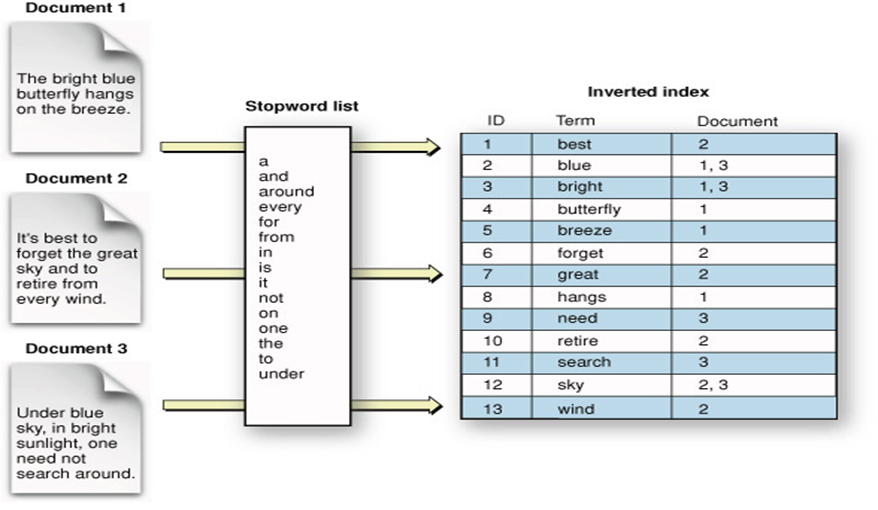
Специализированное семейство ни в коем случае не является конкурентам релиационным баз. Задача поисковых движков подержать сложные поисковые запросы к данным. По сути это вторичный индекс к любой другой базе данных.
Trade-Offs
| Преимущества | Недостатки |
|---|---|
| Вторичный индекс для систем которые такой индекс не поддерживают. В первую очередь полнотексторый. | Такие система как правило сложно использовать как первичное хранилище данных |
| Вертикальная масштабируемость. Такие системы как правило уже спроектированны с учетом роста | Моделирование отношений. Не подходит для моделирования отношений. Как правило пребудет денормализации. |
| Отказоустойчивость. Как и большенство NoSQL решений. В основу поисковых движков изначально закладывают риски отказов |
NoSQL/time series database
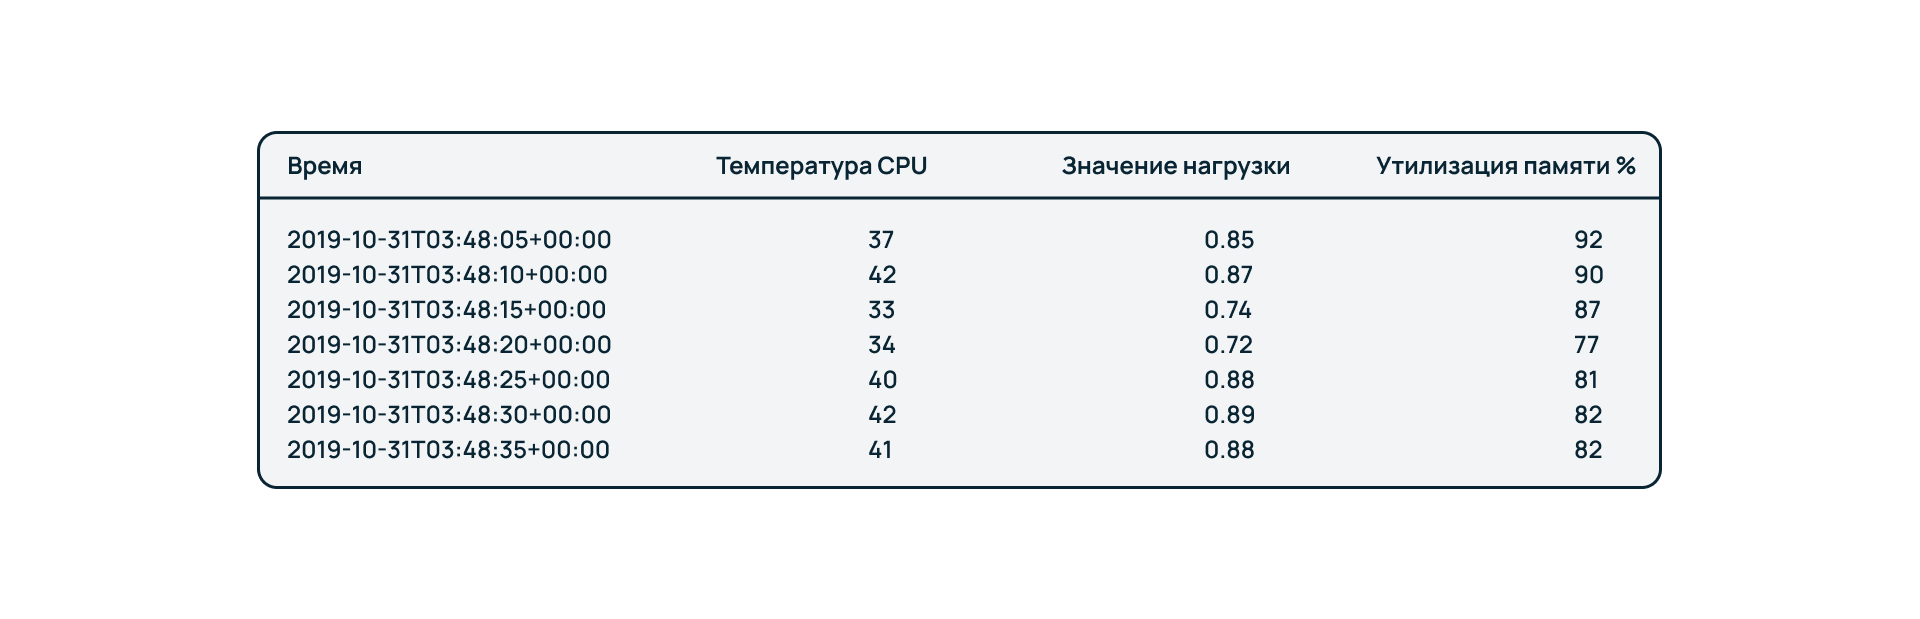
Данный тип баз данных можно использовать при необходимости отслеживания исторической динамики по ряду показателей. Здесь данные группируются по временным меткам. Базы временных рядов чаще ориентированы на запись, чем на построение сложных аналитических запросов.
Trade-Offs
| Преимущества | Недостатки |
|---|---|
| Ориентированны на запись большого объема данных | Специализированное решение для анализа временных рядов. Таких как:
|
| Идеально подходит для time series сценариев | |
NoSQL/Multi-model database
Такие базы данных сочетают в себе несколько подходов к организации данных одновременно. Это обеспечивает функциональное разнообразие при разработке систем с их использованием.
Справедливости ради большинство совремпнных баз данных стремятся к мульти модельности. Зачастую уже и не понятно к какому семейству принадлежит та или иная базу.
Например:
- PostgreSQL поддерживает работу с JSON документами
- ElasticSearch позволяет хранить объекты, а не только индекс
- MongoDB вводит понятие валидаторов и проверяет валидность схемы при записи
- ...
Отличительной особенностью мульти-модельных баз данных является их изначальное проектирование с целью поддержания множественных моделей. Такие базы как правило имеют в своём составе очередь сообщения для рассылки общий последовательности.

Trade-Offs
| Преимущества | Недостатки |
|---|---|
| Высокая масштабируемость. Такие базы данных как правило изначально спроектированны под высокие нагрузки | Как правило такие решения распространяются под закрытой лицензией и лицензирование стоит денег |
| Отказоустойчивость. Принципы высокой доступности и терпимость к отказам в них обычно заложены изначально | Серебренной пули не существует. Одна база скорее всего не удовлетворит всем нужным требованиям. Либо реализация будет хромать. Либо функциональности будет не хватать. |
| Более эффективная работа с разными представлениями в сравнении с базами широкого применения. | Конечная согласованность. Не для всех приложений допустима согласованность в конечном счете. Может так получиться, что вам нужно вычитать из вторичного индекса, а он не согласован в данный момент. |
| Консистентность данных между разными моделями. Такие базы данных сами заботятся о консистентности данный между разными представлениями |
NewSQL
NewSQL базы данных это попытка переиспользовать существующие SQL решения в распределенной среде. Как правило в таких базах за основу взято какая-то SQL база. Поверх реализовано шардирование и синхронная репликация. Такие базы данных как правило не способны обрабатывать распределенные транзакции, но гарантируют строгой согласованности в репликах.
Trade-Offs
| Преимущества | Недостатки |
|---|---|
| Поддержка ACID на несколько строк внутри одного шарда | Наследие прошлого, в виде РСУБД, не позволяет реализовать распределенные транзакции |
| Горизональная масштабируемость | |
| Отказоустойчивость |
DistributedSQL
DistributedSQL базы данных наследуют реляционную структуру и семантику, но построены с использованием более современных, масштабируемых конструкций. Цель – обеспечить большую масштабируемость, нежели РСУБД, и более высокие гарантии согласованности, чем в NoSQL. Компромисс между согласованностью, доступностью и производительностью является фундаментальной проблемой распределённых баз данных.
Часто термины NewSQL и DistributedSQL используют в качестве синонимов, но это не так. DistributedSQL построены полностью с нуля и не наследуют проблемы монолитных SQL.
Trade-Offs
| Преимущества | Недостатки |
|---|---|
| Масштабируемость. Это базовый принцип заложенный в это семейство | Для эффективной работы с данными и транзакциями по прежнему требуется локальность данных. |
| Согласованность. От этого семейства требуется высокий уровень согласованности и изоляции | Хоть и заявляется распределенный ACID, но он по прежнему не рекомендуется. Такие транзакции хоть и возможно, но остаются по прежнему дорогими. |
| Распределенная база данных SQL естественным образом должна обеспечивать высочайший уровень отказоустойчивости без необходимости использования внешних инструментов для достижения этой цели. | |
| Поддержка ACID как локального так и распределенного |