Структуры данных
Структуры данных оптимизированные под поиск это всегда компромисс между скоростью записи, скоростью чтения и долговечностью даных. Этот компромисс не всегда очевиден но, он всегда есть. Все структуры данных мы скорее всего рассмотреть просто не успеем, но постараемся обратить внимание на самые интересные.
Хеш-индексы
Наверное одна из самых популярных структур это хеш таблицы. В большенстве языков программирования они есть и поэтому максимально знакомы для разработчика.
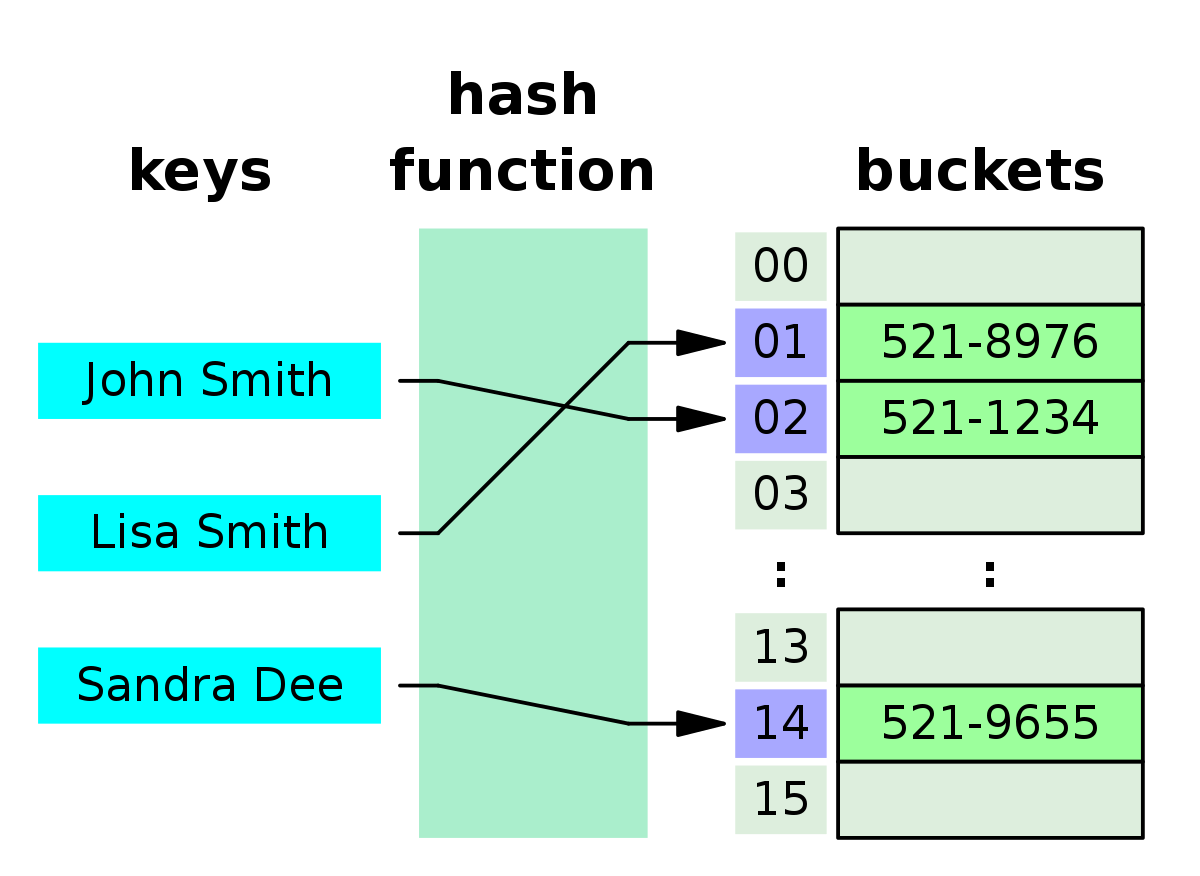
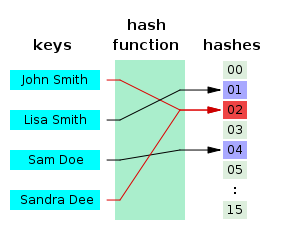
Принцип хеш-индексов просто. Ключ подается на вход хеш функции которая возвращает натуральное число. Задачи хорошей хеш функции минимизировать вероятность коллизий.
Trade-Offs
| Преимущества | Недостатки |
|---|---|
| Хеш-индекс имеет лучшую производетельность на чтение 0(1) | Хеш-индекс должен целиком помещаться в оперативную память |
Запросы по диапазону неэффективны. Например, невозможно с легкостью просмотреть все записи между kitty00000 и kitty99999 — необходимо искать каждый ключ отдельно в хеш-картах. | |
| Запросы только по ключу |
B-деревья
Наиболее широко используемая индексная структура — B-дерево.
B-деревья разбивают базу данных на блоки или страницы фиксированного размера, обычно 4 Кбайт (иногда больше), и читают/записывают по одной странице за раз. Такая конструкция лучше подходит для нижележащего аппаратного обеспечения, поскольку диски тоже разбиваются на блоки фиксированного размера.
Все страницы имеют свой адрес/местоположение, благодаря чему одни страницы могут ссылаться на другие — аналогично указателям, но на диске, а не в памяти. Этими ссылками на страницы можно воспользоваться для создания дерева страниц
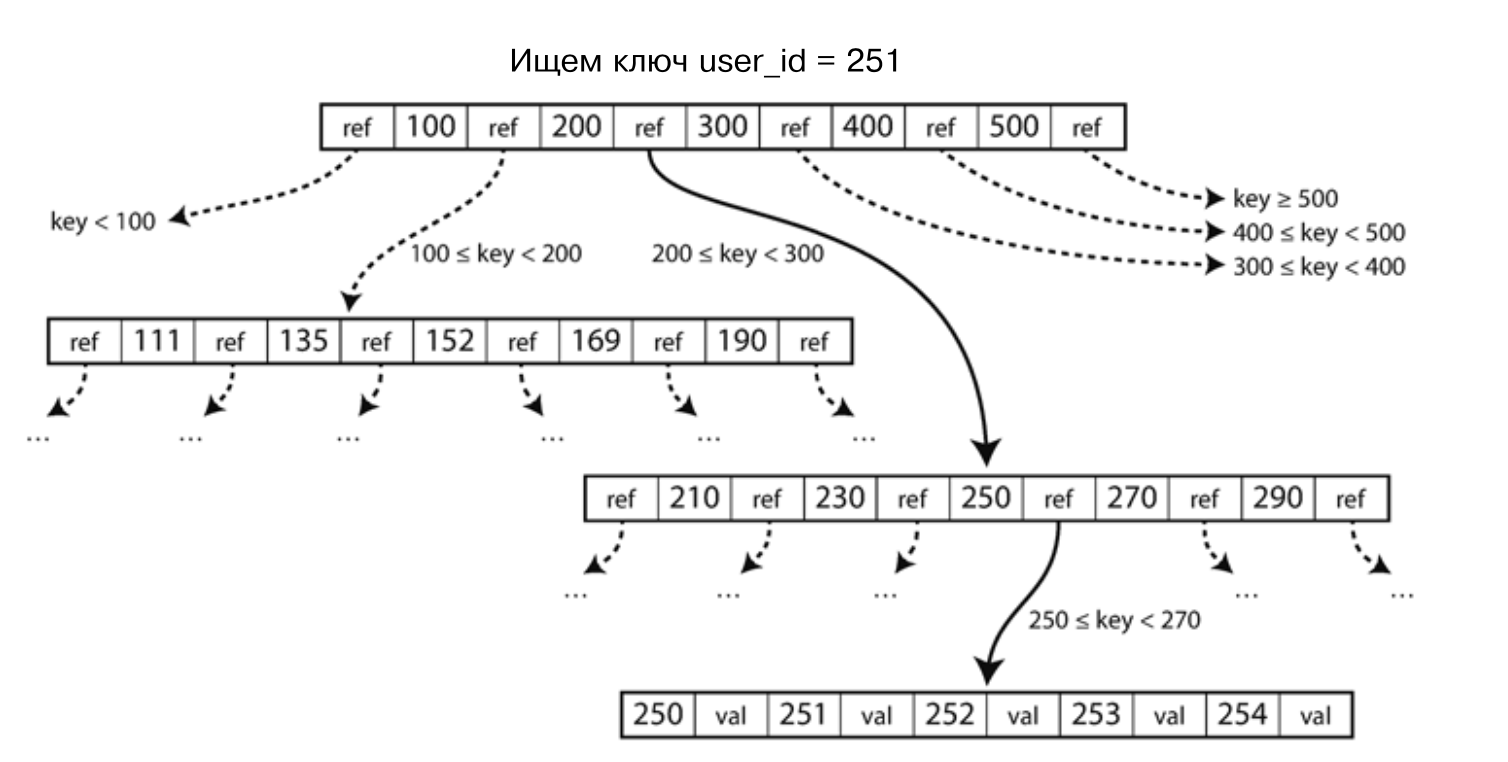
Одна из страниц назначается корнем B-дерева, с него начинается любой поиск ключа в индексе. Данная страница содержит несколько ключей и ссылок на дочерние страницы. Каждая из них отвечает за непрерывный диапазон ключей, а ключи, располагающиеся между ссылками, указывают на расположение границ этих диапазонов.
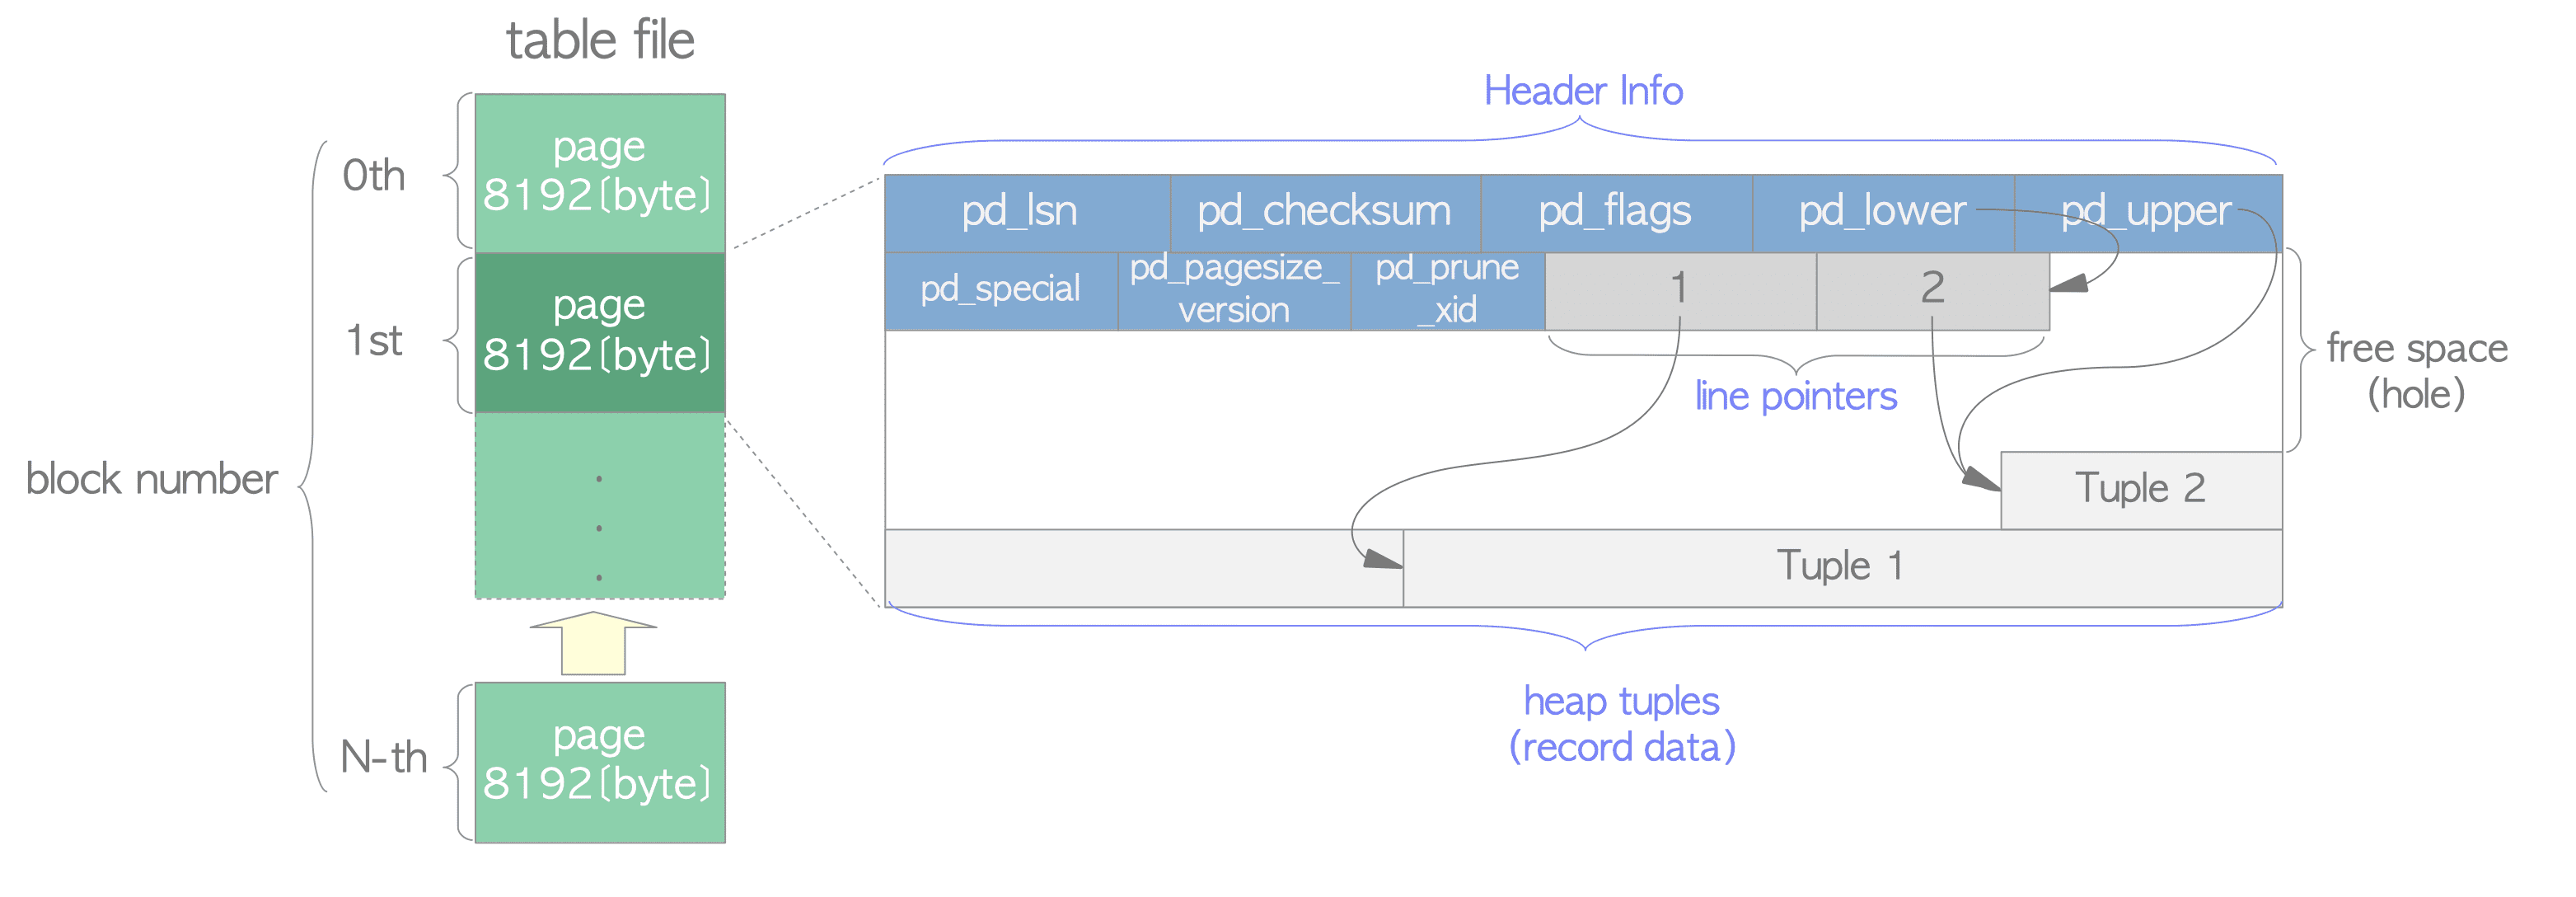
Ниже я приведу пример страницы PostgreSQL.
Схожие структуры
Описанная мной структура это не всё как применяются B-деревья
- Составные индексы. Большее сложные индексы способные в дереве хранить поиск по нескольким предикатам
- Покрывающие индексы. Как правило B-деревьям свойственно после поиска в индексе осуществлять запрос к данным. Покрывающие индексы решают эту проблемы. Сами индексы содержат и все необходимые данные по запросу.
Trade-Offs
| Преимущества | Недостатки |
|---|---|
| Поиск по диапазонам за logN | Не так быстро как хаш-индекс, но по прежнему очень быстро |
| Возможность частичного хранения на диске и в памяти | |
Возможность построения сложных состовных индексов |
Инвертированный индекс
Инвертированный индекс — структура данных, в которой для каждого слова коллекции документов в соответствующем списке перечислены все документы в коллекции, в которых оно встретилось. Инвертированный индекс используется для поиска по текстам.
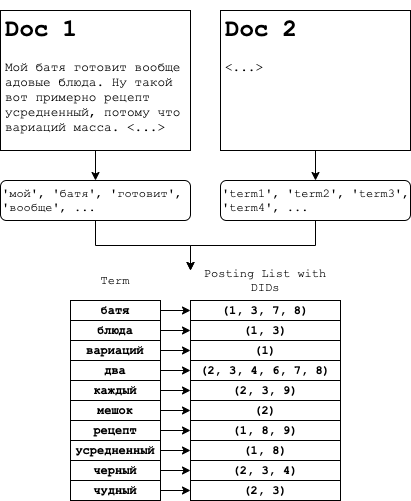
Есть у нас набор документов, по которым необходимо вести поиск. Всем документам присваивается document ID. Каждый документ разбивается на термы, термы при желании обрезаются или приводятся к каноничной форме, убираются стоп-слова (слова с высокой частотностью не влияющие на результат поиска). Для каждого обработанного терма составляется список DID документов, содержащих этот терм.
Различные реализации инвертированных индексов также могут сохранять точные места в документе, где встречается терм или общее количество вхождений терма в документ. Эта дополнительная информация используется при подсчете метрик релевантности или для выполнения специфичных запросов, в которых важно взаимное расположение термов в документе.
Вторая часть инвертированного индекса — словарь всех термов. Под словарь используется KV-хранилище, где термы являются ключами, а значения — список document ID. Обычно для KV-хранилища в оперативной памяти используются хеш-таблицы и деревья. Однако для словаря термов могут оказаться более подходящими другие структуры, например, префиксные деревья.
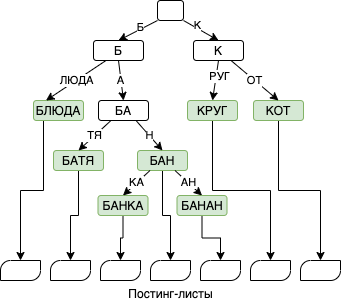
При запросе поиска по инвертированному индексу, строка запроса проходит те-же стадии, что и при добавлении документа в инвертированный индекс, а именно: срока запроса разбивается на термины, термины при желании обрезаются или приводятся к канонической форме, убираются стоп-слова. Полученый список терминов передаётся на вход словарю. Словарь для каждого термина выдаёт список документов где встречается термин. Далее происходит ранжирование документов по частотности употребления терминов и по позициям совпадению позиций терминов в документах. На выходе мы получаем список документов ранжированный по наиболее точному совпадению.
Trade-Offs
| Преимущества | Недостатки |
|---|---|
| Возможность полнотекстового поиска | Инвертированный индекс сложен для перестроения. Поэтому обычно согласован в конечном счете с мастер данными |
| На базе инвертированного индекса строятся поисковые движки работающие не только с полнотекстом, но и с любым другим поиском | Такой тип индекса требователен к вычислительным ресурсам |
Ссылки
LSM-деревья
LSM-деревья (Log-structured merge-tree) будет следующий интересной структурой которую мы разберем. LSM-деревья - структура отптимизированная на запись.
Давайте разберемся почему же эта структура такая быстрая на запись.
- Нету проверки уникальности. На этапе записи нет проверки уникальности и соответственно решения конфликтов.
- Данные пишутся в память (формируется Memtable), а для гарантии долговечности записываются в журнал упреждающей записи.
- Как только Memtable достигает порога размера или времени жизни, формируется файл (SSTable) и записывается на диск. Таких файлов может быть много.
- Производится очистка журнала упреждающей записи
Как же происходит чтение?
- Запрос на чтение ищет значение в Memtable (но не всегда. по дефолту cassandra и elasticsearch не осуществляют поиск в Memtable)
- На следующем этапе поиск осуществляется в каждой SSTable
- Т.к. проверки на уникальность нет, ключи могут пересекаться. После получения всех значений по одному ключу происходит выборка самого свежего (решение конфликтов - выигрывает последний)
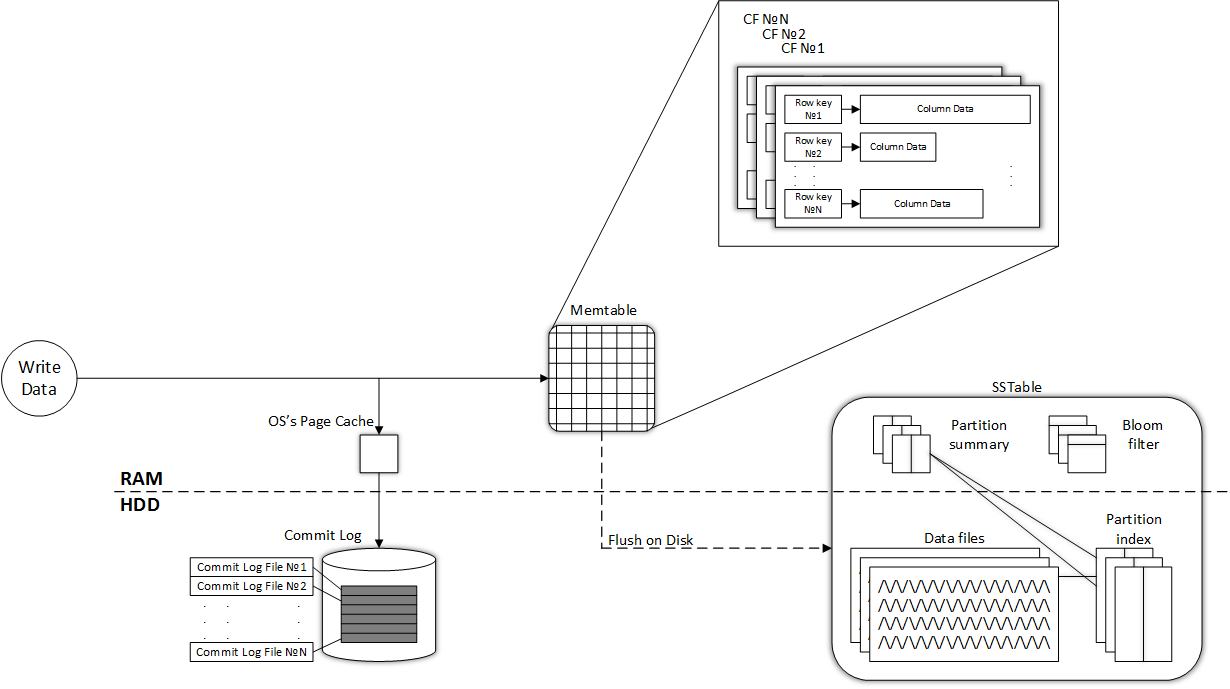
Но это слишком поверхнасный разбор. Давайте подробнее остановимся на каждом компоненте.
Commit Log
Журнал упреждающей записи или WAL. Думаю все знают, что такое WAL, но повторю на всякий случай. По сути это append only структура. Дисковые накопители как и твердотельные (хоть и в меньшей степень) лучше работают с последовательной чтением/записью. Последовательная запись на диск окаывается очень быстрой (не быстрее оперативной памяти конечно, но оперативная память не дает гарантий сохранности данных). WAL позволяет нам не потерять данные при сбое системы, но при этом гарантировать быструю запись (с оговорками. cassandra делает fsync раз в 10 секунд).
Memtable
Структура в памяти реализующая красно-черного дерево для быстрого поиска данных по ключу.
SSTable
Partition summary. Разряженный индекс на Partition Index. Предназначена для ускорения поиска.
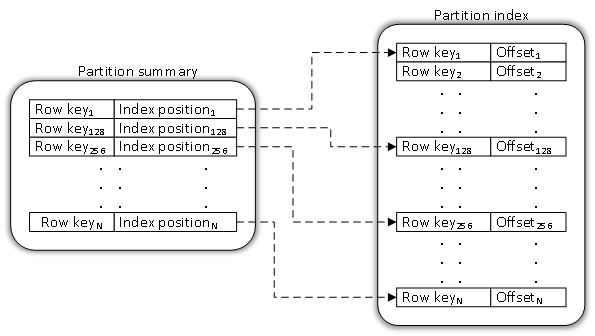
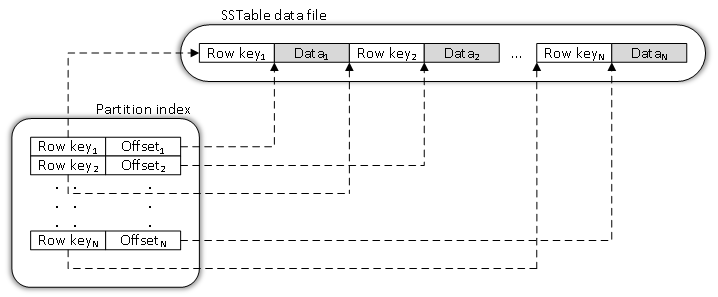
Partition Index. Представляет из себя своего рода карту данных определенной SSTable, которая содержит все ключи записей и необходимое смещение относительно начала файла данных.
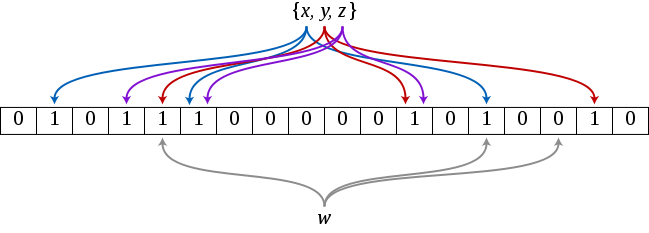
Bloom filter. Имея сотни, а может быть и тысячи SSTable как быстро ответить на вопрос в какой из них искать нужную запись? Можно последовательно перебирать файлы индексов раздела, но это очень сильно нагрузит дисковую подсистему, пусть даже это будет проходить через сводки разделов, располагающихся в оперативной памяти. Есть более гибкое решение, которое может однозначно предупреждать о 100% отсутствии нужной записи в той или иной SSTable. Решение заключается в использовании вероятностной структуры данных под названием bloom-фильтр.
Рассмотрим как это работает.
Допустим мы имеем массив битов некоторой длины и 2 разные хэш-функции. Значение хэш-функций для имени Lena (в нашем случае имя – это ключ записи) будет равно 45 для первой хэш-функции и 92 для второй соответственно. В массиве битов, который изначально состоит только из 0, переводим соответствующие по счету биты в значение 1. То же самое выполняем для имени Masha, но только получаем 73 для первой хэш-функции и 23 для второй. Теперь имеем массив битов, в котором позиции 45, 92, 73 и 23 установлены в 1. Таким образом когда к нам придет запрос "Дай мне значение для ключа Lena" мы прогоним ключ через наши хеш-функции и проверим заполнение нашего массива битов. Если все биты в нужных позициях будут содержать 1, тогда мы можем предположить, что такое значение возможно присутствует в наших данных (возможно потому, что какой-то другой ключ мог установить 1 в эти позиции). Если же хотя бы в одной из нужных позиций установлен 0, тогда наш фильтр точно не встречал такого ключа.
Data files. Собственно это наши отсортированные данные.
Слияние сегментов
Если бы мы только добавляли SSTable и не удаляли бы их, а как мы помним они не изменны, поиск нужного значения мог бы занимать слишком много времени.
Не просто так в наименовании структуры присутствует merge-tree. Т.к. данные внутри SSTable отсортированны, их слияние становится достаточно простой задачей пришедшей из мира больших вычислений (Merge sort tree). При достижении порогового значения таблиц, запускается фоновый процесс слияния сегментов, при котором более старые ключи удаляются. Такой механизм позволяет по прежнему эффективно писать и держать под контролем операции чтения.
Схожие структуры
На базе LSM-деревьев основано большое количество разновидностей индексов.
- Apache Lucen (база для ElasticSearch и Solr). В основе своей имеет LSM-деревья, но оптимизированные для полнотекстового поиска
- ClickHouse колоначная база. Использует подобную LSM структуру, но не реализует Memtable.
- Prometheus. Также реализует LSM, но оптимизированный под времянные ряды
Trade-Offs
| Преимущества | Недостатки |
|---|---|
| Высокая производительность записи с гарантиями долговечности | Отсутствует ограничение уникальности |
| Относительно высокая производительность чтения, за счет слияния сегментов |
Index-free
Еще одной из интересных структур можно считать структуру безиндексной сложности. Структура специально предназначенная для поиска в графе.
Давайте сначала рассмотрим почему графовый поиск плохо работает в неграфовых база данных.
Представьте приложение в котором одни пользователи могу подписываться на других. В RDBMS это могло выглядеть как на рисунке ниже.
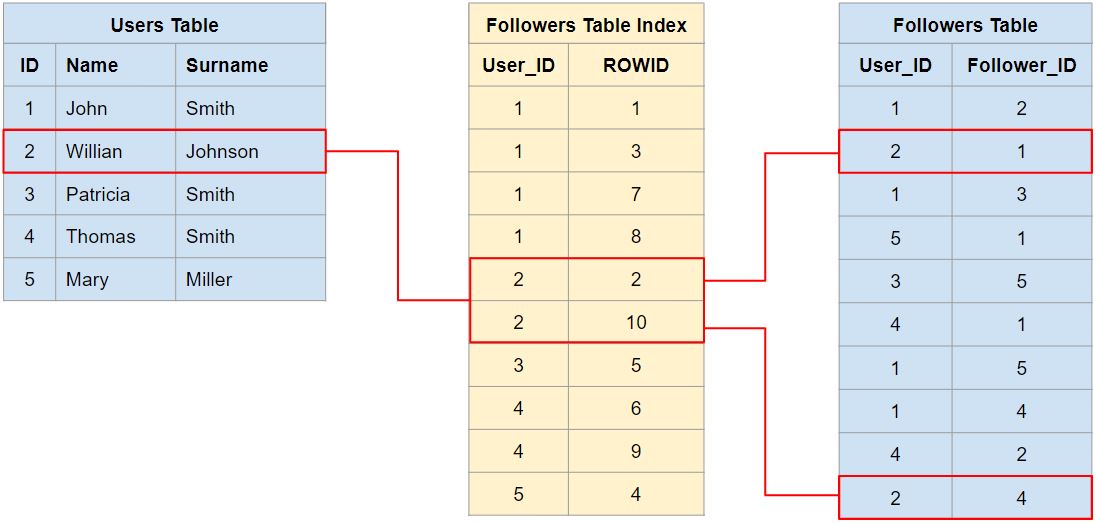
В чем же проблема такого подхода? А все на самом деле просто. Каждый проход от пользователя к пользователю это дополнительных hop через глобальный индекс. Логарифмически это можно выразить формулой O(n log n) где n - глобальное количество узлов в графе. Очевидно, что при большом количестве связей и глубины поиска этот алгоритм начнет работать медленно.
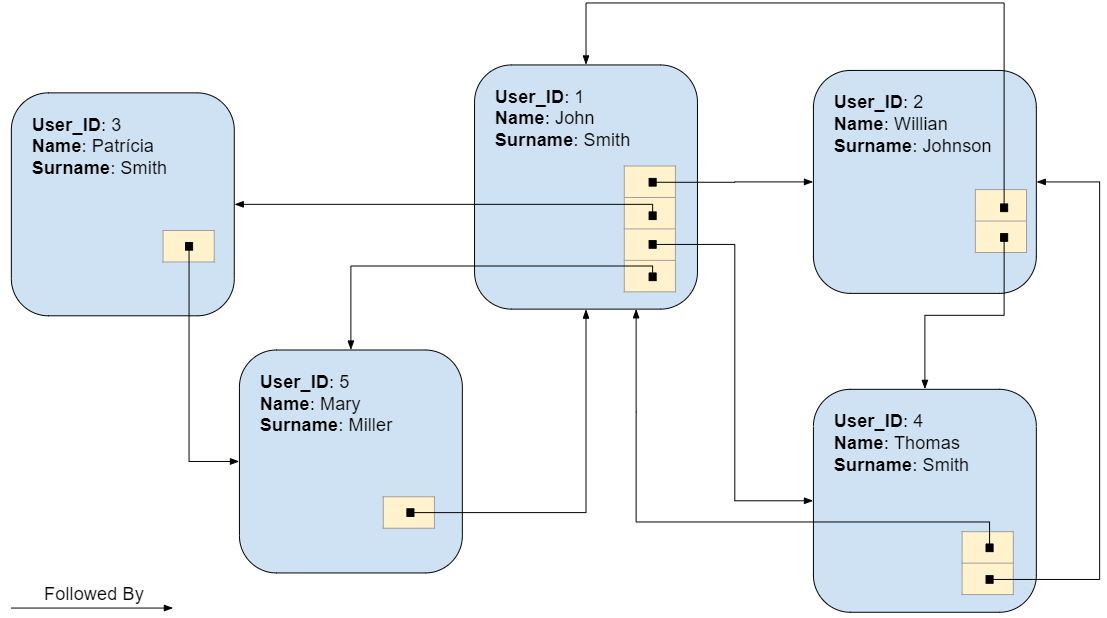
Neo4j представила свою структуру данных для решения этой проблемы. И называется он Index-free. Идея хранить ребра(указатели на соседние узлы) совместно с узлами и тем самым добиваться O(n).
Trade-Offs
| Преимущества | Недостатки |
|---|---|
| Это по настоящему работает быстро с графами умеренного размера | Начинает не давать желаемого эффекта когда объем данных превышает размеры оперативной памяти. Даже скорее проигрывает. Глобальный индекс будет занимать места меньше чем все узлы в графе. |
| Такую структуру очень сложно шардировать (непонятно как кластеризовать) | |
| Удаление перегруженных связями графов становиться дорогой задачей |
Заключение
Я рассказал далеко не о всех структурах данных. К примеру у тех же графовых баз данных есть и других алгоритмы поиска по графу и в частности те которые позволяют шардироваться (не без потери производительности).