Партиционирование
Следующая интересная тема которую нам предстаит рассмотреть это партиционирование. Когда объем данных и нагрузки на систему растут и репликация не спасает. Придется взять на вооружение партиционирование. Партиционирование это общий термин, означающий что мы каким то образом распределяем данные в системе на некоторое количество кусочков. Такое разбиение может быть на одном сервере, так и на нескольких. Мы же рассмотрим партиционирование только как часть горизонтального масштабирования.
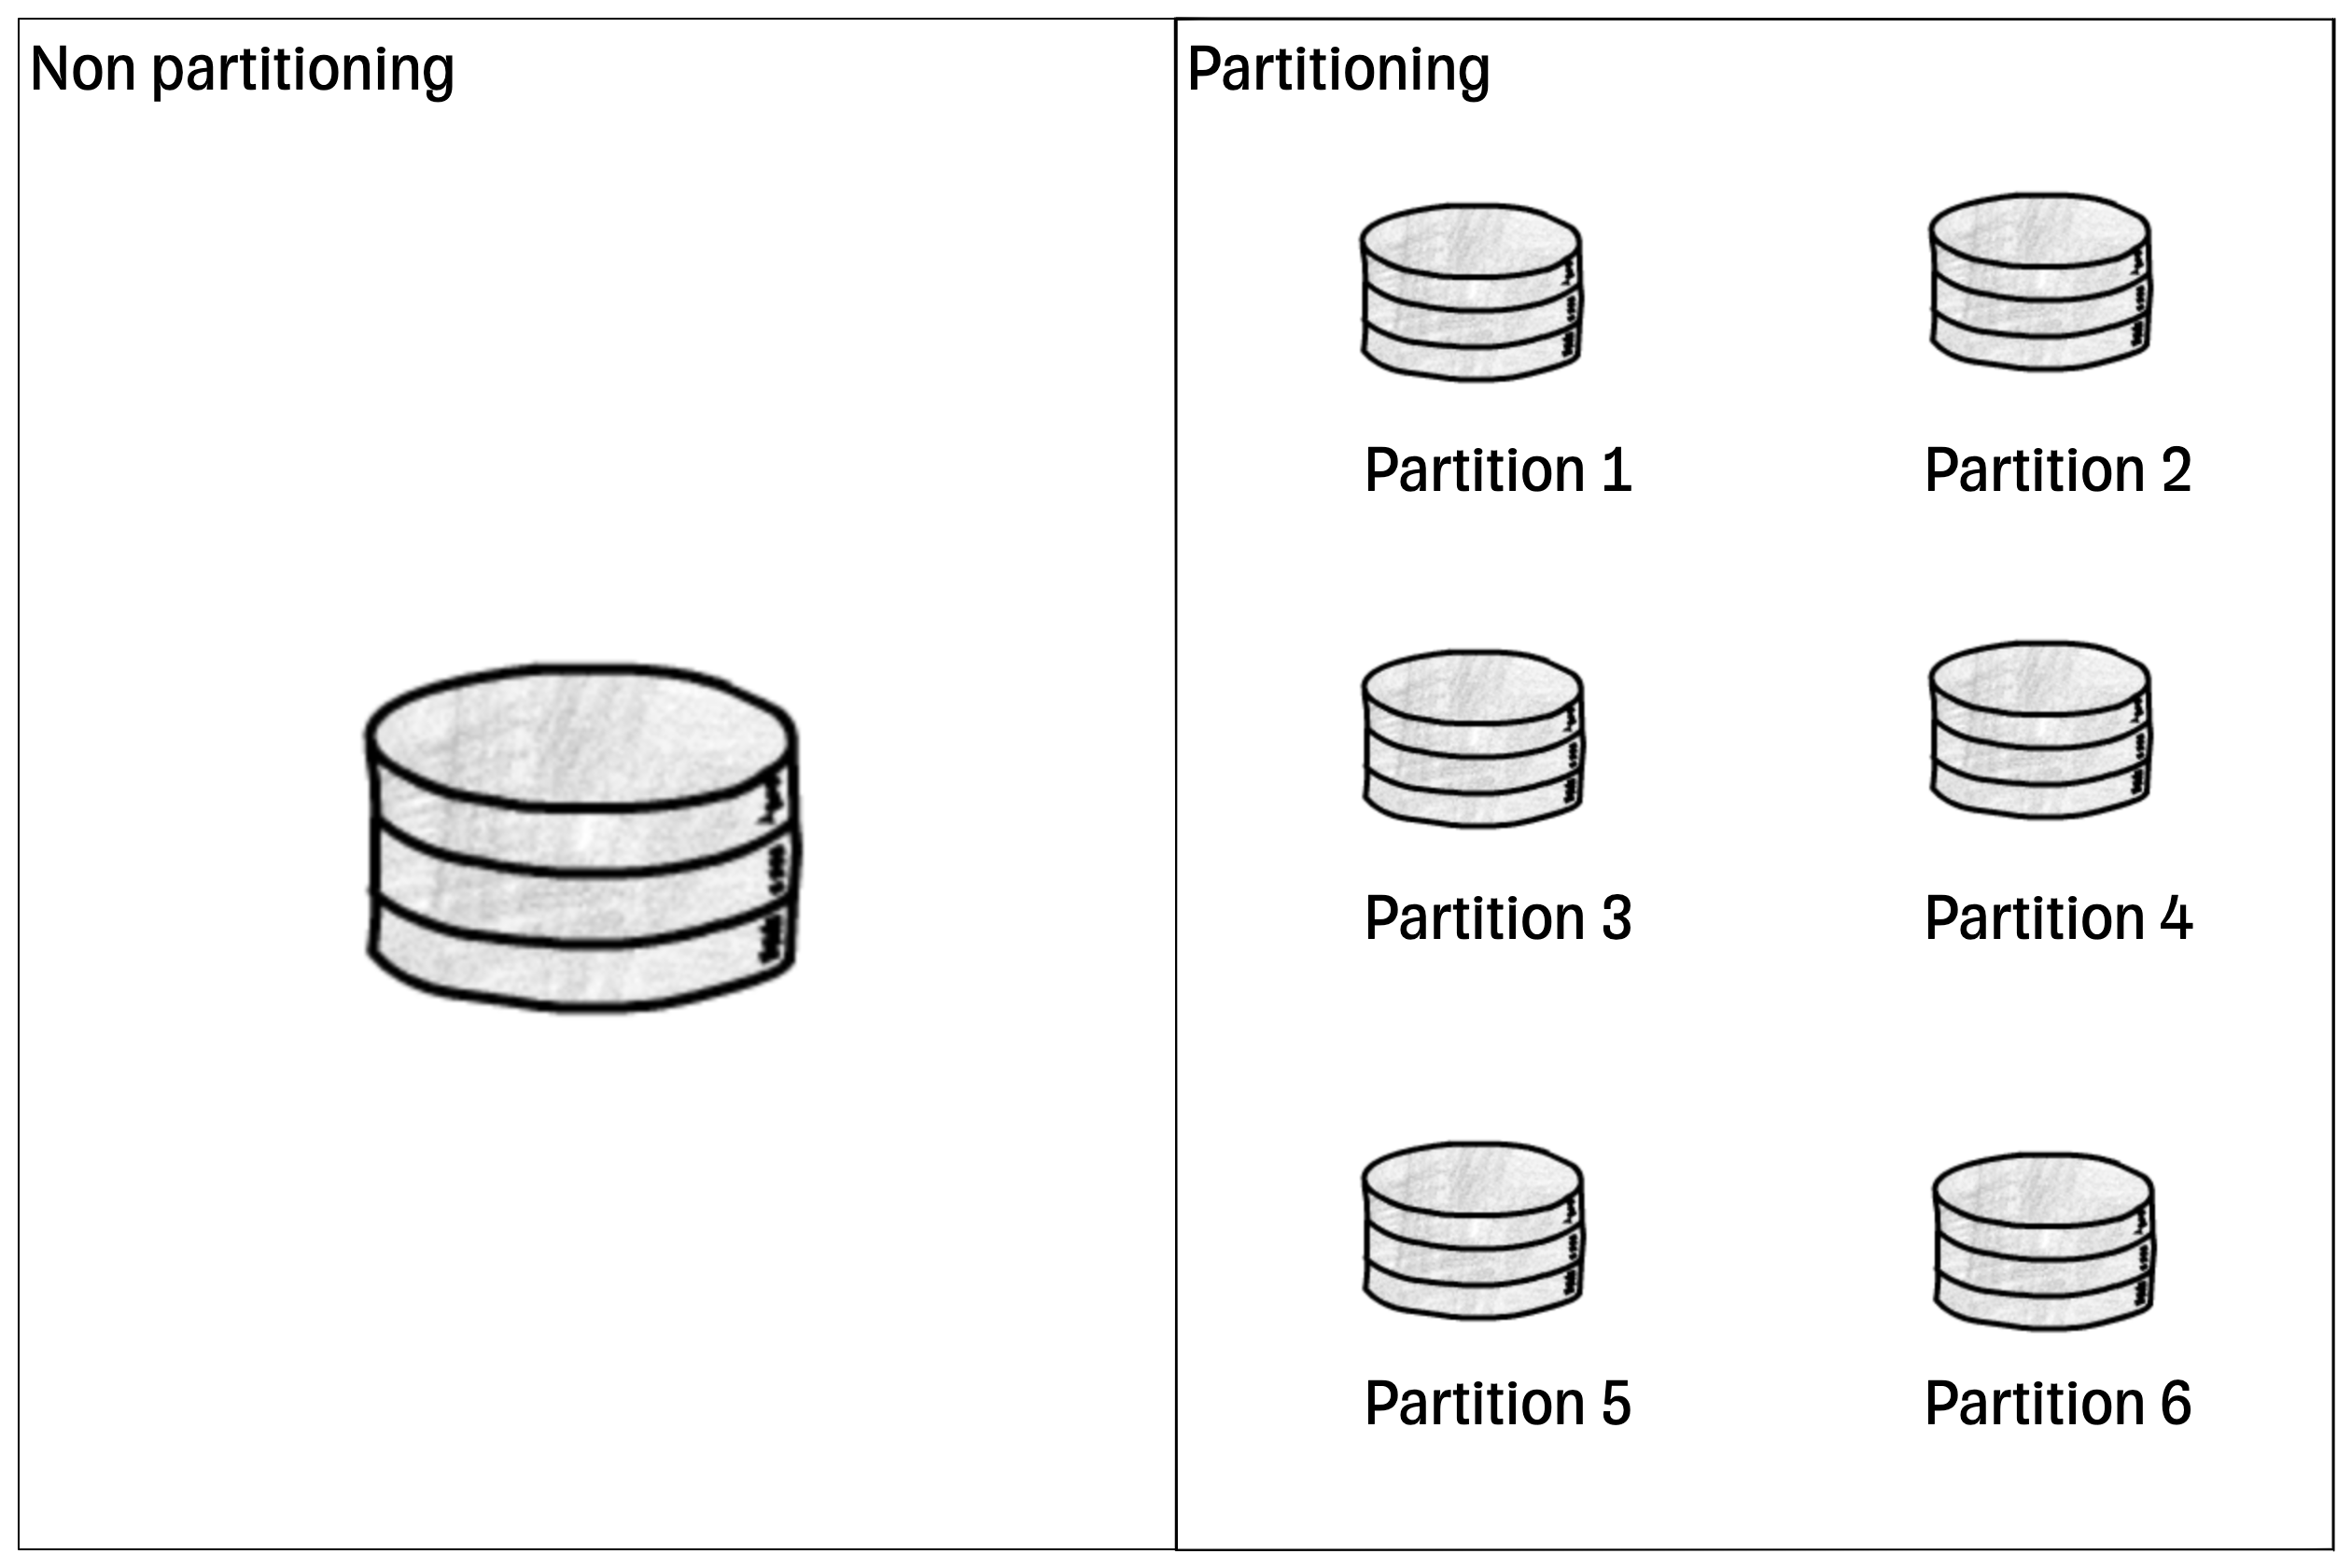
Существует несколько причин для партиционирования:
- Улучшение масштабируемости.
- Улучшение производительности записи/чтения
- Улучшение безопастности. Данные требующие больший контроль безопастности могут распологаться на выделенных серверах, защищенных алгаритмами шифрования
- Улучшение доступности. Выход из строя одной партиции не повлияет на другие.
Наиболее часто выделяют три подтипа партиционировани: горизонтальное партиционирование (часто называемое шардированием), вертикальное партиционирование, функциональное партиционирование (Федерация). Давайте рассмотрим каждый подтип детальнее.
Функциональное партиционирование
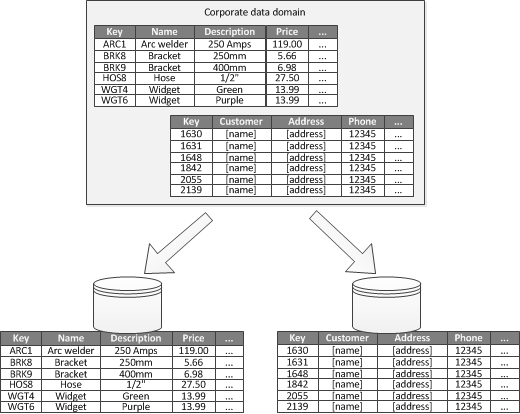
Функциональное партиционирование — это стратегия повышения изоляции и скорости доступа к данным, когда можно определить ограниченный контекст для каждой отдельной бизнес-области в приложении. Отделение данных для чтения и записи от данных, доступных только для чтения, является еще одним известным применением функционального партиционирования.
На рисунке ниже показан пример функционального партиционирования, в котором данные о запасах изолированы от данных о клиентах.
Trade-Offs
| Преимущества | Недостатки |
|---|---|
| Улучшение масштабируемости за счет разнесение данных по разным узлам системы | Федерация неэффективна, если ваша схема требует огромных функций или таблиц. |
| Улучшается производительность за счет линейного увеличения ресурсов | Вам потребуется обновить логику приложения, чтобы определить, откуда читать данные и куда их писать. |
| Повышается отказоустойчивость. Выход из строя одной части, не повлияет на другую | Объединение данных из двух источников данных становится более сложной задачей, чем из одного |
| Размер индекса также уменьшается, что обычно повышает производительность при более быстрых запросах | Федерация добавляет больше оборудования и дополнительную сложность. |
Ссылки:
Вертикальное партиционирование
Наиболее типичным применением вертикального партиционирования является снижение затрат на ввод-вывод и производительность при извлечении часто запрашиваемых объектов.
В примере ниже различные атрибуты объекта хранятся в разных разделах. В одном разделе хранятся часто используемые данные, такие как название продукта, описание и цена. Количество запасов и дата последнего заказа хранятся в другом разделе.
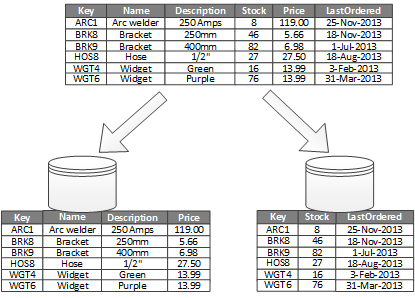
Показывая потребителям данные о продукте, приложение периодически запрашивает название, описание и цену продукта. С другой стороны, количество запасов и дата последнего заказа хранятся в отдельном разделе, поскольку они часто используются вместе.
На самом деле вертикальное партиционирование в полной мере используется в based-column базах данных.
Trade-Offs
| Преимущества | Недостатки |
|---|---|
| Относительно медленно меняющиеся данные можно отделить от более динамичных данных. Медленно перемещающиеся данные являются хорошим кандидатом для кэширования приложения в памяти. | |
Конфиденциальные данные могут храниться в отдельном разделе с дополнительным контролем безопасности. | |
| Вертикальное партиционирование может снизить количество конкурентных обращений к данным. |
Горизонтальное партиционирование
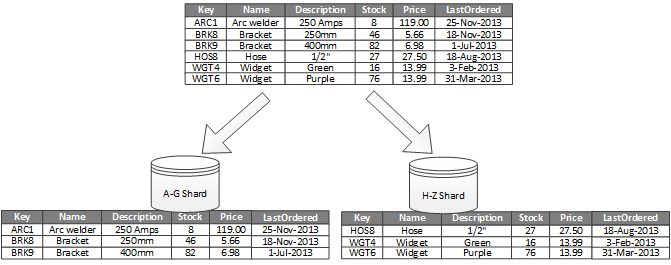
В этой стратегии каждый раздел представляет собой отдельное хранилище данных, но все разделы имеют одну и ту же схему. Здесь каждый раздел называется шардом, который содержит определенный подмножество данных.
Методы партиционирования
Выбор ключа партиционирования является очень важной частью эффективного распределение нагрузки.
Цель горизонтального партиционирования — равномерно распределить по узлам данные и/или загрузку по запросам.
Если же партиционирование выполнено неравномерно то оно называется асимметричным (skewed). Наличие асимметрии существенно снижает эффективность партиционирования. В предельном случае вся нагрузка ляжет на одну партицию, так что девять из десяти узлов будут простаивать, а узким местом окажется единственный функционирующий узел. Партиция с непропорционально высокой нагрузкой называется горячей точкой (hot spot).
Хеш-партиционирование (hash partitioning)
данные разбиваются на шарды на основе хеш-функции, которая принимает входные данные и возвращает хеш-значение. Это значение определяет, в какой шард будет помещена каждая запись данных. Метод позволяет достичь высокой производительности и отсутствия единой точки отказа, однако усложняет поиск данных.

Trade-Offs
| Преимущества | Недостатки |
|---|---|
| Самый производительный метод партиционирования | Работает только с простыми запросами. Доступ по ключу партиционирования |
Партицонирование по диапазонам значений (range partitioning)
Данные разбиваются на шарды на основе диапазона значений. Значения могут присваиваться с помощью ключей (ключевое шардирование) и других атрибутов. Метод прост в реализации и позволяет быстрее находить информацию, чем при хешировании, однако может привести к несбалансированности системы (часть системы будет утилизироваться больше чем другая).

Trade-Offs
| Преимущества | Недостатки |
|---|---|
| Партиционирование на основе диапазона поддерживает более эффективные запросы диапазона. Учитывая запрос диапазона по ключу сегмента, маршрутизатор запросов может легко определить, какие фрагменты перекрывают этот диапазон, и направить запрос только к тем сегментам, которые содержат эти фрагменты. | Однако партиционирование на основе диапазона может привести к неравномерному распределению данных, что может привести к наличию горячих точек. |
Trade-Offs
| Преимущества | Недостатки |
|---|---|
Преодоление технического ограничения. Набирающие популярность продукты в итоге сталкиваются с потолком возможностей оборудования, и данные могут быть разделены по разным машинам, чтобы обеспечить возможность роста. | Сложность реализации. Ошибки при шардировании могут стоить части данных или привести к повреждению хранилища. Также при разделении возникает риск того, что команда разработчиков будет работать менее эффективно. Вместо единой точки входа им придется управлять данными из нескольких сегментов. |
Повышение надежности. Если шарды данных физически находятся на разных серверах, то отказ одного из них не означает прекращение работы остальных. То есть вместо полного прекращения доступа к сайту или приложению может перестать работать лишь какая-то его часть. | Несбалансированность данных. Иногда бывает трудно предугадать, как будут накапливаться данные, и какой-то сервер может оказаться более загруженным, чем остальные. Например, какая-то часть пользователей соцсети стала гораздо популярнее всех остальных, а связанные с ними данные концентрируются на одном сервере. Для решения приходится прибегать к повторному сегментированию, но это приводит к простою серверов. |
Ускорение доступа к данным. Продукты с большой монолитной системой обработки данных обычно не отличаются производительностью, так как запросы к ним конкурируют друг с другом. Шардирование помогает распределить нагрузку, увеличить объемы и скорость обработки данных. | Потеря производительности при сложных запросах. Запрос одновременно к нескольким шардам будет иметь повышенную задержку. Для получения данных нужно будет обратиться к нескольким сегментам одновременно, что гораздо медленнее, чем получить данные из одной таблицы. |
Ссылки
- The coming of the shard
- Shard database architecture
- Consistent hashing
- Horizontal, vertical, and functional data partitioning
Вторичные индексы
Все, что мы обсуждали до этого момента касалось только партиционирования по ключу. Однако, мы понимаем, что огромная часть запросов работает как раз не по первичному ключу, а по вторичным индексам. Как же нам работать с вторичными индексами в условиях шардирования? Существует два подхода в хранению вторичных индексов: локальное индексы и глобальные индексы.
Локальные индексы
Представим, что у нас есть сайт продажи автомобилей. Мы партиционируем нашу систему обработки данных по производителю. Каждая партиция содержит перечень автомобилей конкретного производителя. Используя локальные индексы мы можем построить индекс по производителю в этом конкретном шарде. То есть данные и вторичный индекс хранятся локально друг к другу. Поэтому такие индексы и называются локальными. Теперь после того как мы определелили производителя, мы можем выбрать цвет автомобиля.
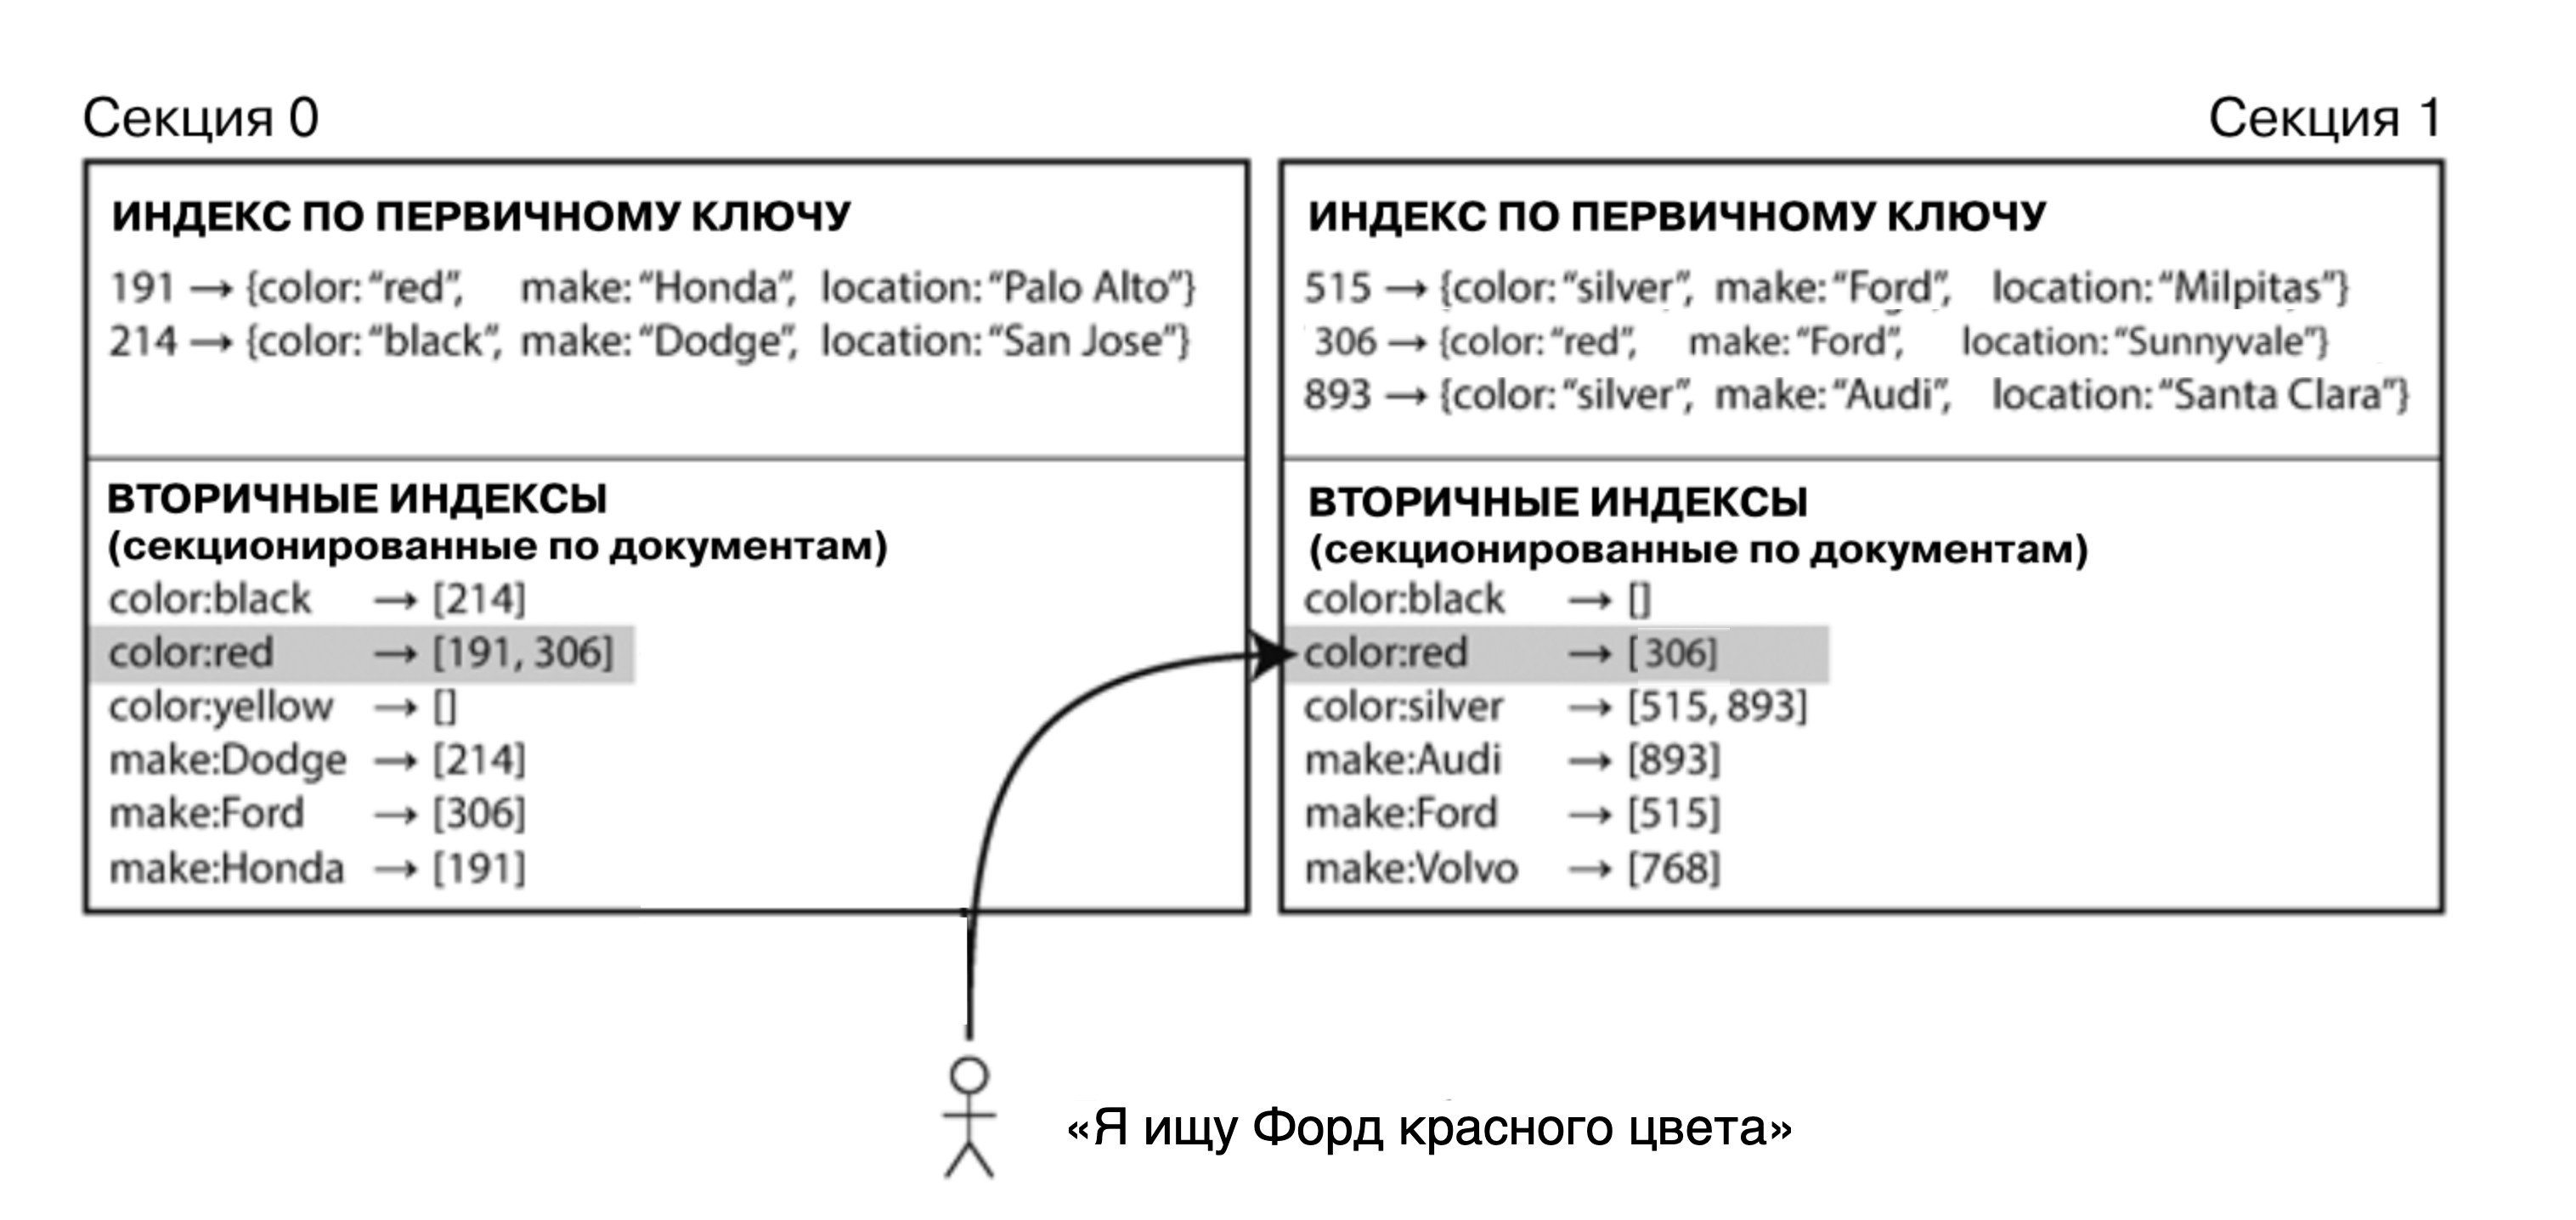
Но, что будет если мы хотим дать возможность задавать цвет автомобиля до выбора какого-либо парамента? Нам бы пришлось пойти в каждый шард и спросить у него автомобили нужного цвета.
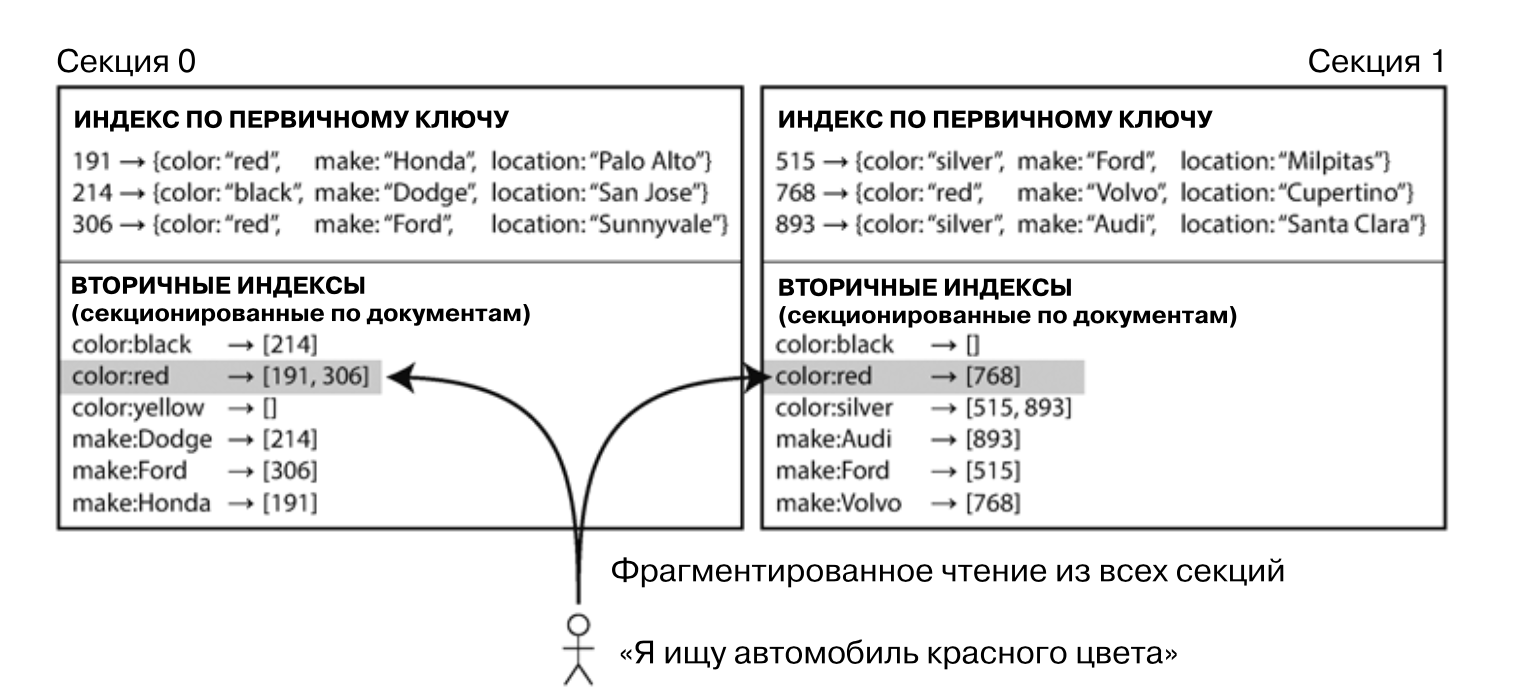
Такие запросы называются фрагментированными и являются затратными для поиска. В большом количестве систем обработки данных такие запросы запрещены по умолчанию и могут быть признаком плохого дизайна (исключением могут буть поисковые движки, но об этом чуть позже)
Trade-Offs
| Преимущества | Недостатки |
|---|---|
| Быстро работают. Не требуется ждать ответа от всех узлов в кластере. | Работает только с локальными для шарда данными. |
| Низкая стоимость обновления. Обновление происходит внутри одного узла. | |
Глобальные индексы
Вместо отдельного вторичного индекса для каждой партиции (локальные индексы) можно сконструировать глобальный индекс, охватывающий данные из всех партиций. Однако такой индекс нельзя хранить в одном узле, иначе он превратится в узкое место и сведет на нет все выгоды от горизонтального партиционирования. Глобальный индекс тоже нужно партиционировать и все знания для этого у нас уже есть.
Давайте партиционируем по диапозонам ключей. Разместим в первой партиции значения цвета начинающиеся с буквы A заканчичающиеся R во вторую от S до Z.
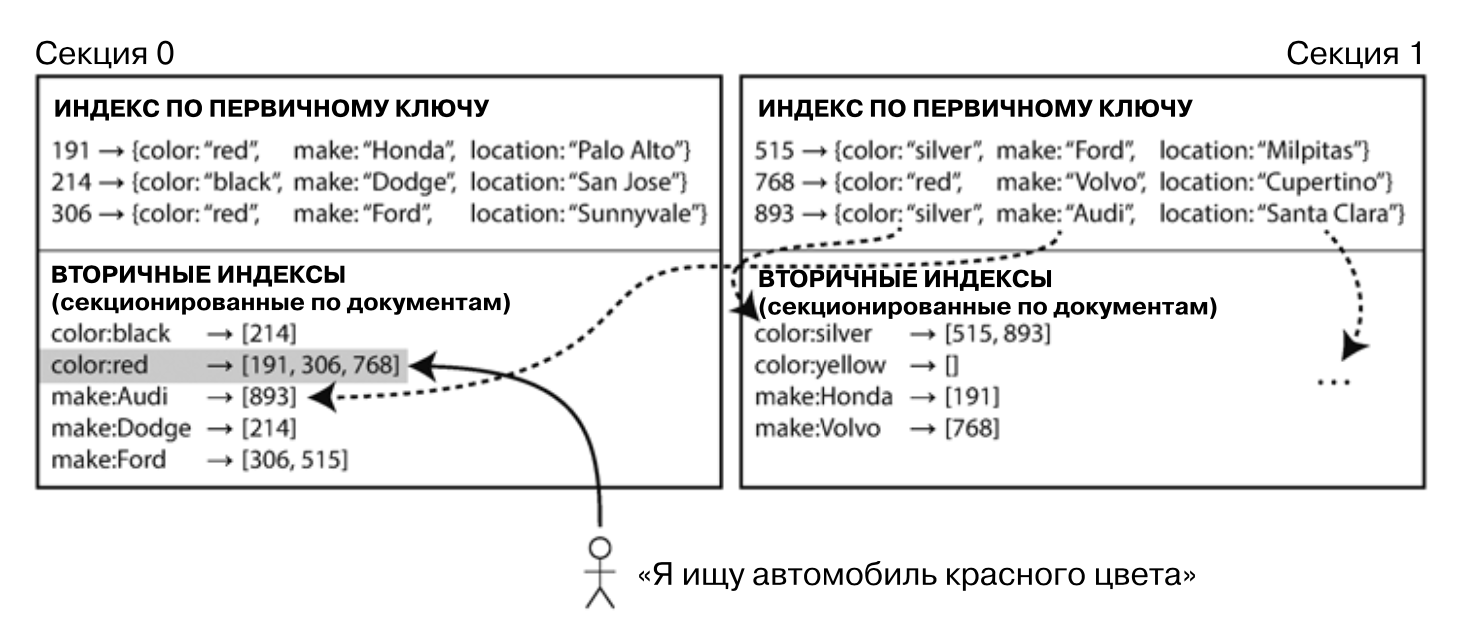
Теперь мы можем эффективно искать все автомобили по цветам. Главная проблема которая перед нами встаёт "как транзакционно обновлять данные в разных шардах". И обычно ответ на этот вопрос "Никак". Производители распределённых систем обработки данных чаще всего обновляют такие индексы асинхронно, что может привести к чтению старых данных.
Trade-Offs
| Преимущества | Недостатки |
|---|---|
| Поиск не привязан к первичному ключу партиционирования | Как правило это асинхронное обновление вторичного индекса |
Фрагментированное чтение
Как я уже упоминал совсем отказаться от фрагментированного чтения невозможно. Поисковые движки устроены так, чтобы отдать корректный ответ на разного рода поисковые запросы. Такие запросы обычно содержат большое количество предикатов, что делает использование глобальных индексов невозможным (мы просто не можем партиционировать по одному ключу, у нас много ключей). Таким образом поисковые движки (такие как Solr, ElasticSearch) используют локальные индексы и фрагменрированное чтение.
Trade-Offs
| Преимущества | Недостатки |
|---|---|
| Возможность искать по сложным запросам которые не возможно реализовать глобальным индексом | Т.к. приходится ждать ответа от всех узлов в кластере, поиск будет медленнее чем у локального и глобального индексов |
| Дорого в ресурсах. Каждый запрос передается на каждый узел в кластере тем самым мы получаем в N раз запросов больше чем в локальных индексах, где N число узлов в кластере. | |
Ре-партиционирование
На первый взгляд может показаться, что ре-партиционирование давольно простая задача. Но давайте разберемся, так ли это.
Представим, что у нас 10 узлов. Нагрузка выросла так, что приходится добавлять новый узел (аналогичная ситуация с выводом узла из эксплуатации). Что произойдёт?
Решение в лоб
Используем остаток от деление ключа Hash(key) mod N. Где N число партиций.
Проблема с методом mod N состоит в том, что при изменении количества N узлов придется перенести большинство ключей из одного узла в другой. Например, допустим, hash(key) = 123456. Если изначально у нас десять узлов, то этот ключ окажется в узле номер 6 (поскольку 123456 mod 10 = 6). Когда система вырастет до 11 узлов, этот ключ придется перенести в узел 3 (поскольку 123456 mod 11 = 3), а когда вырастет до 12 — в узел 0 (поскольку 123456 mod 12 = 0). Такие частые перемещения делают перебалансировку очень дорогим удовольствием.
Фиксированное количество партиций
К счастью, существует очень простое решение: создать намного больше партиций, чем узлов в системе, и распределить по нескольку партиций на каждый узел. Например, можно разбить работающую на кластере из десяти узлов систему обработки данных на 1000 партиций из расчета по 100 партиций на каждый узел.
Тогда добавляемый в кластер новый узел может «позаимствовать» по нескольку партиций у каждого из существующих узлов на время, до тех пор пока партиции не станут снова распределены равномерно. При удалении узла из кластера выполняется обратный процесс.
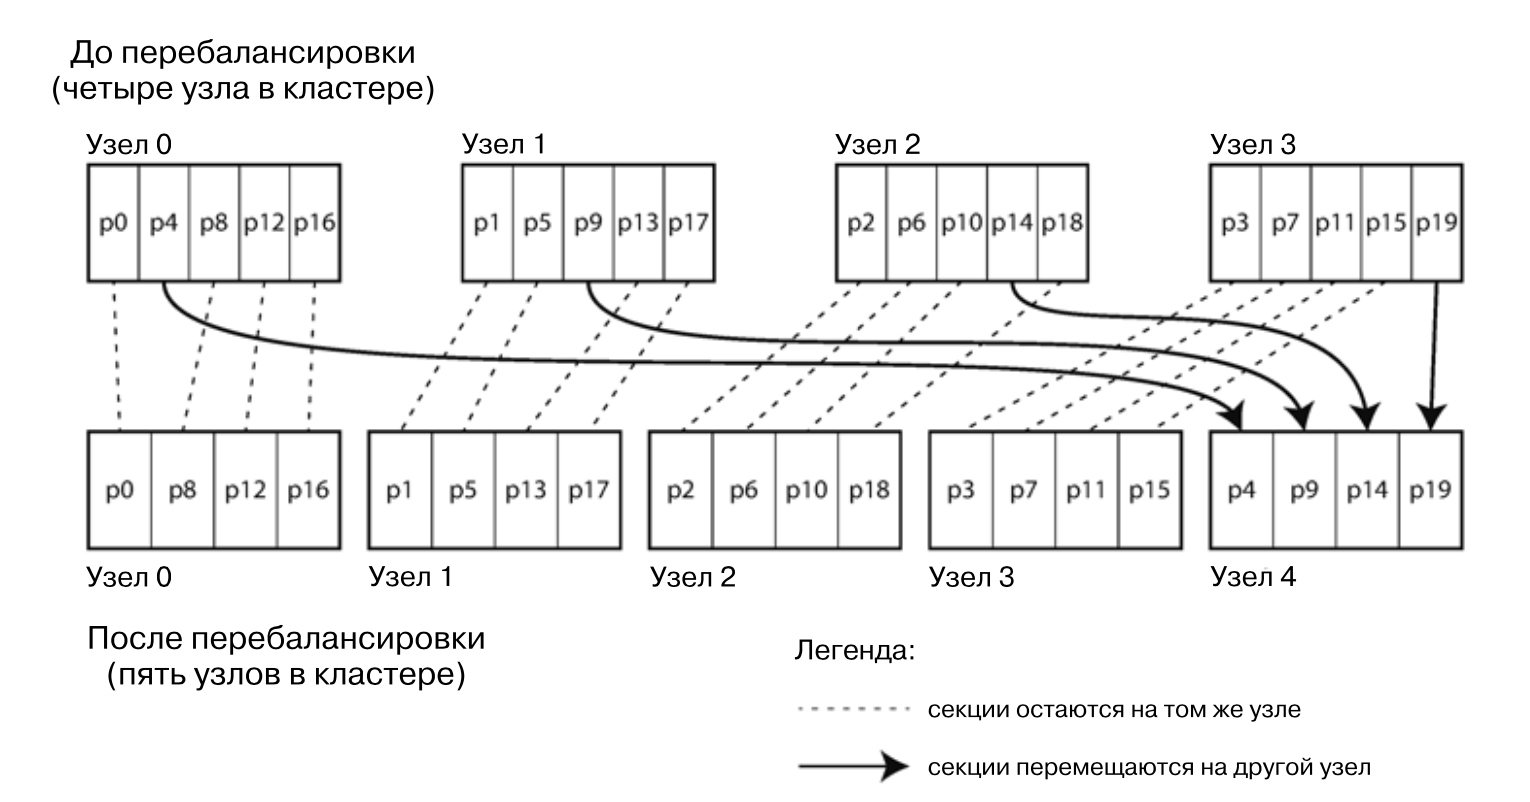
Между узлами перемещаются только партиции целиком. Количество последних не меняется, как и соответствие ключи партиций. Единственное, что меняется, - распределение партиций по узлам.
Проблемы которые придется столкнуться
Мы партиционировали набор данных по нескольким узлам на ряде машин. Но остается открытым следующий вопрос: откуда клиент, выполняющий запрос, знает, к какому узлу ему нужно подключиться? При перебалансировке партиций распределение их по узлам меняется.
Для решения этой проблемы можно выделить три основных подхода:
- Table Function. При этом подходе мы храним сопоставление наших партиций узлам.
- Consistent hashing - это схема распределенного хеширования, которая работает независимо от количества серверов или объектов в распределенной хеш-таблице, назначая им позицию в абстрактном круге или хеш-кольце. Это позволяет серверам и объектам масштабироваться, не влияя на систему в целом.
- Rendezvous hashing или наибольшего случайного веса — это алгоритм, который позволяет клиентам достигать распределенного соглашения по набору вариантов из возможного набора параметров.
На самом деле исследований в этом направлении много и постоянно появляются новые алгоритмы имеющие свои преимущества и недостатки. Серебрянной пули пока нет. Изучение алгоритмов я оставлю на самостоятельное работу)
Ссылки: