Модели согласованности
При изучении репликации я сознательно опустил модели согласованности. Настало время вернуться к этому вопросу.
Если посмотреть на два узла распределенной системы обработки данных в один и тот же момент времени, то, скорее всего, можно увидеть в них различные данные, потому что запросы на запись поступают на разные узлы в разное время. Эти несоответствия возникают независимо от используемого в системе метода репликации.
В этом разделе мы разберем наиболее интересные для нас модели согласованности. Начнем мы с более слабой модели согласованности, а закончим моделью строгой согласованности (линеаризуемостью).
Согласованность в конечном счёте (eventual consistency)
Большинство реплицированных систем обработки данных обеспечивают по меньшей мере конечную согласованность. Это означает, что если прекратить записывать данные в систему и подождать некоторое неопределенное время, то в конце концов все запросы на чтение вернут одно и то же значение. Другими словами, несогласованность является временной и в конечном итоге устраняется сама собой (при условии устранения в итоге и всех неисправностей в сети)
Однако это очень слабая гарантия. Она ничего не говорит о том, когда именно реплики сойдутся. До момента конвергенции операции чтения могут возвращать что угодно или вообще ничего. Например, если вы запишете значение и сразу же прочтете его снова, то нет никакой гарантии, что увидите то же значение, которое написали, поскольку чтение может быть.
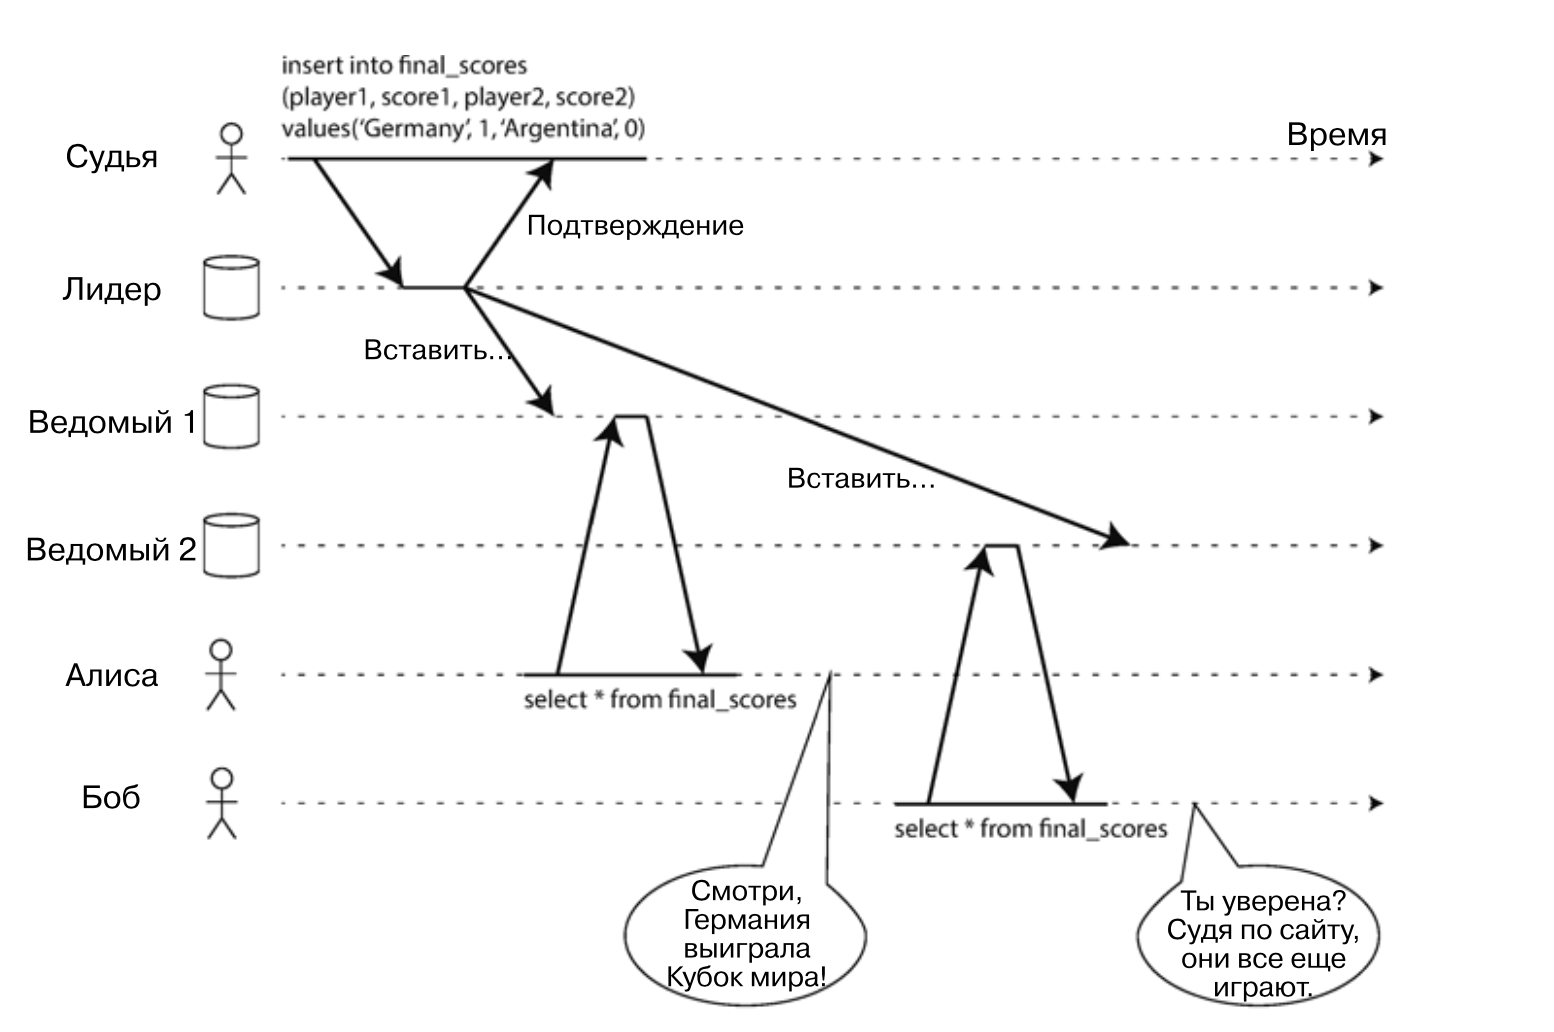
В качестве примера конечной слогласованности можно представить систему с одним ведущим узлом и с асинхронной репликацией. Чтение с реплик в такой системе будет согласованно в конечном счете. Проще всего это рассмотреть на примере.
Алиса и Боб сидят в одной комнате и смотрят на телефоны, чтобы узнать результат финала Кубка мира по футболу 2014 года. Как только объявлен окончательный результат, Алиса обновляет страницу, видит победителя и взволнованно рассказывает об этом Бобу. Боб недоверчиво перезагружает страницу на своем телефоне, но его запрос попадает на реплику данных, на которой случилась задержка, и поэтому его телефон показывает, что игра все еще продолжается.
Факт возврата старого результата на запрос Боба является нарушением модели строгой слогласованноси, но прекрастно демонстрирует согласованность в конечном счёте.
Trade-Offs
| Преимущества | Недостатки |
|---|---|
| Производительность системы на запись. Не нужно согласовывать значение на всех репликах | На примере Алисы и Боба мы видим, что пользовательский опыт может страдать |
| Чтение старых данных, например, недопустимо в финансовой сфере. Платежная операция не может полагаться на устаревший баланс. |
Строгая согласованность
В основе линеаризуемости лежит простая идея: снаружи система должна вести себя так, как если бы в ней существовала только одна копия данных. Однако для понимания того, что именно это означает в действительности, нужно немного поразмыслить. Для большего погружения в смысл линеаризуемости рассмотрим еще несколько примеров.
На рисунке ниже изображено как клиенты конкурентно просматривают и записывают реестр.
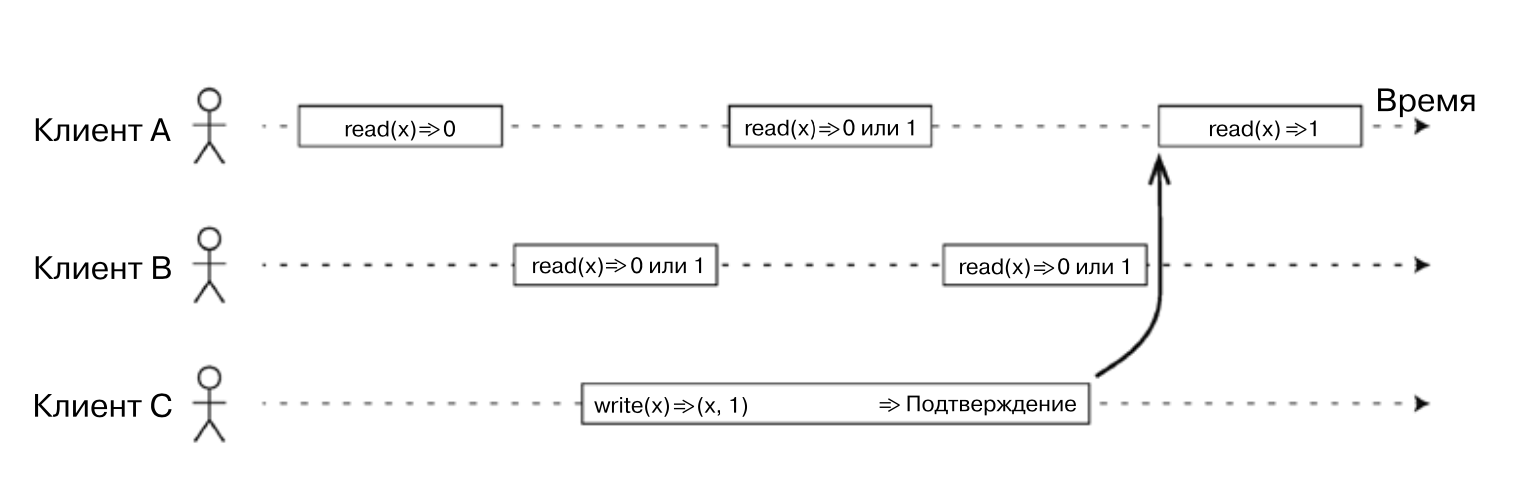
Каждая шкала — сделанный клиентом запрос; начало ее соответствует времени, когда клиент отправил запрос, а конец — когда получил ответ. Из-за различных задержек в сети клиент не знает точно, когда система обрабатывала его запрос. Он лишь знает, что это произошло где-то между отправкой запроса и получением ответа.
На рассмотренном рисунке значение регистра x первоначально равно 0. Клиент C выполняет запрос на запись с целью присвоить ему значение 1. Пока это происходит, клиенты A и B несколько раз опросили систему данных, чтобы узнать последнее значение. Какие ответы могут получить A и B для своих запросов на чтение?
Первая операция чтения клиентом A завершается до начала записи, поэтому она обязательно вернет старое значение 0.
Последняя операция чтения клиента А начинается после завершения записи, поэтому в случае линеаризуемости система обработки данных обязательно вернет новое значение 1
Все операции чтения, которые пересекаются во времени с операцией записи, могут возвращать либо 0, либо 1
Однако для полного описания линеаризуемости этого недостаточно: если операции чтения, конкурентные операции записи, могут возвращать либо старое, либо новое значение, то клиенты будут видеть значение, которое несколько раз меняется со старого на новое и обратно, пока длится запись. Система, эмулирующая «единственную копию данных», так работать не должна.
Чтобы сделать систему по настоящему линеаризуемой нужно ввести понятие хранометража. Если для одного клиента операция чтения вернула новое значение, то все последующие операции чтения тоже должны возвращать новое значение, даже если операция записи еще не завершена.
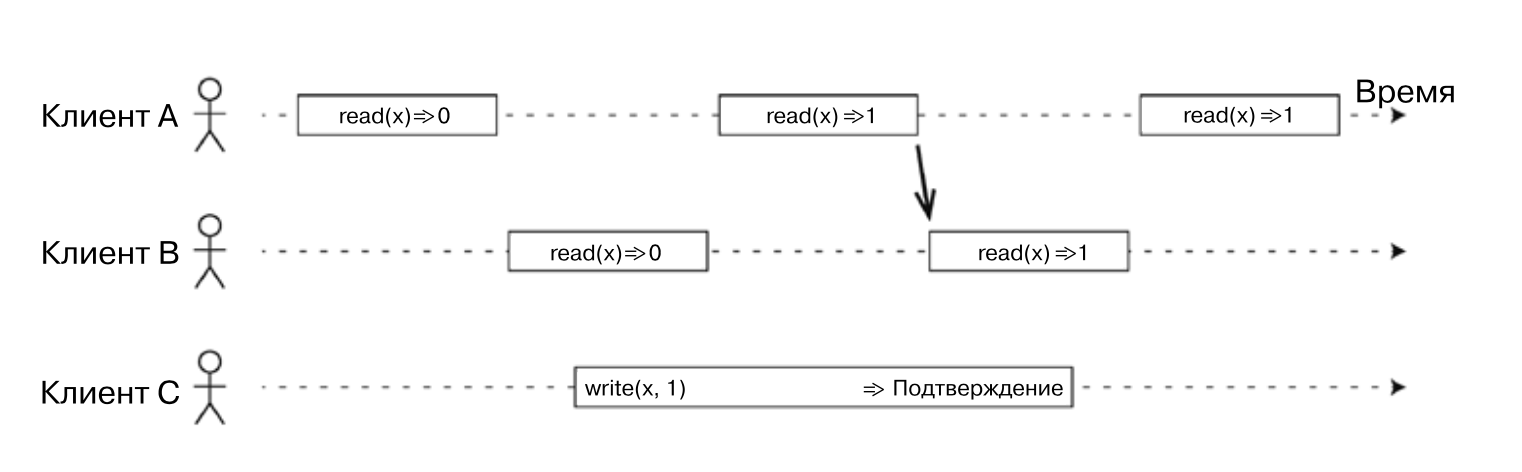
При соблюдении правила хранометража история Алисы и Боба уже не повторится. Как только Алиса узнала счет матча, Боб не может получить более старое значение.
Реализация линеаризуемых систем
Поскольку линеаризуемость, в сущности, означает «вести себя так, как будто существует только одна копия данных и все операции над ней являются атомарными», самым простым ответом было бы действительно использовать только одну такую копию. Однако этот вариант не позволяет справляться с отказами: если узел, содержащий единственную копию данных, претерпел сбой, то данные будут потеряны или по крайней мере недоступны до тех пор, пока узел не заработает снова.
Наиболее распространенным методом обеспечения отказоустойчивости системы является использование репликации.
Репликация с одним ведущим узлом
Потенциально линеаризуема. В системе с репликацией с одним ведущим узлом этот узел хранит основную копию данных, которые используются для записи на ведомые узлы. А синхронная репликация гарантирует, что данные будут тут же доступны на чтение с ведомого узла.
Репликация с несколькими ведущими узлами
Нелинеаризуемая. Такие системы как правило имеют асинхронную репликацию. При асинхронной репликации между ведущими узлами могут возникать конфликты конкурентных записей которые нужно как-то решать.
Репликация без ведущего узла
Не всегда линеаризуемая.
Наверное одна из интереснейших для меня тем. Я подробно не хотел расписывать эту тему, но неоднозначность понимания согласованности в Cassandra заставила меня подробно расписать эту тему.
Интуитивно кажется, что операции чтения и записи при строгом кворуме должны быть линеаризуемыми. Однако с учетом разновременных задержек в сети возможны условия гонки, как показано на рисунке ниже.
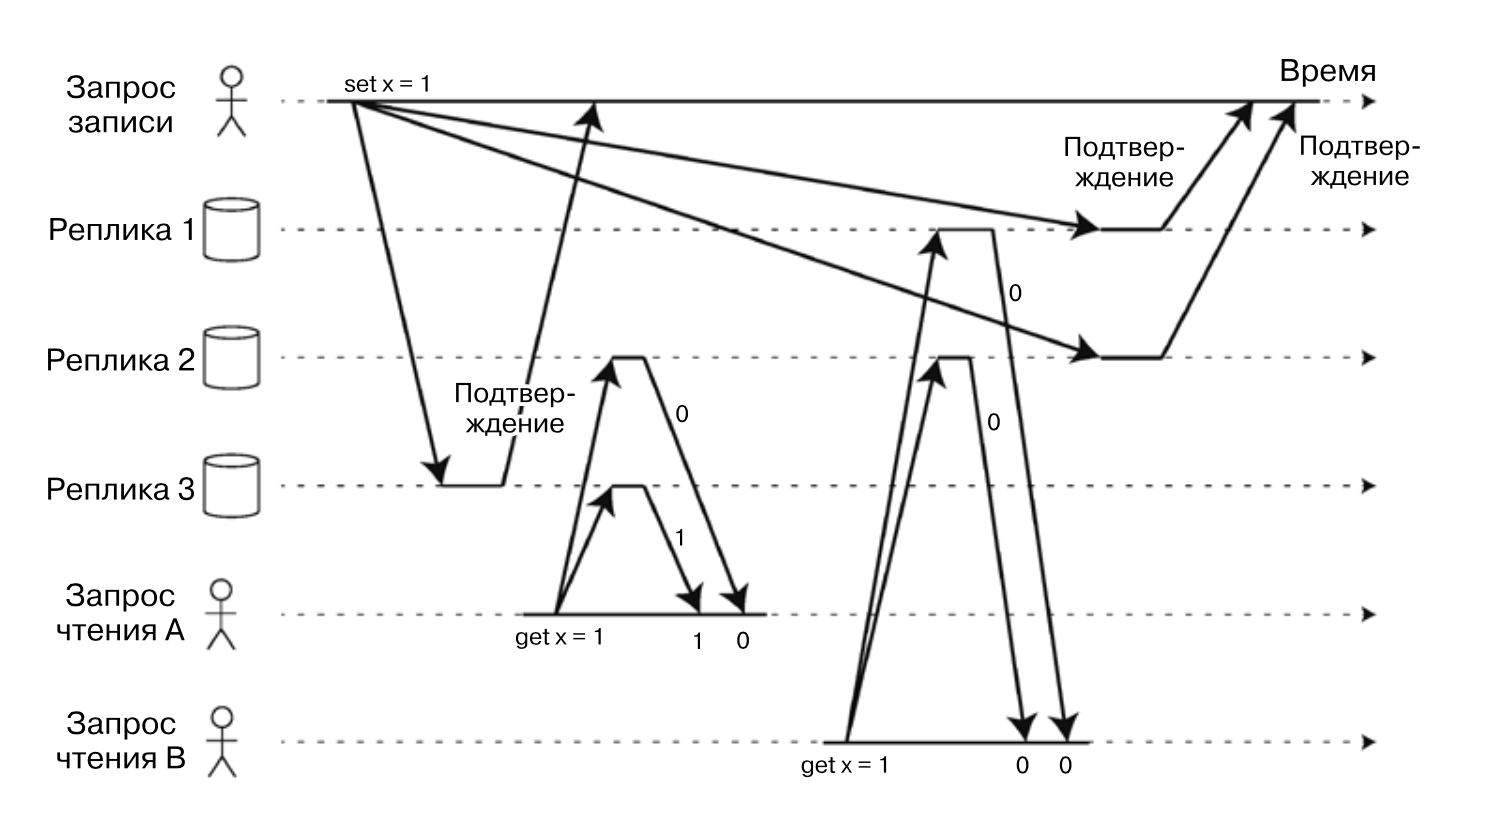
Начальное значение x равно 0 и клиент, инициирующий запись, обновляет x до 1, отправив запрос записи на все три реплики (n = 3, w = 3). В это же время клиент А считывает данные по кворуму (r = 2) и видит новое значение 1 на одном из них. Кроме того, одновременно с записью клиент B считывает данные из другого кворума, также состоящего из двух узлов, и получает из обоих старое значение 0.
Условие кворума выполнено (w + r > n), но эта операция тем не менее нелинеаризуема: запрос клиента B начинается после запроса клиента A, но клиент B получает старое значение, а клиент A — новое.
Интересно отметить, что:
- кворумы можно линеаризовать за счет снижения производительности: операция чтения должна выполнить синхронное разрешение конфликта чтения, прежде чем возвращать результат приложению.
- однако в случае нескольких конкурентных операций записи с одним ключом линеаризуемость теряется из-за разрешения конфликтов методом «выигрывает последний».
Эти два утверждения говорят нам о том, что Cassandra не линеаризуема. В лучшем случае она имеет гарантии сессионности. Т.е. она согласованна только для одного наблюдателя за раз. В случае нескольких наблюдателей может возникнуть конфликт записи, который будет решен методом «выигрывает последний».
Trade-Offs
| Преимущества | Недостатки |
|---|---|
| Такие системы понятнее для пользователя и разработчика | Существенным недостатком таких систем можно считать производительность и доступность |
Хорошо когда сеть работает, но, что будет при нарушении сетевого соединения между узлами репликации. Узлы уже не могут связаться друг с другом. Мастер не может отправить обновление реплике. Система становится не линеаризуемой. Если приложение требует линеаризуемого чтения и записи, то разрыв сетевого соединения приводит к тому, что приложение станет недоступным для чтения с ведомых узлов.
Теорема CAP
Эта проблема касается не только репликации с одним ведущим узлом, но и любой линеаризуемой системы обработки данных, независимо от того, как именно она реализована.
Пара компромиссов при работе с линеаризуемостью:
Если приложение требует линеаризуемости, а некоторые реплики не имеют доступа к другим репликам из-за проблем в сети, то эти реплики не могут обрабатывать запросы.
Если приложение не требует линеаризуемости, то оно может быть записано таким образом, чтобы каждая реплика могла обрабатывать запросы независимо, даже будучи отключенной от других реплик. Тогда приложение может оставаться доступным даже в случае проблем с сетью, но его поведение нелинеаризуемо.
Таким образом, приложения, не требующие линеаризуемости, более устойчивы к неполадкам в сети. Это представление широко известно как теорема CAP,
названная так Эриком Брюером в 2000г
Эрик, утверждает, что любое распределенное хранилище данных может обеспечить только две из следующих трех гарантий.
- Consistency. Every read receives the most recent write or an error.
- Каждое чтение получает самую последнюю запись или ошибку. По факту это означает линеаризуемость чтения и записи
- Availability. Every request receives a (non-error) response, without the guarantee that it contains the most recent write.
- Любой запрос к функционирующему узлу распределённой системы завершается корректным откликом, однако без гарантии, что ответ содержит наиболее актуальные данные
- Partition tolerance. The system continues to operate despite an arbitrary number of messages being dropped (or delayed) by the network between nodes.
- Система продолжает работать несмотря на то, что часть сообщений не доставлена или задержана между узлами
Обычно CAP теорему изображают в виде треугольника к вершинах которого находятся: Consistency, Availability, Partition tolerance.
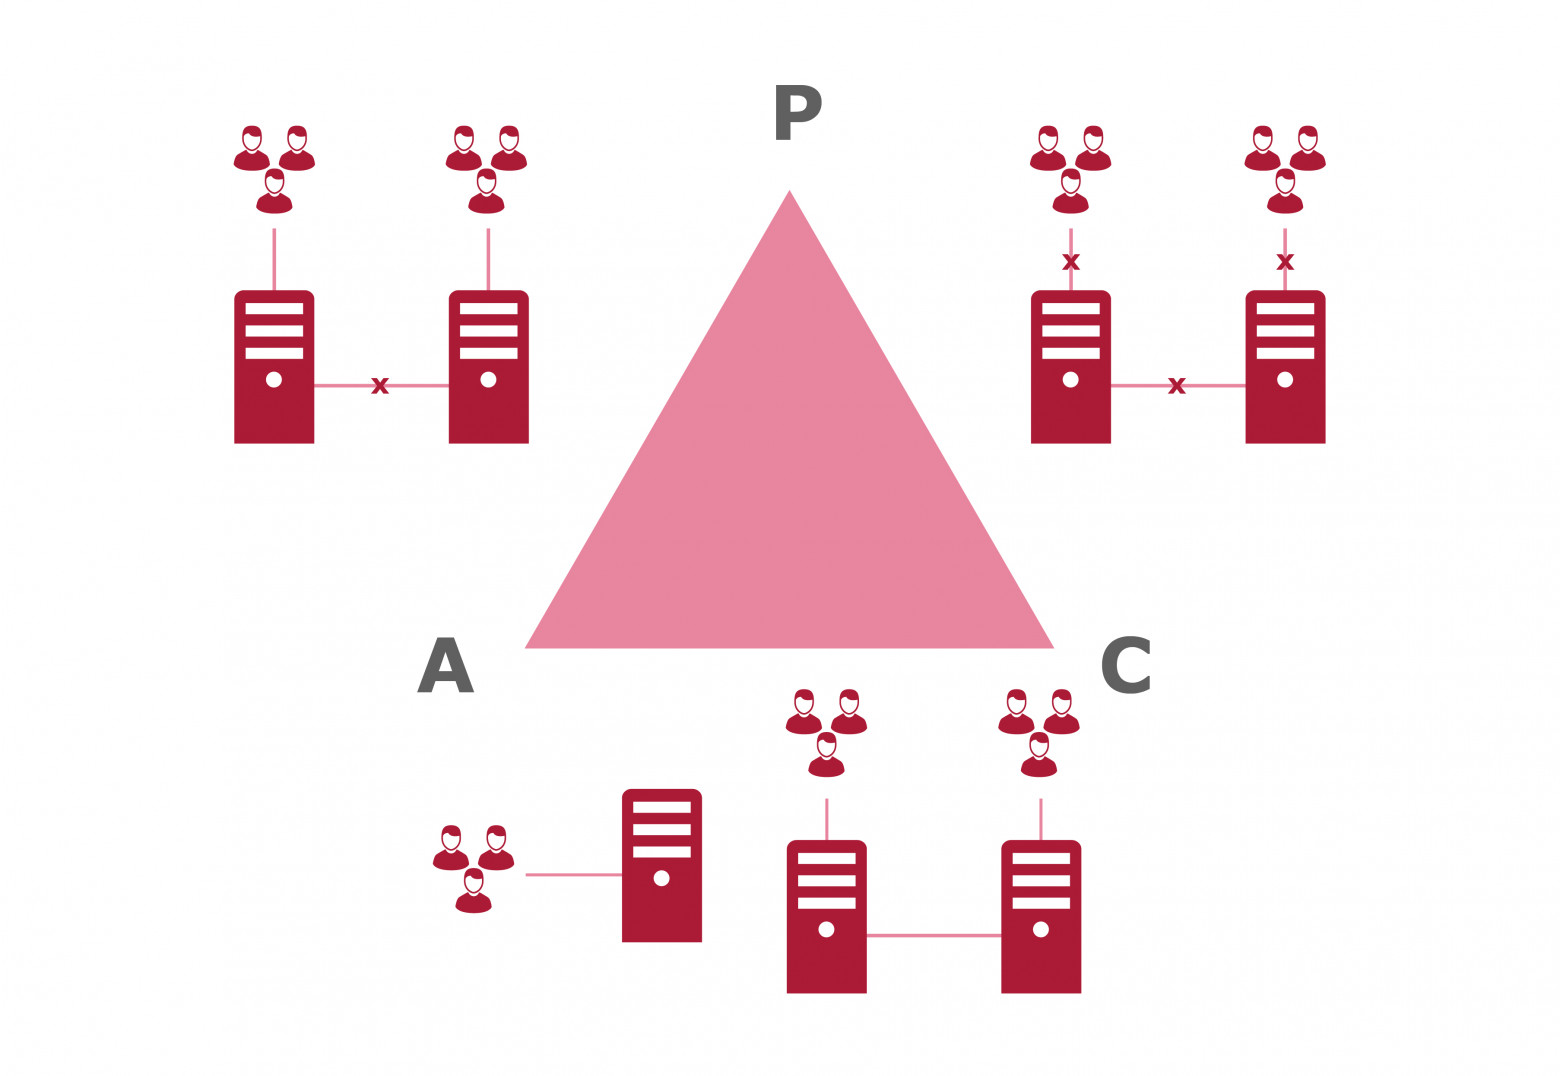
Грани CAP треугольника можно описать так:
- AP – в случае сетевого разделения узлов системы она продолжает отвечать пользователям на запросы, при этом не гарантируя консистентности данных.
- CP – в случае сетевого разделения узлов системы она прекращает отвечать пользователям на запросы, данные остаются консистентными.
- CA – в случае отсутствия сетевого разделения данные доступны и консистентны.
Критика теоремы
Есть две важных проблемы которые опускает теорема, а конкретно:
- Partition tolerance означает, что для связи используется асинхронная сеть, которая может терять или задерживать сообщения, что характерно для любой Интернет-системы. Поэтому создается ложное впечатление возможности настраивать параметр «P» в распределенных системах и рассматривать локальные хранилища данных в нерелевантном контексте.
- Availability ничего не говорит про временную задержку обработки данных (latency), при большом значении которой систему сложно назвать доступной на практике.
Критика показывает на несостоятельность CAP теоремы и ей на смету приходит теорема PACELC утверждающая, что способна решить несоответствия CAP теоремы.
Теорема PACELC
PACELC основана на модели CAP, но, помимо согласованности, доступности и устойчивости к разделению также включает временную задержку (L, Latency) и логическое исключение между сочетаниями этих понятий. Согласно PACELC, в случае сетевого разделения (P) в распределенной системе необходимо выбирать между доступностью (A) и согласованностью (C), как и в CAP- теореме, но в остальном (E, ELSE), даже при нормальной работе системы без разделения, нужно выбирать между задержкой (L) и согласованностью (C). В логическом выражении PACELC формулируют следующим образом: IF P -> (C or A), ELSE (C or L). Так PACELC расширяет и уточняет CAP-теорему, регламентируя необходимость поиска компромисса между временной задержкой и согласованностью данных в распределенных системах.
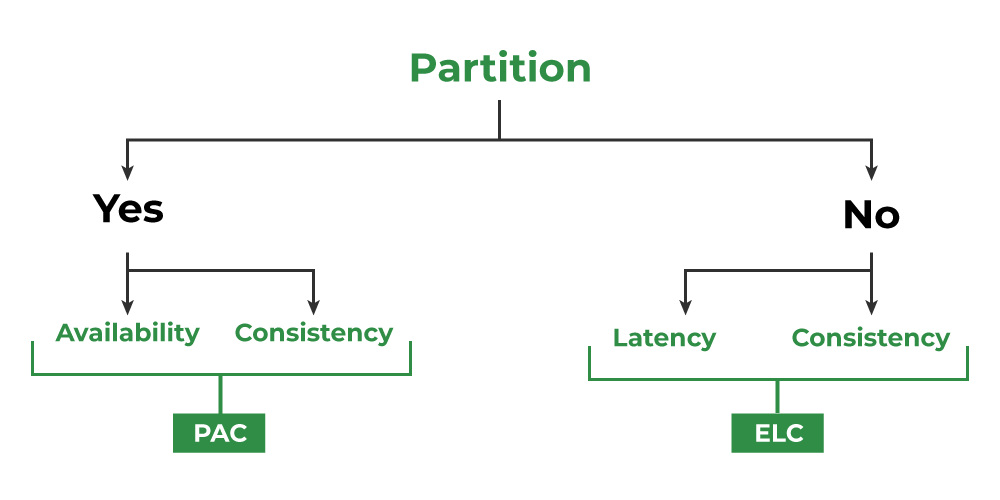
- PA/EL. Системы с высокой доступностью (A) при разделении (P) иначе (E) высокая скорость ответа (L).
- PC/EC. Системы, которые стараются максимально приблизиться к парадигме ACID с большой долей вероятности будут жертвовать доступностью (A) в угоду консистентности (С) и жертвовать производительностью (L) при разделении (P)
- PC/EL. Данная архитектура при разделении стремится оставаться консистентной, а в случае без сетевых разделений, фокусируется на скорости ответа, отводя консистентность на второй план.
- PA/EC. При наличии сетевого разделения системы ставка делается на доступность, а при отсутствии распределения – на консистентность.