MongoDB
MongoDB представляет наиболее популярную на данный момент документо-ориентированную систему управления базами данных. По разным оценкам входит в десяток самых используемых баз данных в мире.
Модель данных
Если реляционные базы данных хранят строки, то MongoDB хранит документы. В отличие от строк документы могут хранить сложную, иерархическую по структуре информацию. Документ можно представить как хранилище ключей и значений.
Ключевой проблемой моделирования данных является баланс между потребностями приложения, характеристиками производительности ядра базы данных и шаблонами извлечения данных. При разработке моделей данных всегда учитывайте использование данных приложением (т. е. запросы, обновления и обработка данных), а также внутреннюю структуру самих данных. Задав неверно корень документа можно сильно повлиять на производительность запросов чтения.
Ссылки
Mongodb хоть и является документной, но предоставляет возможности моделирования нормальных форм. В большенстве случаев это считается анти шаблоном, но не всегда.

Несколько рекомендаций при использовании нормальных форм:
когда встраивание приведет к дублированию данных, но не обеспечит достаточного преимущества в производительности чтения, чтобы перевесить последствия дублирования.
для представления более сложных отношений «многие ко многим».
моделировать большие иерархические наборы данных.
Для объединения коллекций MongoDB предоставляет этапы агрегации:
$lookup(Available starting in MongoDB 3.2)$graphLookup(Available starting in MongoDB 3.4)
Встроенные данные
Хоть mongodb и поддерживает нормализацию данных, документные БД склонны к денормализации. Обусловлено это локальностью доступа к данным.
Встроенные модели данных позволяют приложениям хранить связанные фрагменты информации в одной записи базы данных. В результате приложениям может потребоваться меньше запросов и обновлений для выполнения общих операций.

Несколько рекомендаций по использованию встроенных данных
- у вас есть отношения один-ко-многим между сущностями. В этих отношениях «многие» или дочерние документы всегда появляются вместе или просматриваются в контексте «одного» или родительского документа.
Возможности
Поиск
Возможности поиска в mongodb ни чем не уступают РСУБД. Ниже приведу только несколько примеров:
SELECT *
FROM people
db.people.find()
SELECT id,
       user_id,
       status
FROM people
db.people.find(
    { },
    { user_id: 1, status: 1 }
)
SELECT *
FROM people
WHERE status = "A"
db.people.find(
    { status: "A" }
)
SELECT *
FROM people
WHERE status = "A"
AND age = 50
db.people.find(
    { status: "A",
      age: 50 }
)
SELECT *
FROM people
WHERE age > 25
AND   age <= 50
db.people.find(
   { age: { $gt: 25, $lte: 50 } }
)
SELECT *
FROM people
WHERE user_id like "bc%"
db.people.find( { user_id: /^bc/ } )
SELECT *
FROM people
WHERE status = "A"
ORDER BY user_id ASC
db.people.find( { status: "A" } ).sort( { user_id: 1 } )
SELECT COUNT(*)
FROM people
WHERE age > 30
db.people.count( { age: { $gt: 30 } } )
SELECT DISTINCT(status)
FROM people
db.people.aggregate( [ { $group : { _id : "$status" } } ] )
SELECT *
FROM people
LIMIT 5
SKIP 10
db.people.find().limit(5).skip(10)
Шардированные коллекции должны включать индекс по Shard Key.
Запросы к шардированным коллекциям могут быть как точечными (в конкретный шард или поднабор шардов), так и бродкастовыми. Точечные запросы всегда лучше, ведь при их использовании не возбуждается весь кластер разом и не падает общая пропускная способность кластера на поиск.
Агрегации
Операции агрегирования обрабатывают несколько документов и возвращают вычисленные результаты. Вы можете использовать операции агрегирования для:
- Группируйте значения из нескольких документов вместе.
- Выполняйте операции над сгруппированными данными, чтобы вернуть один результат.
- Анализируйте изменения данных с течением времени.
На самом деле апи агрегаций mongodb намного выразительнее чем агрегации в РСУБД.
Давайте посмотрим на некоторые примеры:
Следующий пример конвейера агрегирования содержит два этапа и возвращает общее количество заказа пицц среднего размера, сгруппированных по названию пиццы:
db.orders.aggregate( [
   // Stage 1: Filter pizza order documents by pizza size
   {
      $match: { size: "medium" }
   },
   // Stage 2: Group remaining documents by pizza name and calculate total quantity
   {
      $group: { _id: "$name", totalQuantity: { $sum: "$quantity" } }
   }
] )
Этап $match:
- Фильтрует документы заказа пиццы на пиццу с значением поля size medium.
- Передаёт оставшиеся документы на $group сценарию.
Этап $group:
- Группирует оставшиеся документы по полю name.
- Используется оператор $sum для расчета общий суммы заказа для каждой пиццы. Итоговая сумма сохраняется в поле totalQuantity, возвращаемом конвейером агрегации.
Или еще более интересный пример в котором вычисляется общая стоимость заказа пиццы и средний объем заказа между двумя датами:
db.orders.aggregate( [
   // Stage 1: Filter pizza order documents by date range
   {
      $match:
      {
         "date": { $gte: new ISODate( "2020-01-30" ), $lt: new ISODate( "2022-01-30" ) }
      }
   },
   // Stage 2: Group remaining documents by date and calculate results
   {
      $group:
      {
         _id: { $dateToString: { format: "%Y-%m-%d", date: "$date" } },
         totalOrderValue: { $sum: { $multiply: [ "$price", "$quantity" ] } },
         averageOrderQuantity: { $avg: "$quantity" }
      }
   },
   // Stage 3: Sort documents by totalOrderValue in descending order
   {
      $sort: { totalOrderValue: -1 }
   }
 ] )
Работа с медиа
MongoDB предоставляет интерфейс работы с медиа называемый GridFS.
GridFS — это спецификация для хранения и извлечения файлов, размер которых превышает ограничение размера BSON.
GridFS использует две коллекции для хранения файлов. В одной коллекции хранятся фрагменты файлов, а в другой — метаданные файлов.
При этом MongoDB позволяет индексировать метаданные как обычные коллекции и работать с ними точно так же.
Ниже представлены поля метаданных
{
  "_id" : <ObjectId>,
  "length" : <num>,
  "chunkSize" : <num>,
  "uploadDate" : <timestamp>,
  "md5" : <hash>,
  "filename" : <string>,
  "contentType" : <string>,
  "aliases" : <string array>,
  "metadata" : <any>,
}
Архитектура кластера
Физическая структура кластера
Эта классическая система с одним ведущим узлом и возможностью партиционирования (шардирования) своих данных по нескольким узлам.
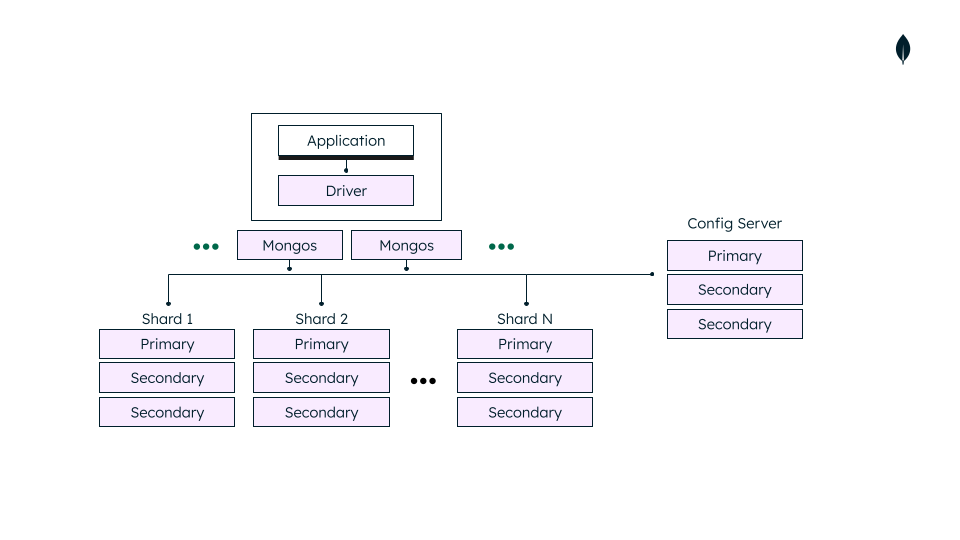
Шардированный кластер Mongodb состоит из следующих ролей: router, shard, config server.
Router
Router(mongos) действует как маршрутизатор запросов, обеспечивая интерфейс между клиентскими приложениями и шардированным кластером. Обмениваясь информацией с сервером конфигурации роутер получает информацию о распределении сегментов по кластеру.
Shard
Каждый шард содержит подмножество шардированных данных. Каждый шард можно развернуть как набор реплик.
Config server
Серверы конфигурации хранят метаданные и параметры конфигурации для кластера.
Логическая структура
Collection
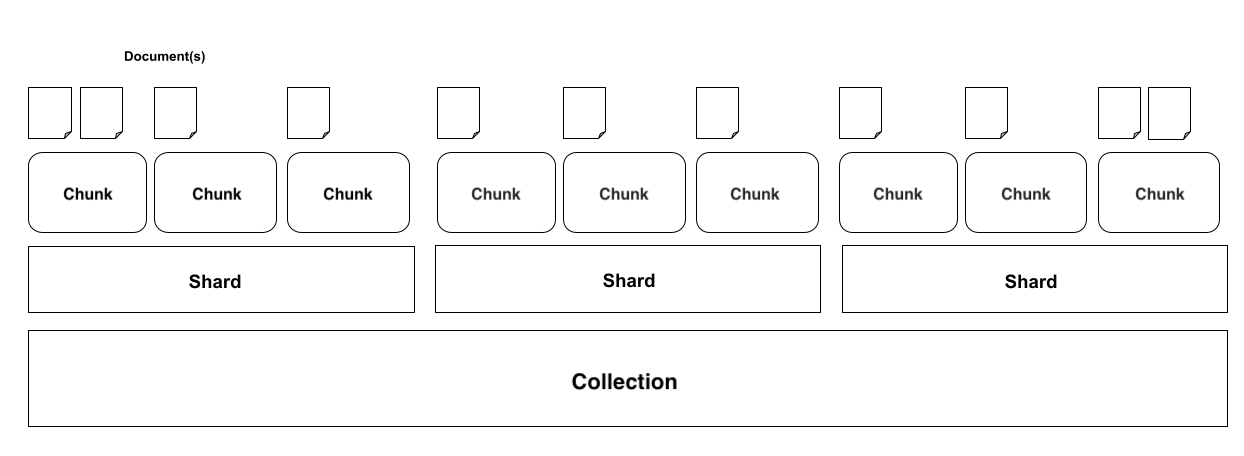
Если в традиционном мире SQL есть таблицы, то в мире MongoDB есть коллекции. И если в реляционных БД таблицы хранят однотипные жестко структурированные объекты, то в коллекции могут содержать самые разные объекты, имеющие различную структуру и различный набор свойств.
Хранение неструктурированной информации не является как плюсом так и минусом. Это скорее данность. Сами разработчики mongodb не рекомендуют хранить в одной коллекции разные типы объектов. Обычно такой подход называют схемой при чтении, однако уже начиная с 4 версии разработчики добавили валидаторы (аналог схемы в РСУБД). Так же mongodb обросла большим количеством инструментов миграции, что говорит о востребованности держать схему данных в пределах допустимого.
Shard
Каждый шард содержит подмножество данных коллекции. Количество шардов отпределяется настройками коллекции.
Shard Key
Определяем размещение документов по шардам. В качестве shard key может быть либо одно индексированное поле, либо несколько полей, охватываемых составным индексом.
Replica
Это копия шардов. Шард, который напрямую получает обновления, называется «primary shard», а его копия — «replica shard». Количество реплик влияет на доступность и производительность поиска и может быть изменено в любое время. Если основной шард по какой-либо причине утерян, один из его реплик будет повышен до primary шарда.
Chunk
MongoDB использует shard key, связанный с коллекцией, для разделения данных на чанки, принадлежащие определенному шарду. Чанк состоит из диапазона шардированных данных. Диапазон может представлять собой часть фрагмента или весь фрагмент. По умолчанию при создании шардированной коллекции создается один чанк и при достижения парогового размера (по умолчанию это 128 мб) чанк делится и перераспределяется по кластеру. Также инициализирующее количество чанков можно задать при создании коллекции.

Document
Один документ представляет собой один фрагмент данных.
Ложка дёгтя
Какую-то большую проблему в версии mongodb 7.0 я не нашел. Небольшим недостатком для меня является лояльноять БД к разработчику. Для разработчика нет разницы работать с локальными данными или распределенными. При низком уровне зрелости команды использование БД может превратиться в ад запросов во все шарды.
Сценарии использования
Условие, при котором MongoDB не будет хорошим выбором:
У вас есть несколько коллекций с большим количеством ссылок для обеспечения целостности данных, и большинство запросов требуют JOIN.
Условие, при котором MongoDB может быть хорошим выбором, но с некоторыми ограничениями или потенциально узкими местами:
Вам необходимо реализовать хранимые процедуры и триггеры, которые есть в вашей реляционной базе данных.
Случаи, когда MongoDB будет хорошим выбором:
Ваши приложения в основном работают с JSON-документами;
Ваши данные непредсказуемы и бывают частые изменения схемы;
Вам требуется высокая доступность и масштабируемость чтения;
Вам нужно масштабировать данные очень большого размера;
Требуется масштабирование из-за огромного количества операций записи.
Некоторые примеры:
логирование событий;
управление контентом;
игры;
платежные системы;
аналитика в режиме реального времени;
приложения Интернета вещей;
кеширование;
приложения, обрабатывающие временные ряды.
Характеристики
Характеристики | Значение | Комментарий |
|---|---|---|
| Семейства баз данных | document-oriented database | |
| Транзакционная модель | ACID | Насколько я понял уровень изоляции Repeatable reads |
| Многоузловые транзакции | есть | |
| Структуры данных | B-деревья | |
| Масштабирование | Горизонтальное партиционирование | |
| Репликация | с одним ведущим узлом | |
| Модели согласованности | линеаризуемость | |
| CAP | Настраиваемый
| |
| PACELC | Настраиваемый
| |
| Fault Tolerance | автоматически | |
| Primary Key | есть | |
| Partition Key | есть | |
| Foreigen Key | нету | |
| Локальный вторичный индекс | есть | |
| Глобальный вторичный индекс | нету | |
| Ограничение уникальности | есть | |
| JOINs | есть | но в рамках апи агрегаций. В большинстве случаев это считается анти шаблоном. |
| Агрегации | есть | внутри одного узла. Остальные решения не эффективны |
| Схема данных | есть | есть валидаторы |
| Организация данных | денормализованная |
Ссылки
- MongoDB Documentation
- Развенчиваем мифы о MongoDB. Павел Перекалов
- Подумываете об использовании MongoDB?
- Когда использовать MongoDB и PostgreSQL