Cassandra
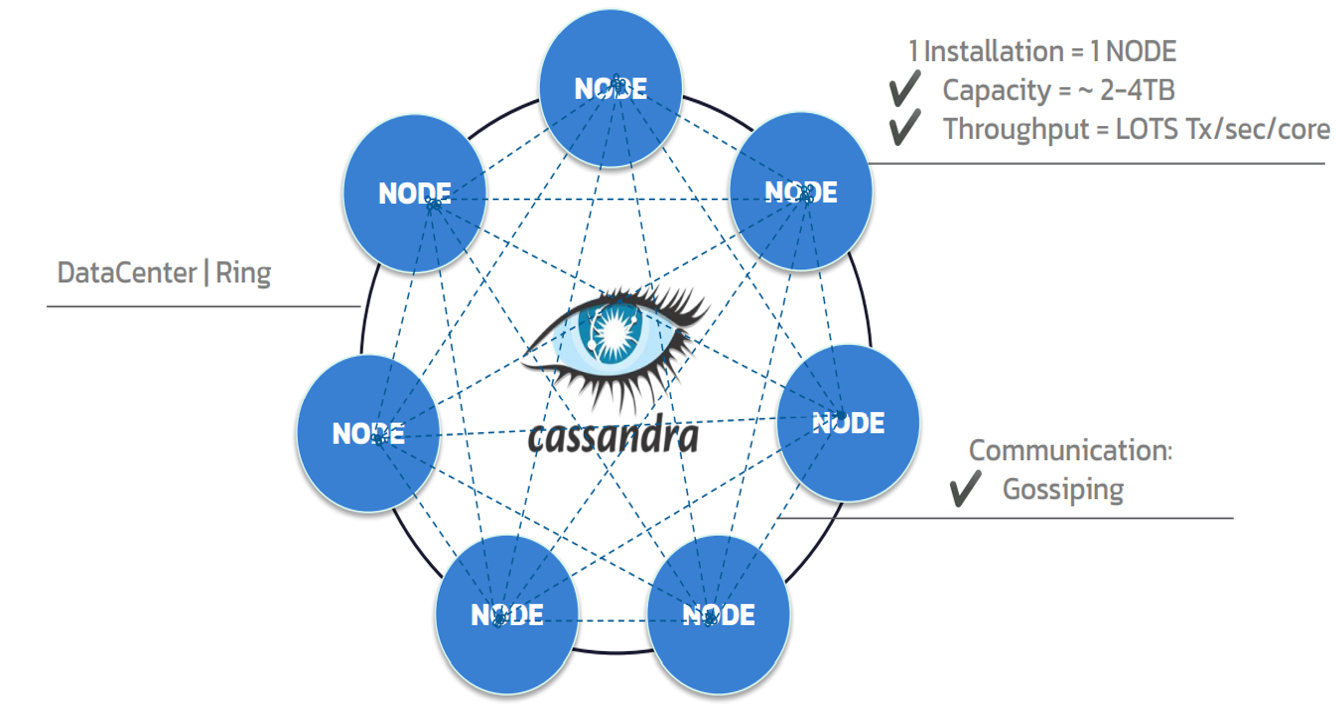
Apache Cassandra – это нереляционная отказоустойчивая распределенная СУБД, рассчитанная на создание высокомасштабируемых и надёжных хранилищ огромных массивов данных, представленных в виде хэша. Cassandra относится к семейству wide column СУБД с полностью децентрадизованной архитектурой.
Модель данных
Cassandrd принадлежит симейству широких колонок чем очень похожа на реляционные БД. Как и реляционные, семейства колонок хранят данные, используя строки и столбцы, но с иной связью между элементами.
В реляционных БД все строки должны соответствовать фиксированной схеме. Схема определяет, какие столбцы будут в таблице, типы данных и другие критерии. В семействе колонок вместо таблиц имеются структуры – «колоночные семейства». Семейства содержат строки, каждая из которых определяет собственный формат. Строка состоит из уникального идентификатора, используемого для поиска, за которым следуют наборы имён и значений столбцов.
Модель Cassandra содержит следующие элементы:
- столбец или колонка (column) – ячейка с данными, включающая 3 части – имя (column name) в виде массива байтов, метку времени (timestamp) и само значение (value) также в виде байтового массива. С каждым значением связана метка времени — задаваемое пользователем 64-битное число, которое используется для разрешения конфликтов во время записи: чем оно больше, тем новее считается столбец. Это учитывается при удалении старых колонок.
- строка или запись (row) – именованная коллекция столбцов;
- семейство столбцов (column family) – именованная коллекция строк. Необходима для минимизации объёма чтений. Семейство столбцов позволяет сгруппировать данные которые требуются в одном запросе совместно и отделить остальные, что повышает эффективность работы с памятью и сетью.
- пространство ключей (keyspace) – группа из нескольких семейств столбцов, собранных вместе. Оно логически группирует семейства столбцов и обеспечивает изолированные области имен.
Модель данных играет огромное значение при проектированиее схемы данных в Cassandra.
Запрос первичны
В реляционных БД проектирование выполняется в бизнес-сущностях. Сначала создаются таблицы, каждая из которых описывает сущность, при этом мы не задумываемся об sql-запросах на этом этапе. Это происходит потому, что мы знаем, что всегда можем: начать запрос из любой таблицы, использовать join либо встроенные select, чтобы обратиться к данным.
В Cassandrf используется другой подход. При проектирование, нужно учитывать, что запрос должен получить за один раз все данные из одной таблицы. Поэтому сначала проектируются все возможные запросы, а затем под них создаются таблицы. Таким образом в Cassandra создание структуры БД начинается с определения запросов.
Ниже представлена диаграмма моделирования в Cassandrd.
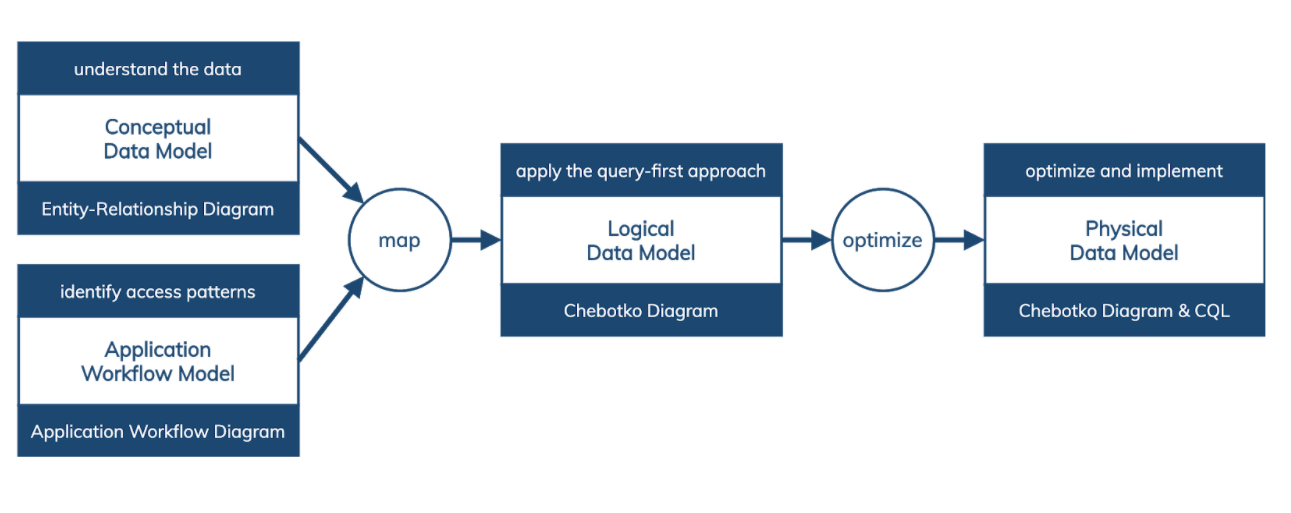
На самом высоком уровне у нас есть 4 цели:
- Нужно понять данные.
- Идентифицировать шаблоны доступа данных, то есть понять, как используются эти данные.
- Использовать эту информацию, чтобы создать логическую модель данных.
- Оптимизировать это все и получить конечную схему.
Результат решения этих четырёх задач будет равен четырём моделям:
- Conceptual Data Model.
- Application Workflow Model.
- Logical Data Model.
- Physical Data Model.
Каждую модель удобно представить каким-то образом: либо это Entity-Relationship Diagram (сущность-связь), Application Workflow Diagram (поток работ), Chebotko Diagram и Chebotko Diagram&CQL.
Возможности
Поиск
Особенности поиска Cassandra:
- Быстрый поиск по строке (благодаря хешу на первичный ключ)
- Быстрая выборка по диапозону (range scan по кластерным ключам)
Запрос по первичному ключу
Поиск по первичному ключу это основной сценарий работы с Cassandra. Первичный ключ позволяет точечно зайти за данными не делая full scan и не возбуждая весь кластер.
SELECT * FROM company WHERE company_name = 'company_a' AND employee_email = 'employee_a@mail.com';
Запросы по ключу партиционирования
SELECT * FROM company WHERE company_name = 'company_a' AND employee_age = 30;

InvalidRequest: Error from server: code=2200 [Invalid query] message="Cannot execute this query as it might involve data filtering and thus may have unpredictable performance. If you want to execute this query despite the performance unpredictability, use ALLOW FILTERING"
Такие запросы не считаются естественными для Cassandra, но допустимые т.к. запрос может быть локализован одним узлом кластера.
Флаг ALLOW FILTERING позволяет нам игнорировать предупреждение и выполнить запрос
SELECT * FROM company WHERE company_name = 'company_a' AND employee_age = 30 ALLOW FILTERING;
Запрос не по ключу партиционирования
SELECT * FROM company WHERE employee_age = 30;

InvalidRequest: Error from server: code=2200 [Invalid query] message="Cannot execute this query as it might involve data filtering and thus may have unpredictable performance. If you want to execute this query despite the performance unpredictability, use ALLOW FILTERING"
И вот тут у нас может появиться желание использовать флаг ALLOW FILTERING из прошлого примера, но не стоит этого делать. Не имея ключ партиционирования Cassandra не может определить в какой узел кластера отправить запрос.
Запросы с лимитированием и сортировкой
SELECT * FROM company WHERE company_name = 'company_a' LIMIT 10;
Как и в обычном SQL такой запрос вернет 10 первых записей отсортированных по умолчанию. Как уже говорилось, сортировка происходит по кластерным ключам (Сортировка по умолчанию по возрастанию ASC).
SELECT * FROM company WHERE company_name = 'company_a' ORDER BY employee_email DESC LIMIT 10;
Тот же запрос но с обратной сортировкой.
Вторичные индексы и запросы по индексам
Вторичные индексы в Cassandra устраняют необходимость запрашивать столбцы, которые не являются частью первичного ключа.
CREATE INDEX IF NOT EXISTS ON company (employee_age);
Теперь мы можем выполнить запрос по employee_age без каких-либо ошибок и флага ALLOW FILTERING:
SELECT * FROM company WHERE employee_age = 30;
Нельзя считать такой запрос корректным. Хоть он и не выдаёт ошибку он возбуждает каждый узел кластера.
Правильнее будет ограничивать его ключём партиционирования и тогда cassandra зайдет только в узлы с нужной партицией.
SELECT * FROM company WHERE employee_age = 30 AND company_name = "company_A";
Агригации
Также Cassandra поддерживает типичные для SQL агригации, но нужно понимать, что эффективно они работают только в пределах одного узла (проблема ALLOW FILTERING)
Ниже пример агригации count
SELECT COUNT(*) FROM company WHERE company_name = 'company_a';
Также доступны:
- Max and Min
- Sum
- Avg
- User-Defined Aggregates
Архитектура кластера
Первичный ключ
Первичный ключ является наиболее важным элементом моделирования данных, который однозначно идентифицирует запись данных . Он состоит как минимум из одного ключа раздела и нуля или более столбцов кластеризации.
Ключ раздела определяет, как мы разделяем данные по кластеру. Столбец кластеризации упорядочивает данные на диске, чтобы обеспечить быстрое чтение.
Давайте посмотрим на пример:
CREATE TABLE company (
    company_name text,
    employee_name text,
    employee_email text,
    employee_age int,
    PRIMARY KEY ((company_name), employee_email)
);
Здесь мы определили company_name как ключ раздела, используемый для равномерного распределения данных таблицы по узлам. Далее, поскольку мы указали employee_email в качестве столбца кластеризации, Cassandra использует его для хранения данных в порядке возрастания на каждом узле для эффективного извлечения строк.
Топология кластера
Узлы размещаются в кольцо, образуя центр обработки данных, и, соединяя несколько территориально распределенных центров обработки данных, мы создаем кластер.
Cassandra автоматически разделяет данные без ручного вмешательства, что делает их готовыми к работе с большими данными.
Далее давайте посмотрим, как Cassandra разбивает нашу таблицу по company_name:
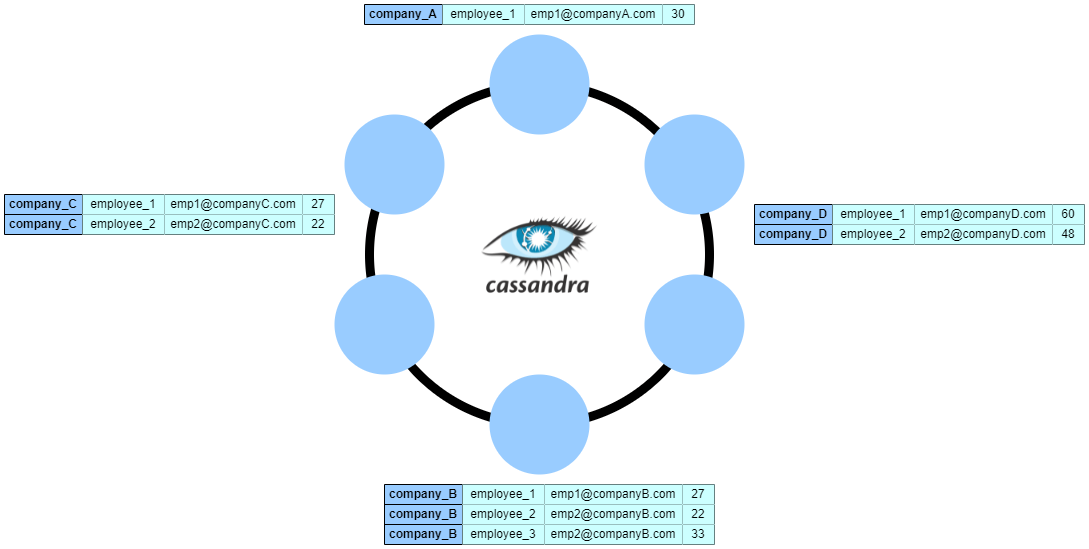
Как мы видим, таблица company разбита на секции с помощью ключа секции company_name и распределена по узлам. Мы можем заметить, что Cassandra группирует строки с одинаковым значением company_name и сохраняет их в одном и том же физическом разделе на диске. В результате мы можем считывать все данные для данной компании с минимальными затратами на ввод-вывод.
Кроме того, мы можем реплицировать данные в центре обработки данных, определив коэффициент репликации. При коэффициенте репликации N каждая строка данных будет храниться на N разных узлах кластера.
Ложка дёгтя
Cassandra заявляет о строгой согласованности кластера манипулирую расплывчатости определения согласованности в CAP. Под строгой слогласованностью они понимают immediate consistency, при этом таковой не являясь. Как я уже рассматривал в разделе Модели согласованности, кворумные системы как правило не согласованны. На самом деле Cassandra имеет сессионные гарантии согласованности. И нельзя сказать, что это плохо, это просто данность которую нужно учесть при проектировании своих систем.
Например мы может писать в Cassandra только из одного процесса или писать во множество процессов, но разделить эти процессы по поднабору ключей. В каждый ключ будет писать только один процесс. Это предотвратит появление конфликтов записи.
Сценарии использования
Когда не стоит использовать
Таблицы имеют несколько путей доступа к данным. Пример: множество вторичных индексов.
- Приложению нужны атомарные операции. Пример: автоинкременты.
- Cassandra не поддерживает ACID. Подумайте нужен ли он вам.
- Сложные агригации за пределами одного узла
- Если вам нужны Joins. Cassandra смоделированна с учетом денормализации данных
- Cassandra не поддерживает блокировки
- Cassandra хорошо работает с активной записью и чтением, но плохо работает с обновлениями. LSM-дерево и процесс слияния может свести БД с ума.
Когда стоит задуматься о использовании
Высокие нагрузки на запись/чтение
Линейное масштабирование: путем добавления узлов, а не увеличения количества оборудования на существующих узлах.
Требуется географическое распределение
- Предпочтение записи перед чтением: запись происходит на порядок быстрее, чем чтение.
- Высокая отказоустойчивость кластера. Нет ведущего узла
- Нет требования линеаризуемости
Идеальные сценарии использования
Запись значительно превышает чтение, при условии экстремальных нагрузок
Данные редко обновляются, а когда обновляются, обновляются идемпотентно.
Доступ для чтения осуществляется по известному первичному ключу.
- Данные можно разделить с помощью ключа, который позволяет равномерно распределить базу данных по нескольким узлам.
Нет необходимости в соединениях.
Некоторые примеры
- Audit logging
- Хранения данных временных рядов
- Трекинг статуса заказа
- IoT и история событий
Характеристики
Характеристики | Значение | Комментарий |
|---|---|---|
| Семейства баз данных | wide column/column family database | |
| Транзакционная модель | BASE | |
| Структуры данных | LSM-деревья | |
| Масштабирование | Горизонтальное партиционирование | |
| Репликация | несколько ведущих узлов | |
| Модели согласованности | immediate consistency | |
| CAP | AP | |
| PACELC | PA/EL | |
| Fault Tolerance | автоматически | |
| Primary Key | есть | |
| Partition Key | есть | |
| Foreigen Key | нету | |
| Локальный вторичный индекс | есть | |
| Глобальный вторичный индекс | нету | Хоть их и нет, но их можно смоделировать через batch операцией |
| Ограничение уникальности | нету | |
| JOINs | нету | |
| Агригации | есть | внутри одного узла. Остальные решения не эффективны |
| Схема данных | есть схема | |
| Организация данных | денормализованная |
Ссылки