ClickHouse
ClickHouse – column oriented СУБД с открытым исходным кодом для быстрой обработки аналитических запросов на структурированных больших данных в режиме реального времени.
То как о ClickHouse пишут её разработчики "ClickHouse is the fastest and most resource efficient open-source database for real-time apps and analytics".
ClickHouse наделен SQL подобным синтаксисом запросов. Это как и достоинство так и проклятье.
SELECT
    toStartOfMonth(upload_date) AS month,
    sum(view_count) AS `Youtube Views`,
    bar(sum(has_subtitles) / count(), 0.55, 0.7, 100) AS `% Subtitles`
FROM youtube
WHERE (month >= '2020-08-01') AND (month <= '2021-08-01')
GROUP BY month
ORDER BY month ASC
Достоинства:
- все знают SQL
- SQL декларативный язык запросов, что позволяет легко оптимизировать запросы
Недостатки:
- простота SQL может вводить в заблуждение. Всегда нужно понимать как твой запрос исполняется на кластере
- с помощью SQL невозможно написать Тьюринг-полную функцию
Модель данных
ClickHouse ориентированная на колонки БД. Так же как MongoDB и Cassandra моделирование происходит от конечного запроса. В принципе, ничего не меняя, можно воспользоваться подходом к моделированию Cassandra.
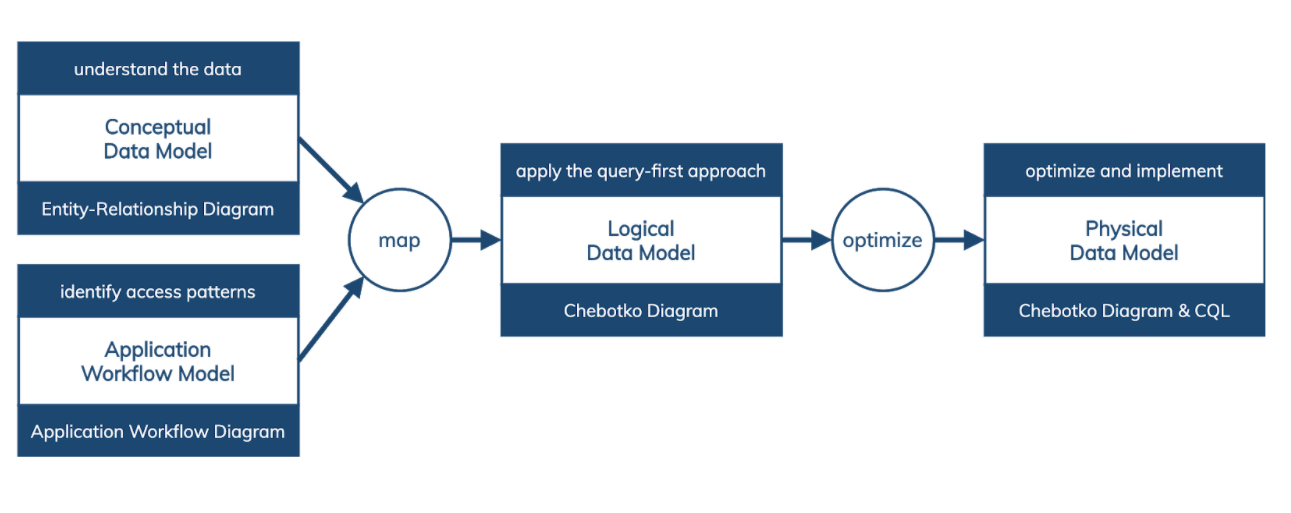
На самом высоком уровне у нас есть 4 цели:
- Нужно понять данные.
- Идентифицировать шаблоны доступа данных, то есть понять, как используются эти данные.
- Использовать эту информацию, чтобы создать логическую модель данных.
- Оптимизировать это все и получить конечную схему.
Результат решения этих четырёх задач будет равен четырём моделям:
- Conceptual Data Model.
- Application Workflow Model.
- Logical Data Model.
- Physical Data Model.
Возможности
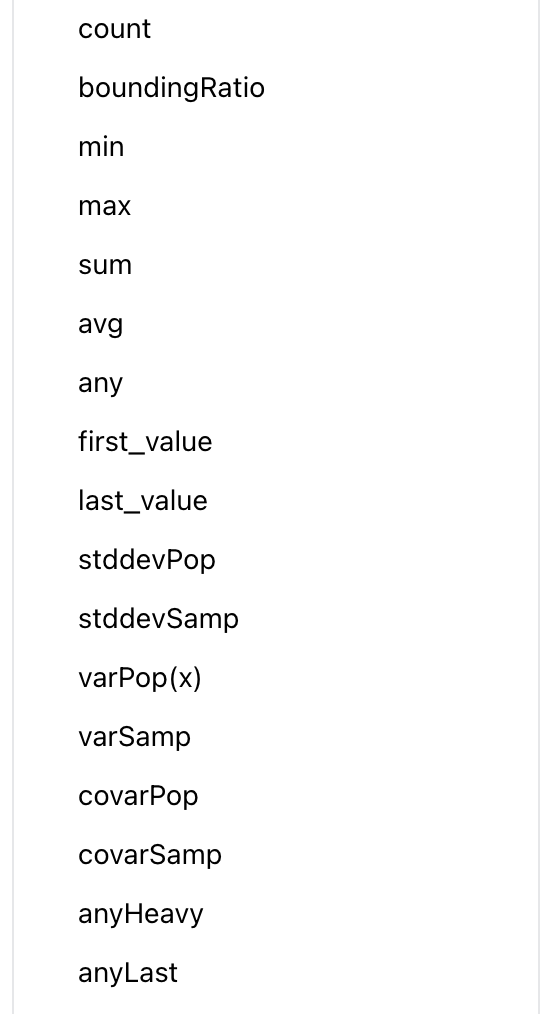
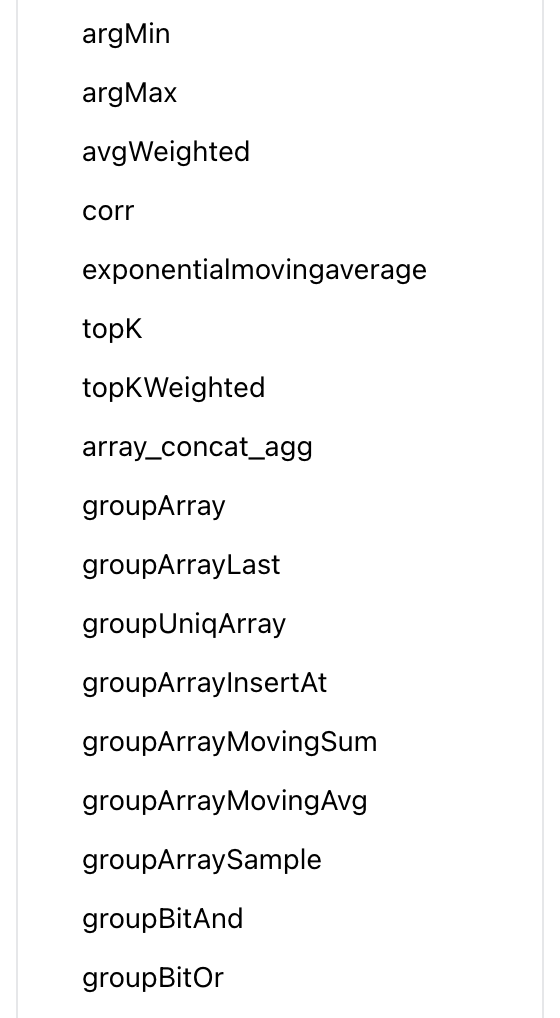
Существует как минимум два типа функций — простые функции и агрегатные функции. Это совершенно разные понятия. Обычные функции работают так, как будто они применяются к каждой строке отдельно (для каждой строки результат функции не зависит от других строк). Агрегатные функции накапливают набор значений из разных строк (т. е. они зависят от всего набора строк).
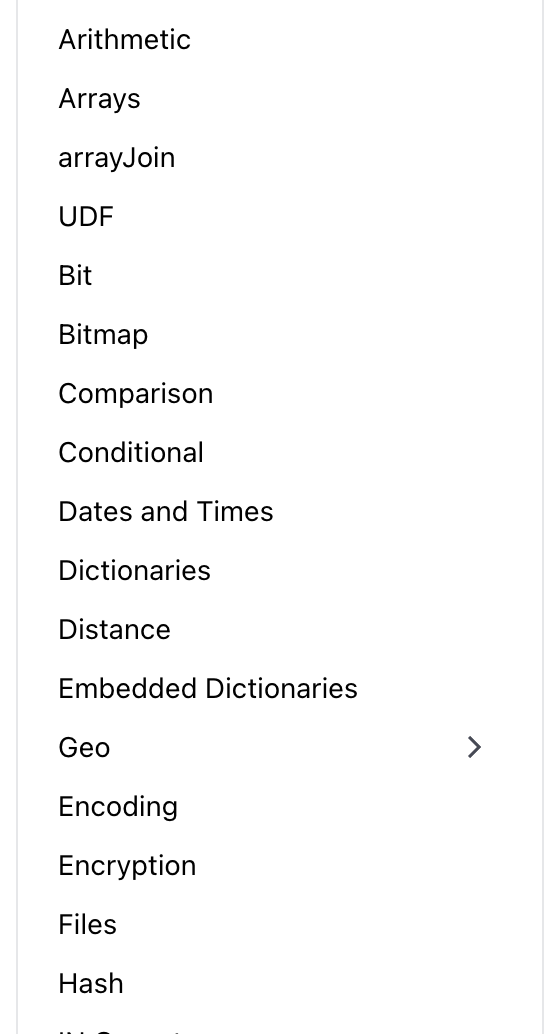
Я не буду подробно описывать все возможные функции которыми обладает clickhouse. Просто приведу пример из документации, пытливый ум сам найдет, что ему нужно 
Обычные функции
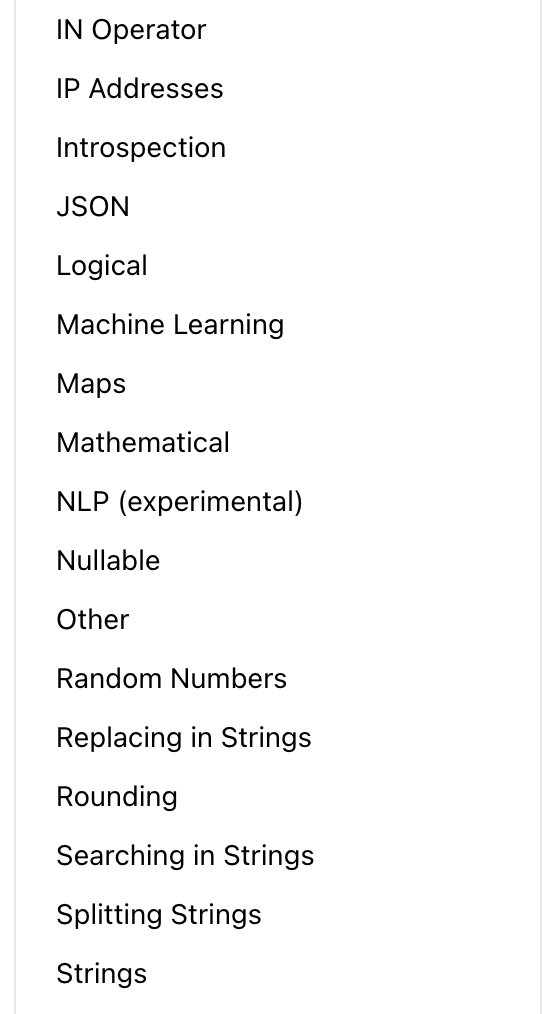
Агрегатные функции
Архитектура кластера
Структура данных
Пришло время заглянуть внутрь и понять почему же ClickHouse так быстр на OLAP нагрузках.
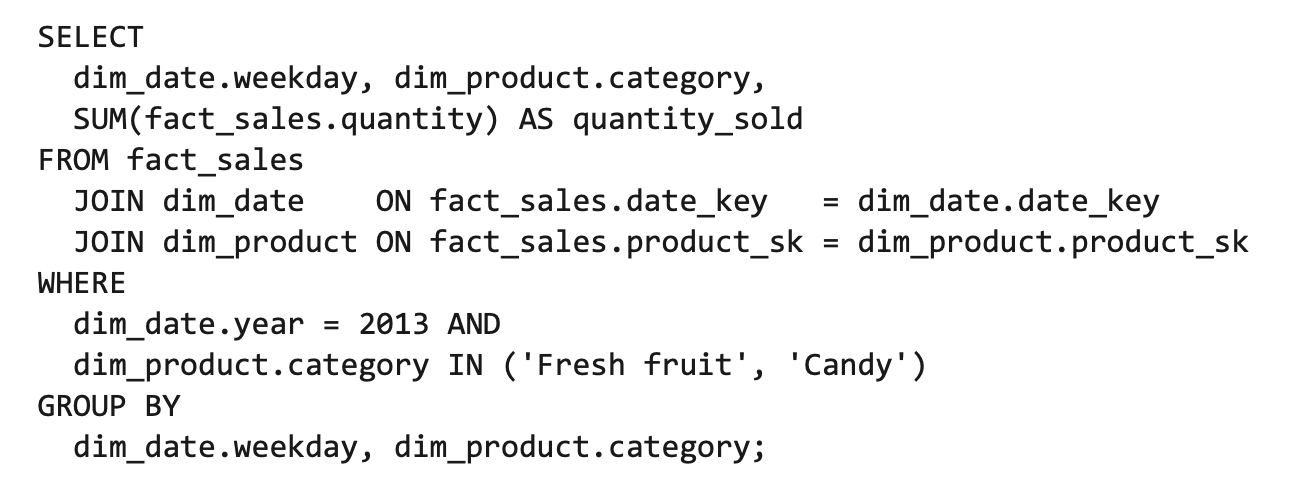
Рассмотрим работу ClickHouse на примере таблицы фактов. Если взять таблицу фактов, то в такой таблице будет порядка 100 столбцов и петтабайты данных.
Классический запрос к таким таблицам будет выглядеть
В большинстве баз данных OLTP хранилище располагается построчно: все значения из одной строки таблицы хранятся рядом друг с другом.
Чтобы выполнить такой запрос нам понадобятся индексы по столбцам fact_sales.date_key и/или fact_sales.product_sk, которые бы со- общали подсистеме хранения, где искать все продажи для конкретной даты или конкретного товара. Но даже после этого реализованная построчно подсистема хранения должна загрузить все строки (каждая из которых состоит из более чем 100 атрибутов) с диска в оперативную память, выполнить их синтаксический раз- бор и отфильтровать те, что не удовлетворяют заданным условиям. На это может уйти много времени.
Идея столбцовых хранилищ проста: нужно хранить рядом значения не из одной строки, а из одного столбца. Если каждый столбец хранится в отдельном файле, то запросу требуется только прочитать и выполнить синтаксический разбор не- обходимых запросов столбцов, что может сэкономить массу усилий.
Вторая идея еще проще: нам не нужен индекс. Давайте упорядочим данные внутри колонок, так чтобы эта сортировка удовлетворяла пользовательскому запросу.
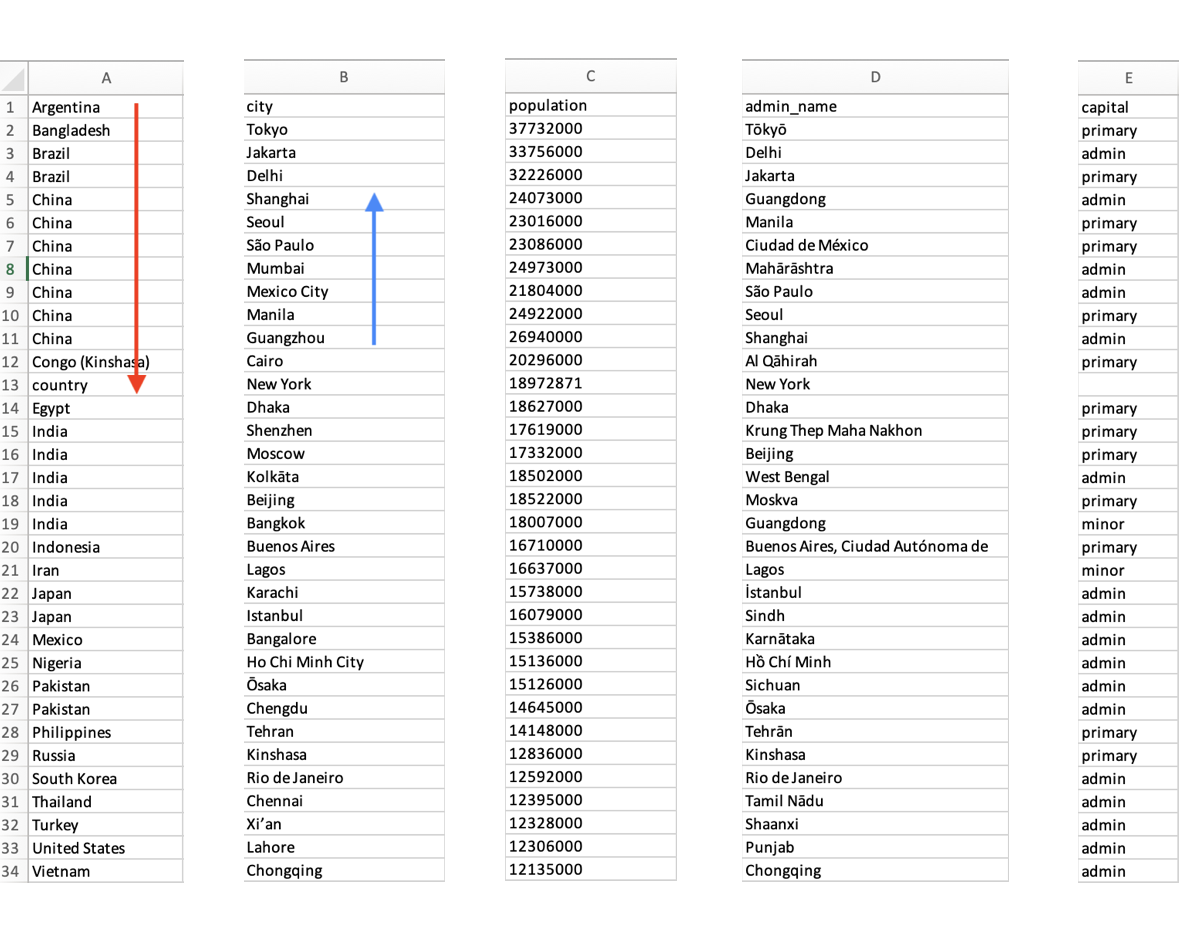
Проще всего представить эту идею можно на примере excel таблицы.
На рисунке ниже изображена неотсортированная таблица
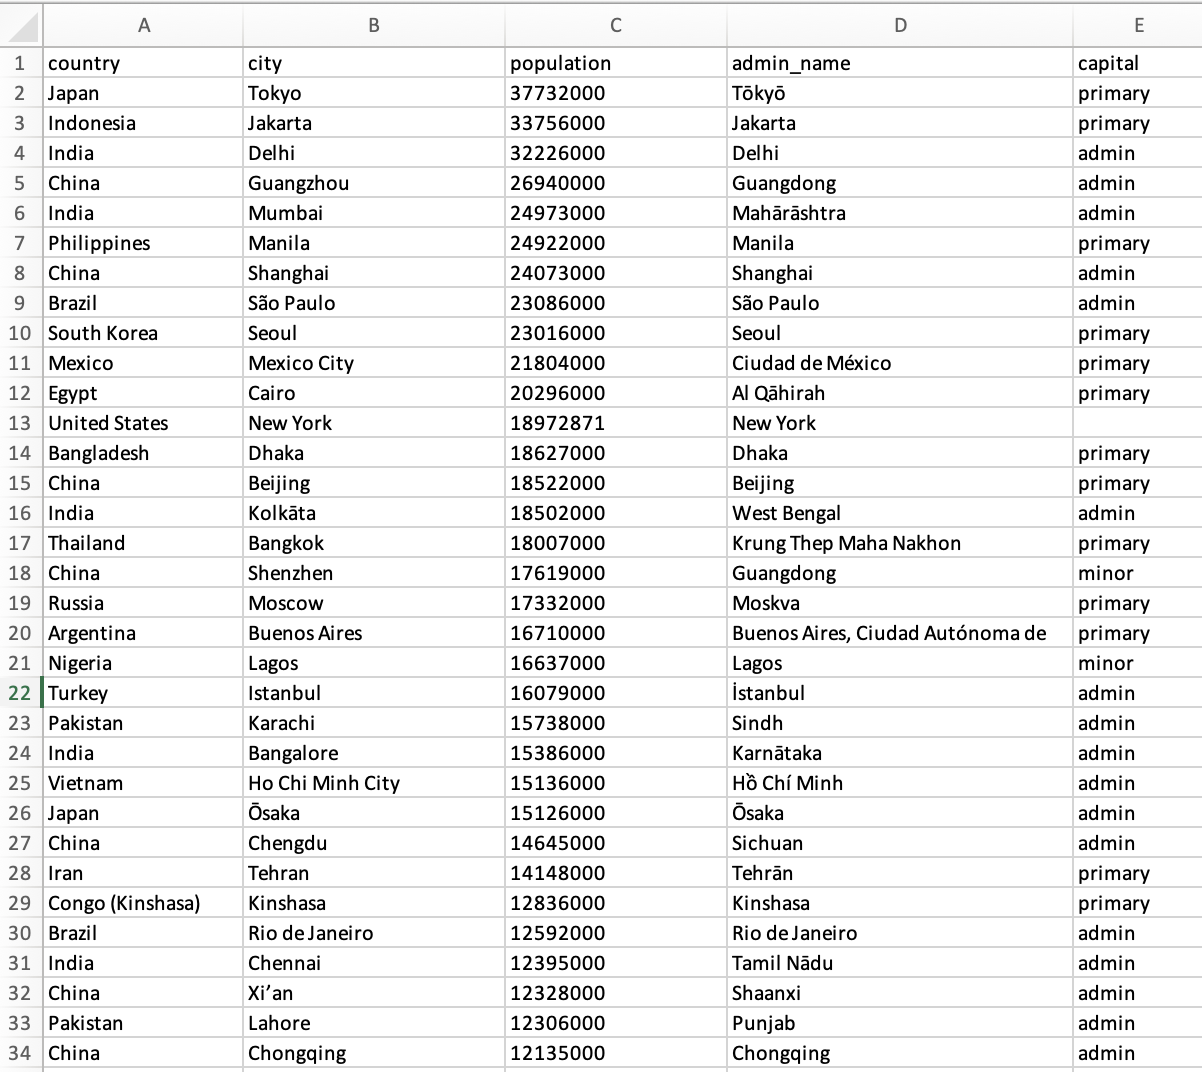
Давайте же её отсортируем и полученную таблицу разобьем на отдельные столбцы, как показано ниже
Ниже приведена LSM-подобная структура хранения колонок в ClickHouse.
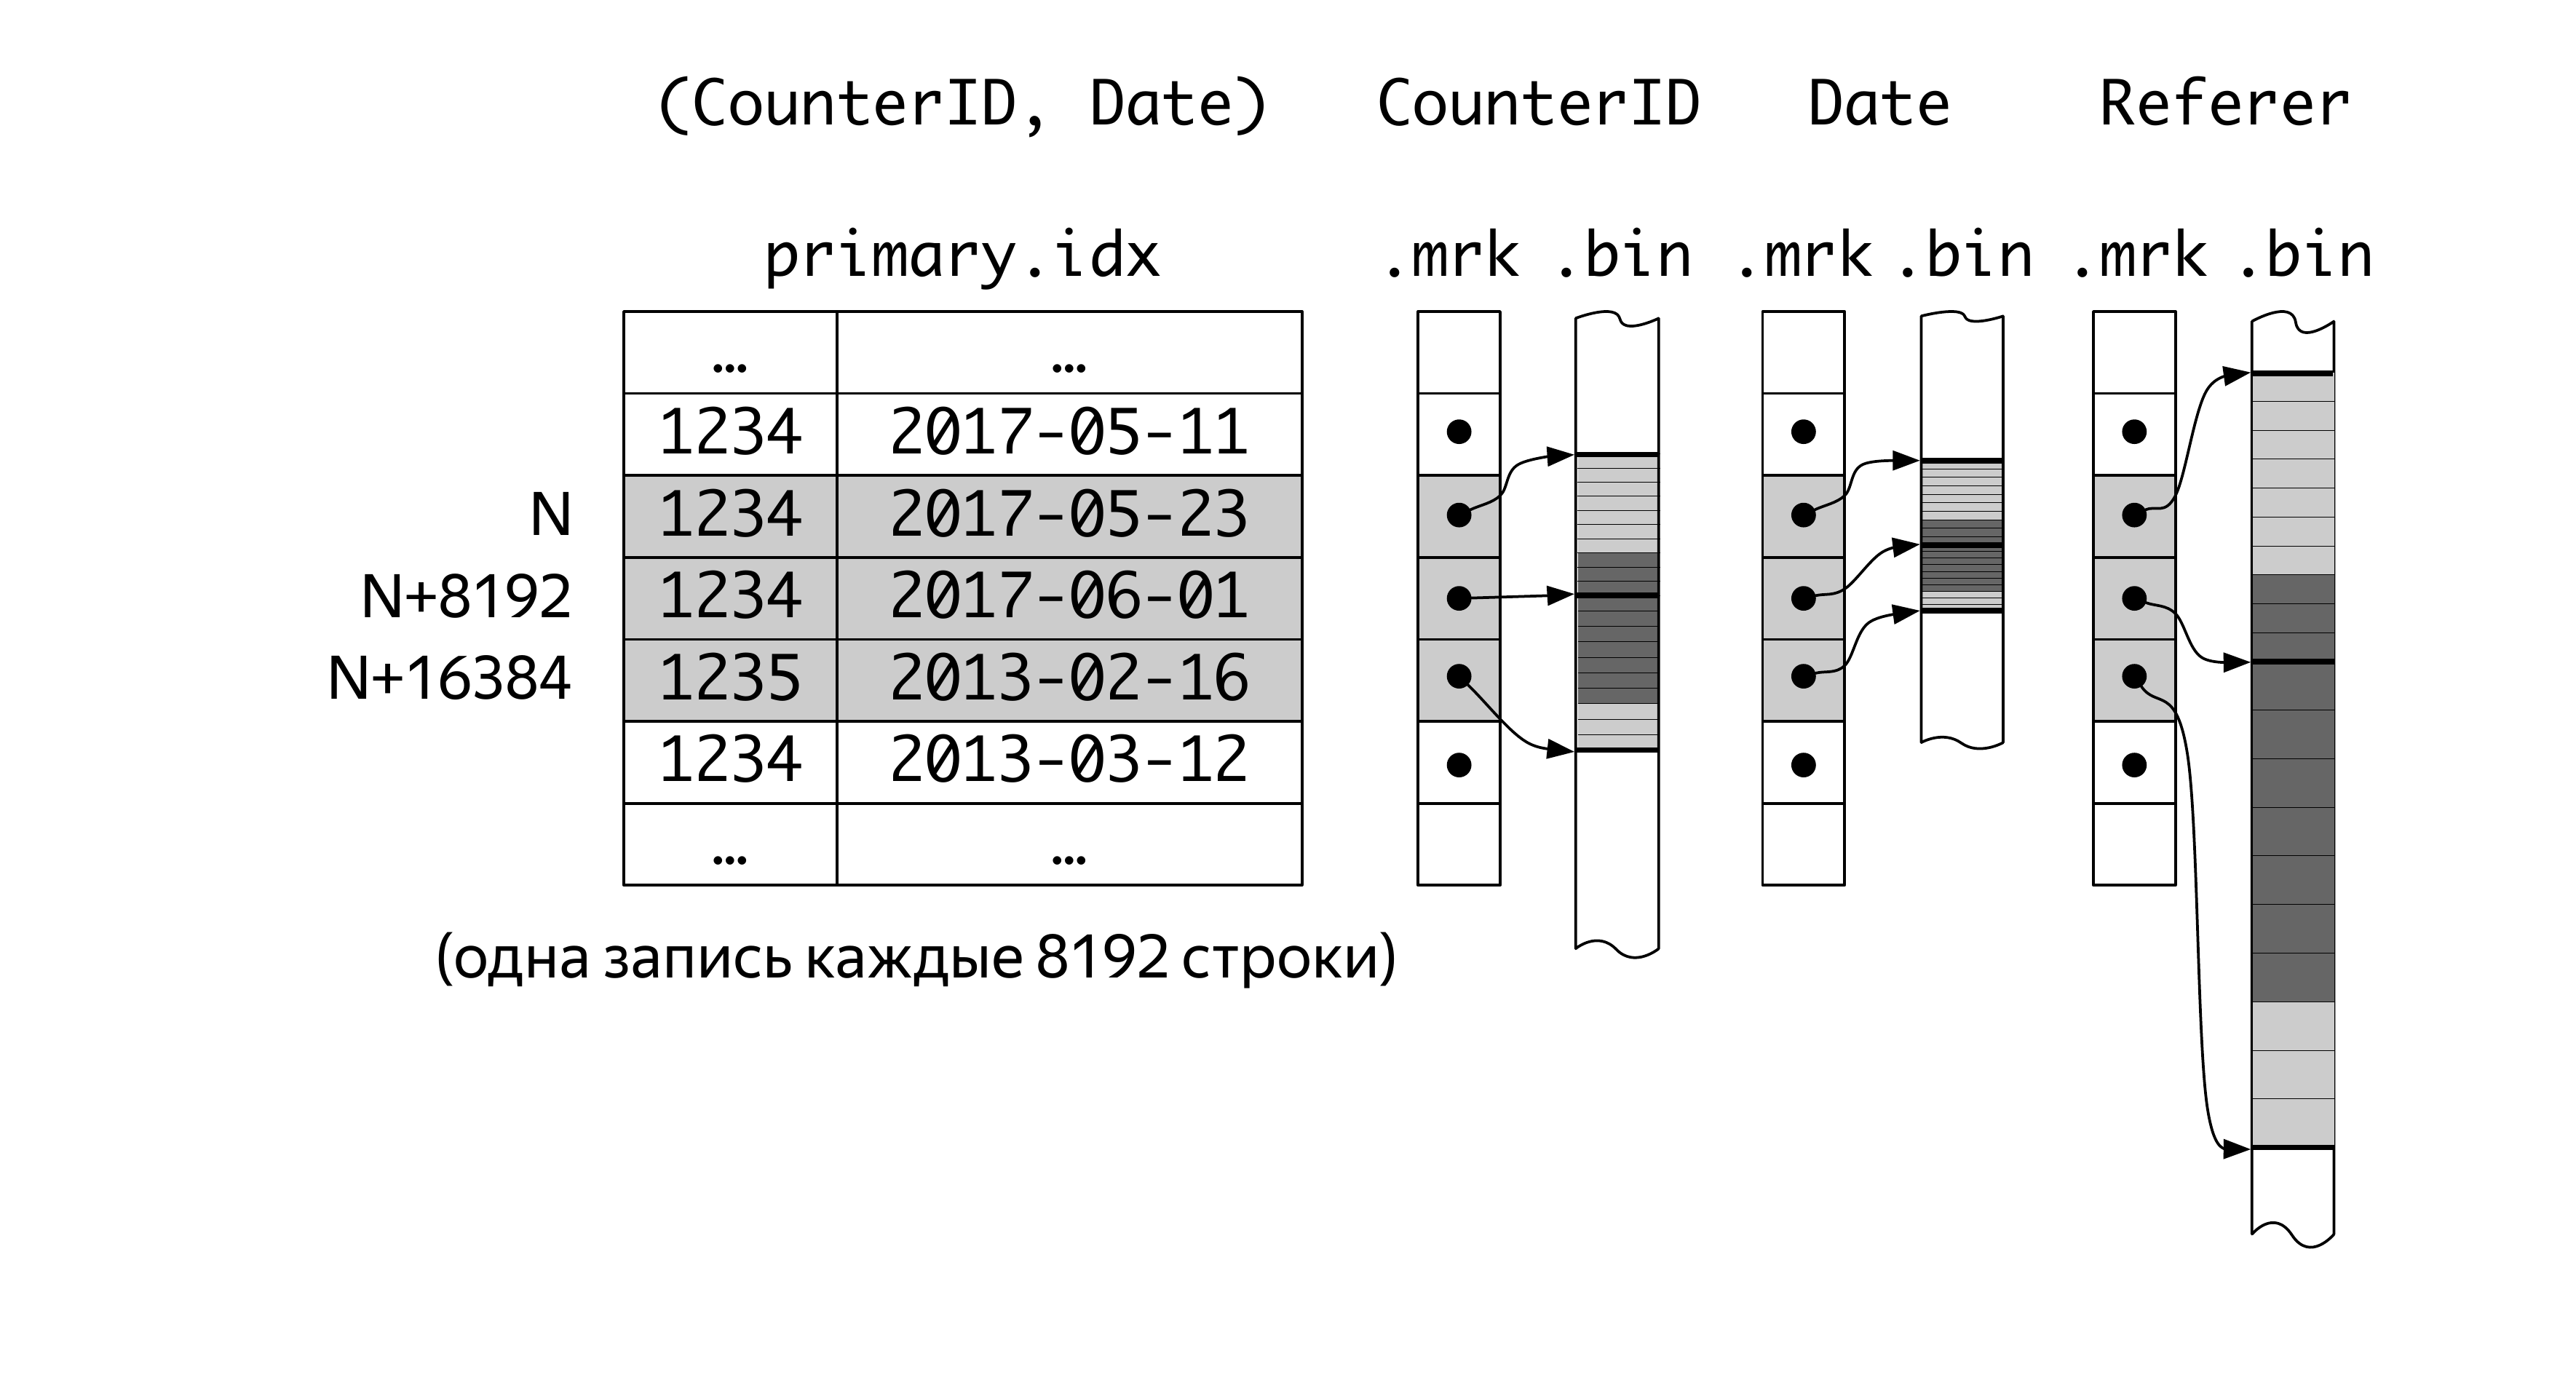
primary.idx - первичный разряженный индекс (в нашем случае разряженный на каждые 8192 строки)
.bin - это наши данные отсортированные по первичному ключу
.mrk - файл засечки. Он существует для каждого файла .bin и хранит связь между primary.idx и своим файлом .bin. Т.е. он хранит смещение для файла .bin.
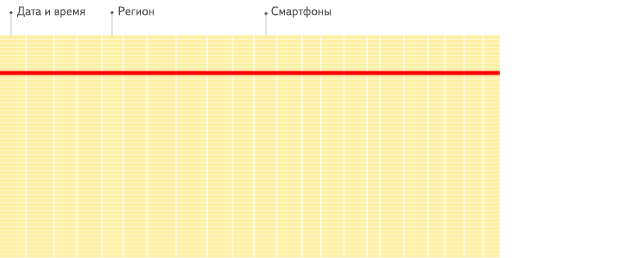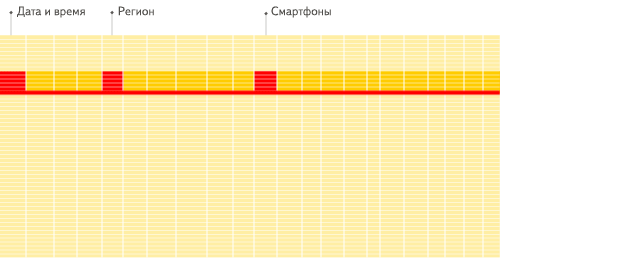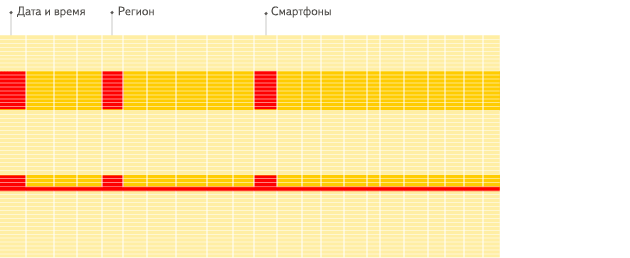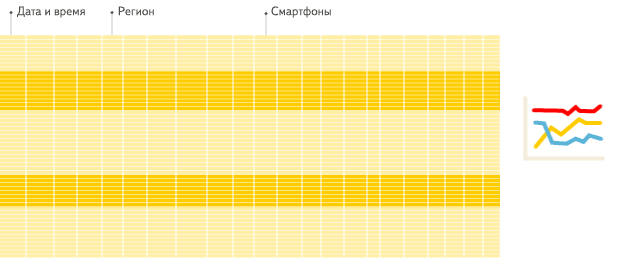
На последок давайте просто посмотрим как ребята из ClickHouse визуализирует работу своей БД.
Строковые СУБД
Столбцовые СУБД
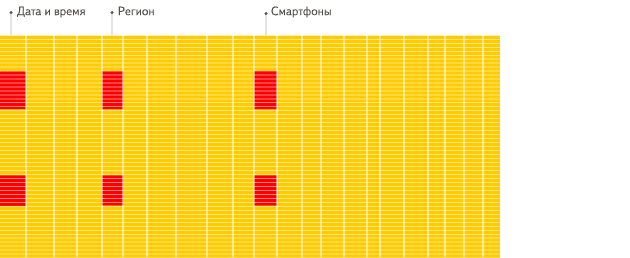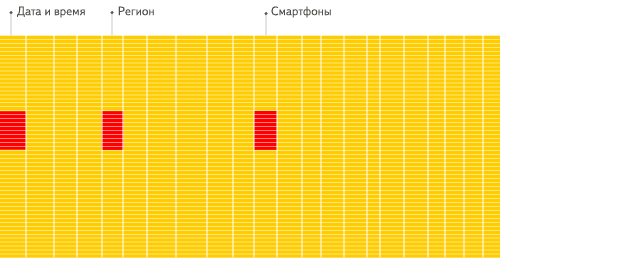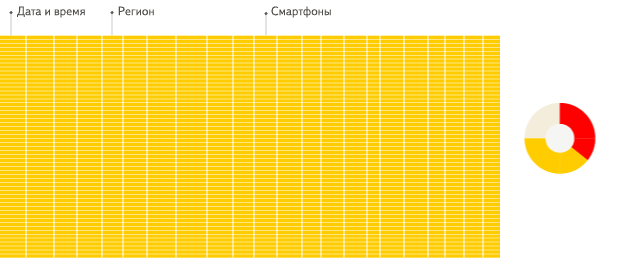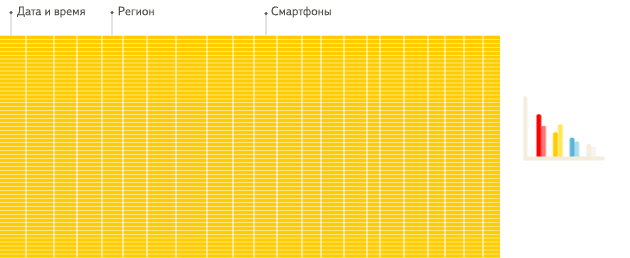
Физическая структура

Каждый узел в кластере может иметь от одной до двух ролей: data, ClickHouse Keeper.
Data
Узел данных хранит и обрабатывает запросы на запись и чтение. ClickHouse может быть запущен только на одном узле данных, при этом такой кластер не будет поддерживать Fault Tolerance и горизонтальное масштабирование.
ClickHouse Keeper
Если вы хотите сделать ваш кластер отказоусточивым, вам не обойтись без ClickHouse Keeper. ClickHouse Keeper предоставляет систему координации репликации данных и выполнения распределенных DDL-запросов. ClickHouse Keeper совместим с Apache ZooKeeper. ClickHouse Keeper запускается минимум на трех узлах для поддержания кворума.
Стоит заметить, что появление координатора в кластере не делает из него архитектуру репликации "репликация с одним ведущим узлом". Кластер работает без ведущих узлов, а координатор здесь для поддержки согласованности записи на разных узлах.
Если проще, то при вставке сегмента в реплику информация о вставке записывается в Clickhouse Keeper (формируя лог изменений для рассылки общий последовательности) и все остальные реплики могут прочитать информацию о пропущенном/необработанном куске и скачать его. Стоит обратить внимания, что куски скачиваются с другой реплики, а не с Clickhouse Keeper. Clickhouse Keeper скорее всего содержит последовательность хешей файлов.
Логическая структура
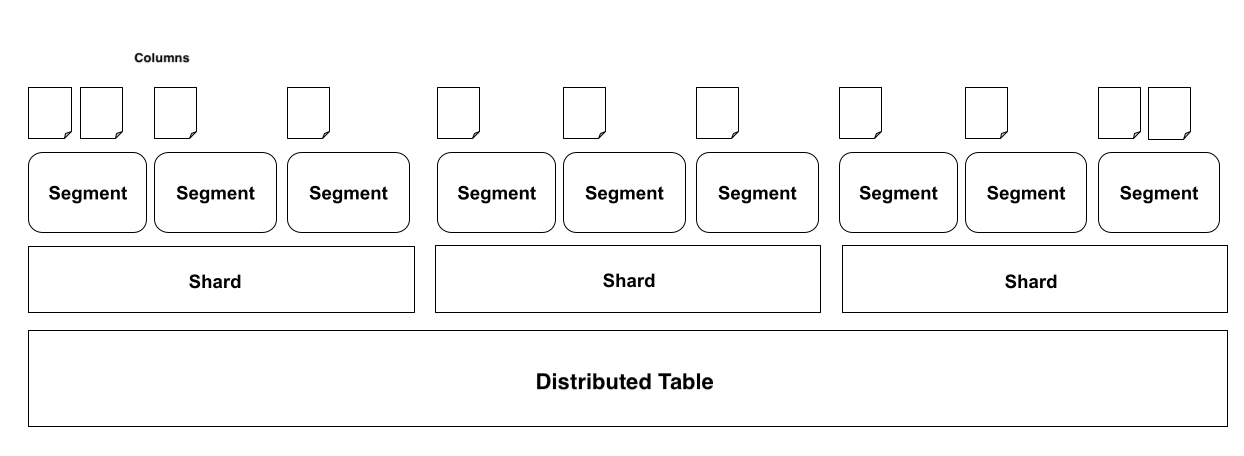
Distributed Table
Distributed Table не хранят никаких собственных данных, но позволяют распределенную обработку запросов на нескольких серверах. Чтение автоматически распараллеливается. При чтении используются индексы таблиц на удаленных серверах, если таковые имеются. По сути это навигация по локальным таблицам (Shard). ClickHouse старается сделать большенство вычислений на шардах, если это сделать не удается часть вычислнинных данных передается на узел Distributed Table. Distributed Table можно объявить на любом узле кластера.
Local Table (Shard)
Подмножество данных. ClickHouse всегда имеет хотя бы один сегмент для ваших данных, поэтому, если вы не распределяете данные по нескольким серверам, ваши данные будут храниться в одном сегменте. Разделение данных на несколько серверов можно использовать для разделения нагрузки, если вы превысите мощность одного сервера. Целевой сервер определяется ключом шардирования и определяется при создании распределенной таблицы. Ключ шардирования может быть случайным или представлять собой результат хэш-функции.
Replica
Копия данных. ClickHouse всегда имеет хотя бы одну копию данных, поэтому минимальное количество реплик — одна. Добавление второй реплики данных обеспечивает отказоустойчивость.
Segment + Columns
О сегментах и колонках я уже рассказывал в разделе "Структура данных". Но для закрепления еще раз покажу картинку хранения файлов одного сегмента.
Сценарии использования
Когда не стоит использовать:
- для хранения неструктурированных данных, например, видео, картинок, музыки, фильмов, роликов
- ClickHouse плохо подходит под OLTP нагрузки
- Key-Value сценарии
Когда стоит использовать:
- веб-аналитика и контекстная реклама;
- real time мониторинг бизнес-метрик, например, анализ потребительского поведения на сайте;
- интерактивное взаимодействие с пользователями, к примеру, онлайн-игры;
- контроль технических показателей, в т.ч. интернет вещей (Internet of Things);
- реализация корпоративных хранилищ данных.
Характеристики
Характеристики | Значение | Комментарий |
|---|---|---|
| Семейства баз данных | column oriented/base column | |
| Транзакционная модель | - | |
| Структуры данных | LSM-деревья | |
| Масштабирование | Горизонтальное партиционирование | |
| Репликация | без ведущего узла | но механиз репликации требует наличие координатора Clickhouse Keeper |
| Модели согласованности |
| Модель согласованности настраиваемая |
| CAP | AP | |
| PACELC | PA/EL | |
| Fault Tolerance | автоматически | |
| Primary Key | есть | |
| Partition Key | есть | |
| Foreigen Key | нету | |
| Локальный вторичный индекс | есть | |
| Глобальный вторичный индекс | нету | Хоть их и нет, но их можно смоделировать через batch операцией |
| Ограничение уникальности | нету | |
| JOINs | нету | В документации заявлены, но нужно понимать, что их использование не эффективно из-за разряженности индекса придется вычитывать большие куски информации. |
| Агрегации | есть | |
| Схема данных | есть | |
| Организация данных | денормализованная |
Ссылки: