ElasticSearch
Elasticsearch — поисковая система, разработанная Elastic и основанная на Apache Lucene. Помимо обеспечения быстрого полнотекстового поиска и нескольких функций анализа, его также можно расширить с помощью плагинов. Он работает путем распределения по нескольким узлам, что позволяет масштабировать производительность поиска.
Как и любой другой поисковой движок, elasticSearch работает на базе инвертированного индекса.
Модель данных
Когда мы говорим про поисковые движки, говорить про модель данных сложно. Сам инвертированный индекс это словарь терминов по которому можно найти документы содержащие этот термин. По мимо функционала поиска ElasticSearch позволяет хранить документы в сыром виде и теперь мы приходим в парадигму документной модели.
В общем рекомендации могут быть такими:
- денормализуйте. Поиск работает в пределах одного индекса (join не поддерживается)
- не злоупотребляйте наполнением индекса. Индекс всегда можно расширить.
Возможности
Поиск
Далее я постараюсь приоткрыть возможности БД.
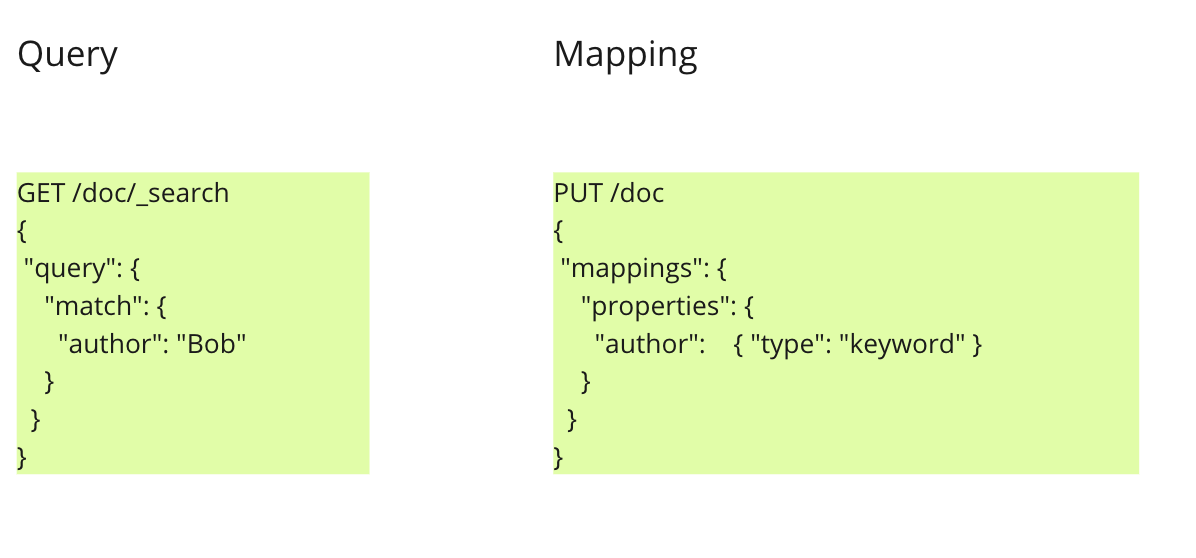
Поиск по точному совпадению
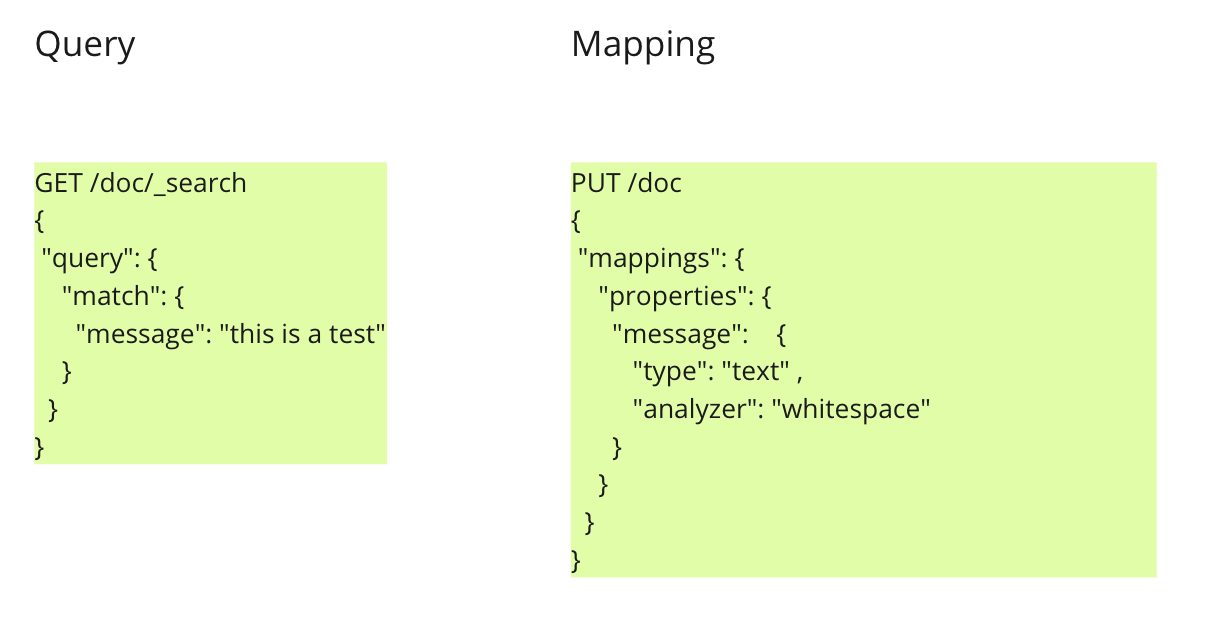
Поиск по тексту
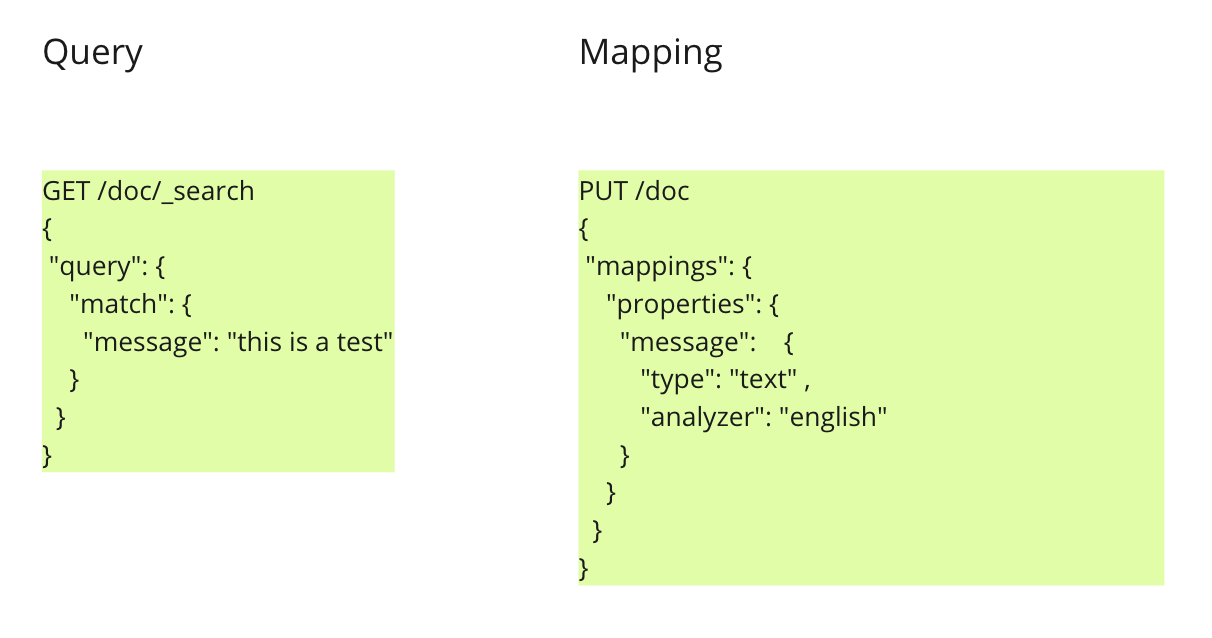
Поиск по тексту с учетом морфологии
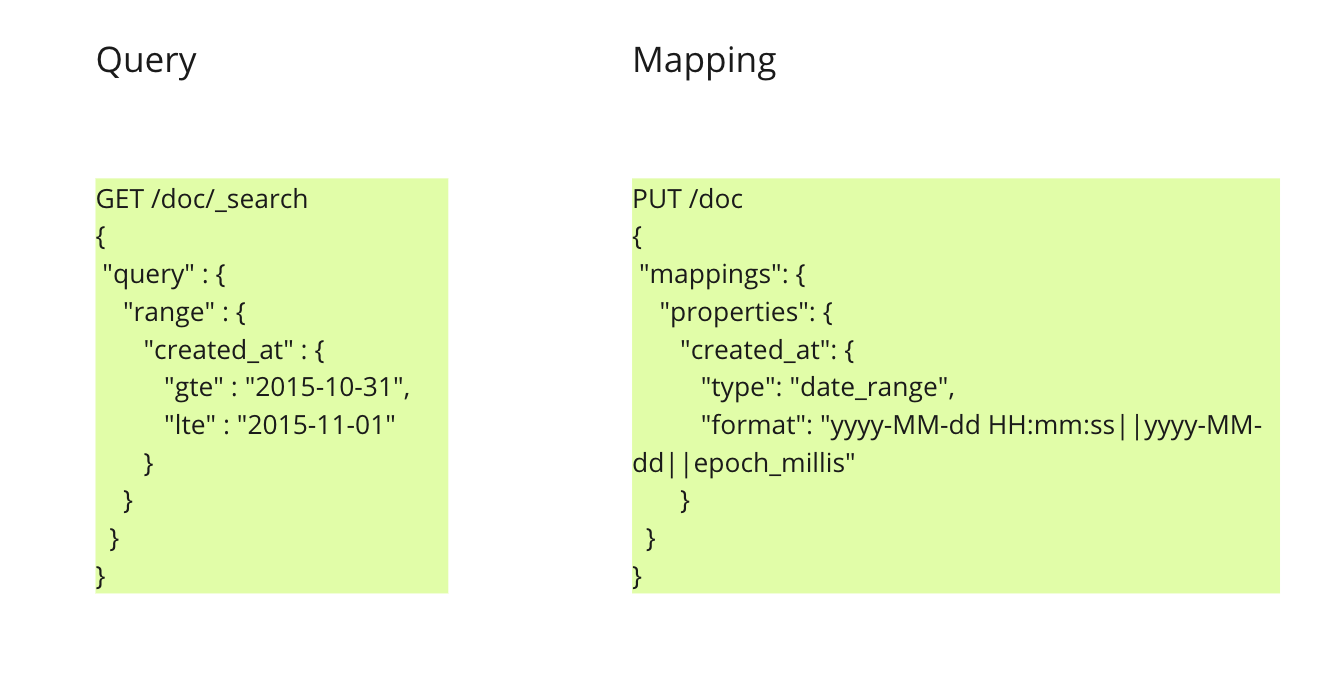
Поиск по диапазонам
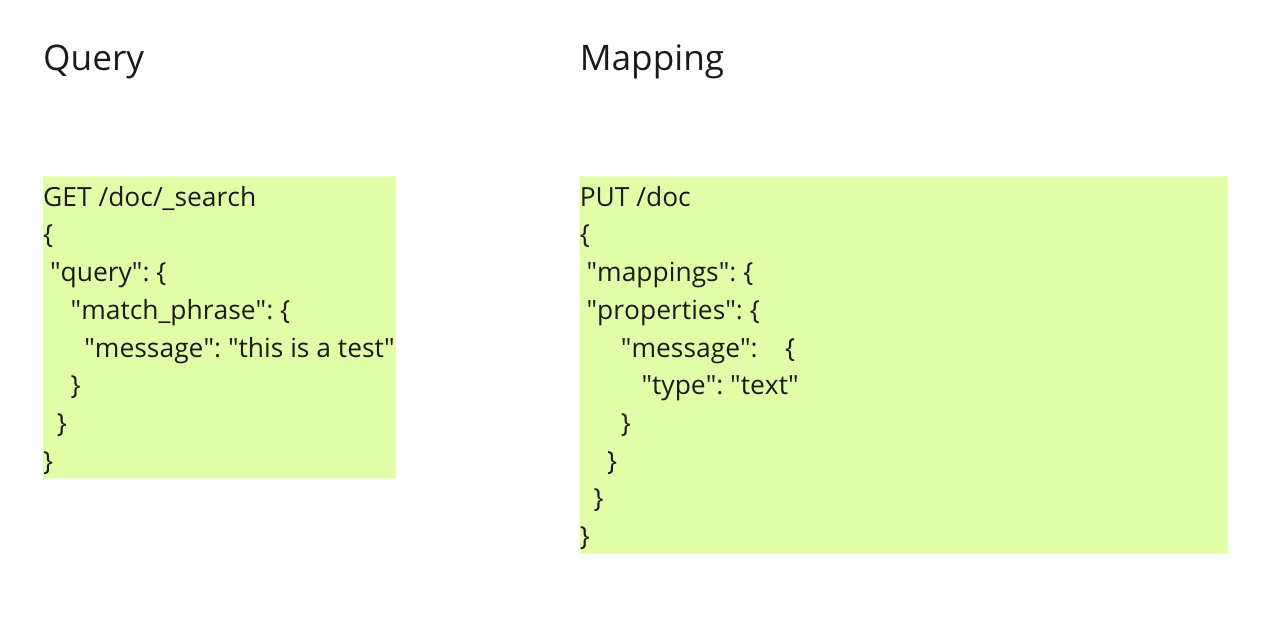
Фразовый поиск
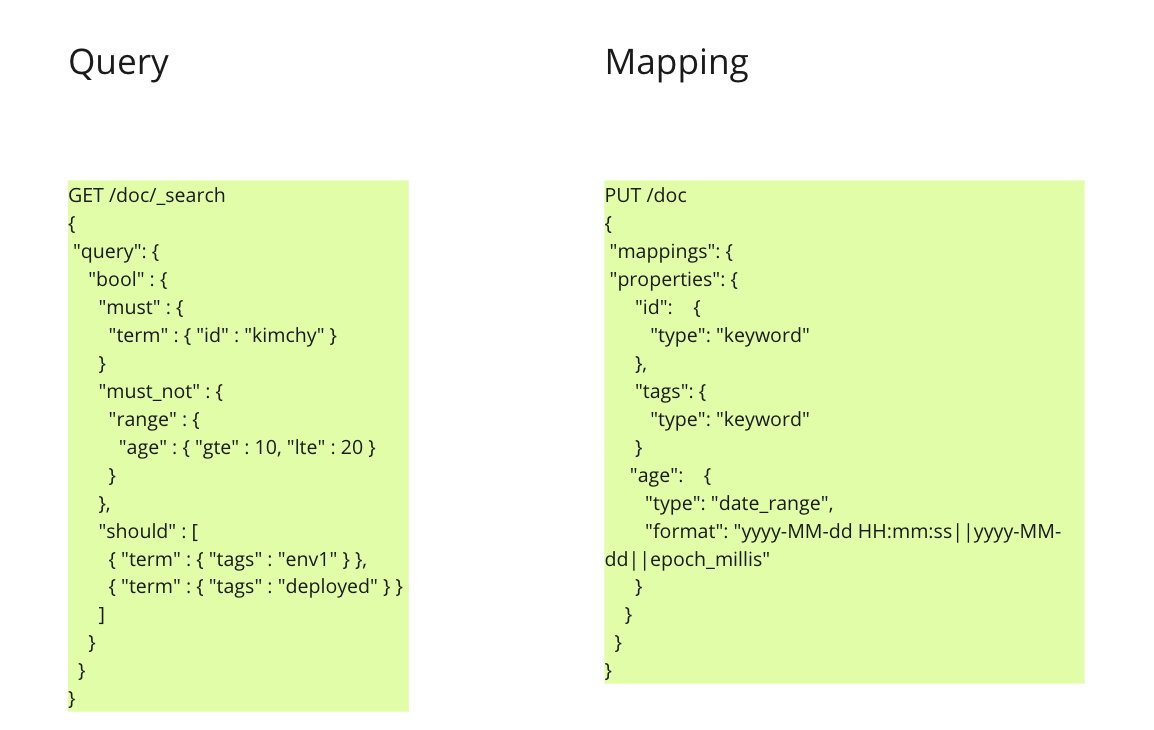
Логические выражения
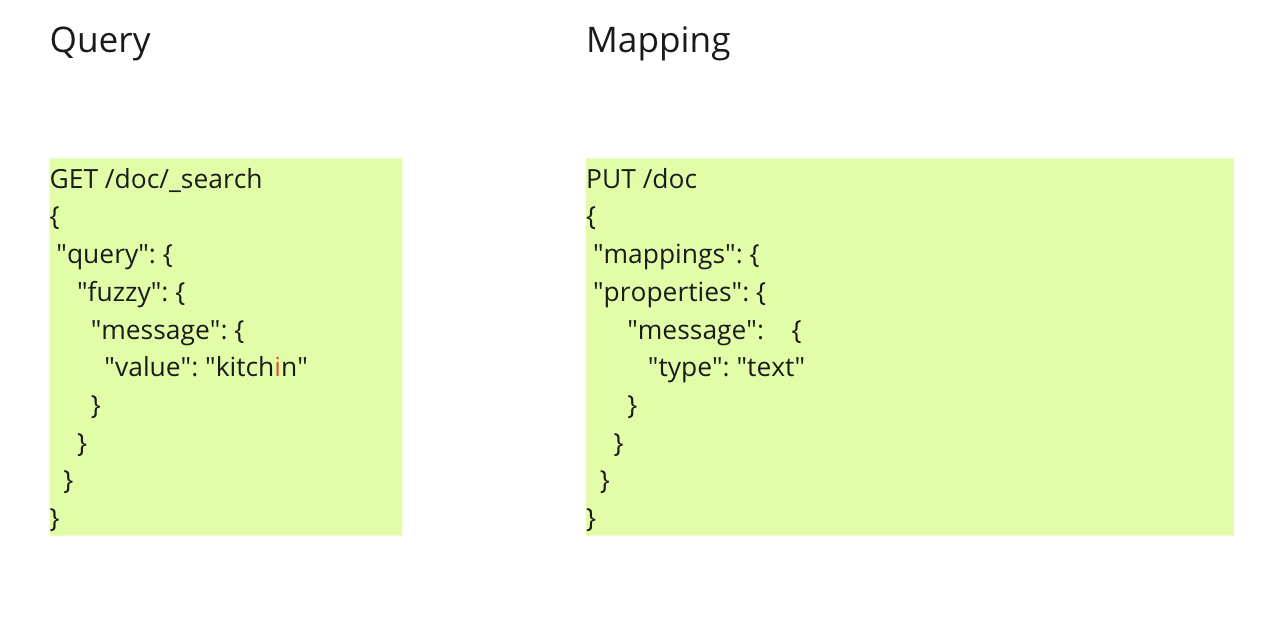
Фазированный поиск
И сотри других видов поиска
Агрегации
Т.к. для при поиске ElasticSearch приходится поднимать в память все совпадающие с поиском данные, для него не составляет проблем произвести аналитические расчеты на этих данных.
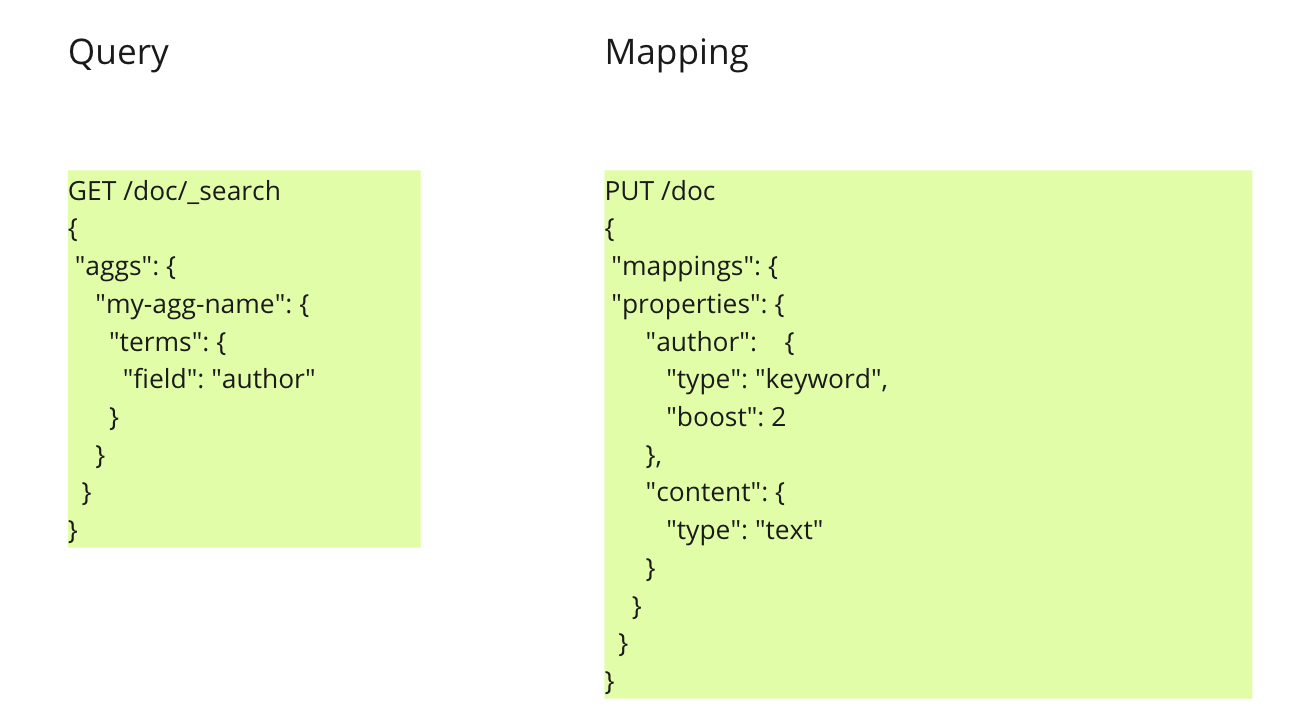
Для примера так выглядит самый простой запрос на агрегацию данных.
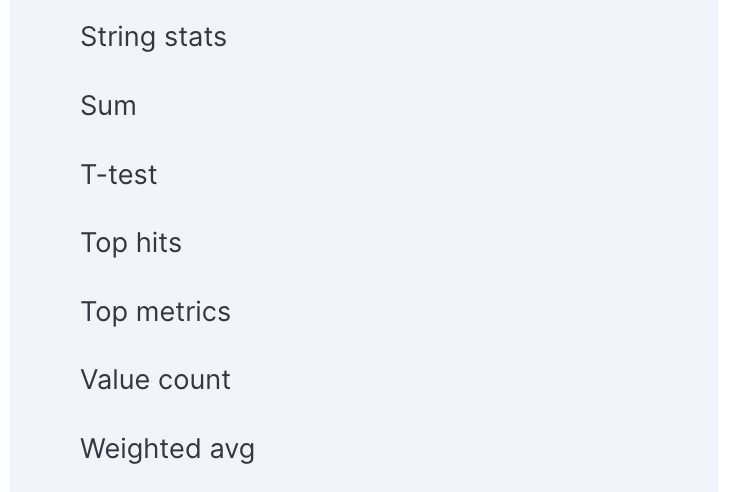
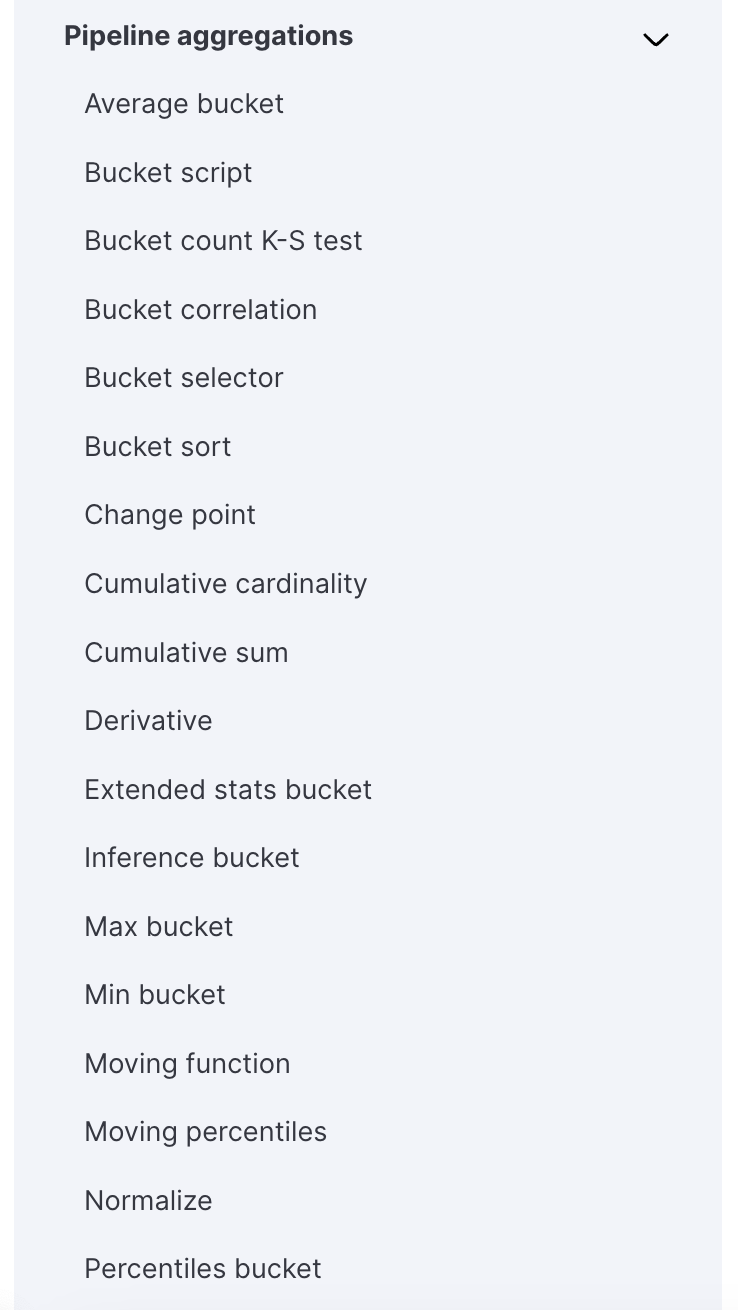
Далее просто скриншот документации апи агригаций.
Архитектура кластера
Физическое структура кластера
Пришло время посмотреть на реализацию кластера.
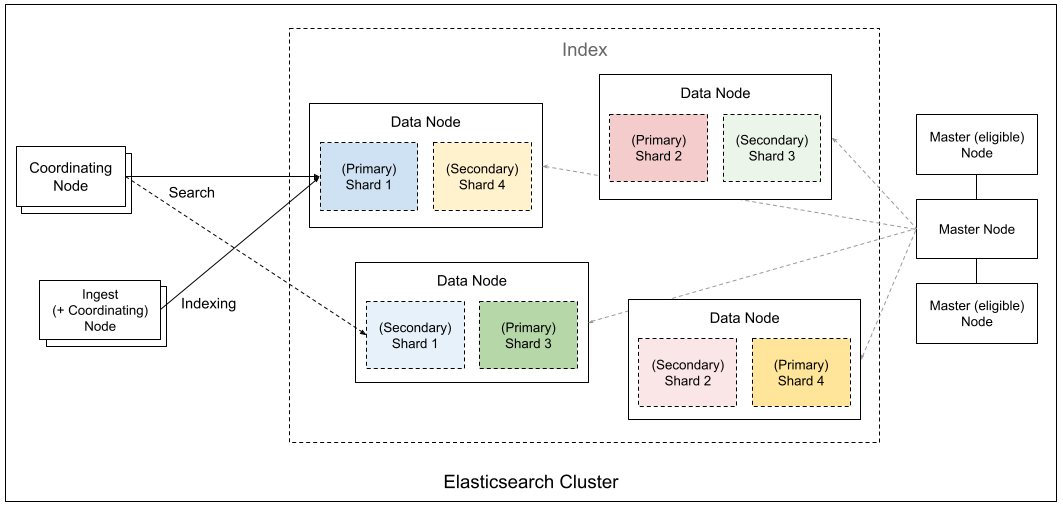
Каждый узел в кластере запускается с определенным перечнем ролей.
Master
Роль мастера отдается узлу, управляющему кластером. Этот главный узел должен состоять как минимум из трех серверов. Один сервер будет главным. Остальные будут установлены как запасные узлы (eligible), которые имеют право на роль главного узла, и им можно будет повысить роль главного узла, если главный узел выйдет из строя.
Мастер узел как раз отвечает за согласованность в кластере. Двух мастер узлов быть не может. Для выбора мастера используется кворумный механизм консенсуса.
Data
Как следует из названия, роль Data обрабатывает данные. Он хранит данные для поиска на уровне «шардов» и выполняет такие процессы, как поиск и агрегирование. Эти процессы требуют большого количества машинных ресурсов.
Ingest
Ingest преобразует документы при индексировании данных поиска. Не всегда эта роль есть в кластере. Часто данные в кластер отправляются подготовленными.
Coordinating
Координатор обрабатывает входящие запросы и решает, что с ними дальше делать:
- если это запрос на поиск, он отправляет его Data нодам и мержит полученные от них решультаты
- если это запрос на индексацию, но может его отправить напрямую в Data ноды или передать на вход Ingest ноде
- если это запрос на управление кластером, но перенаправит его Master ноде
Логическая структура
Далее давайте посмотрим на внутреннюю структуру индекса, содержащего данные Elasticsearch.
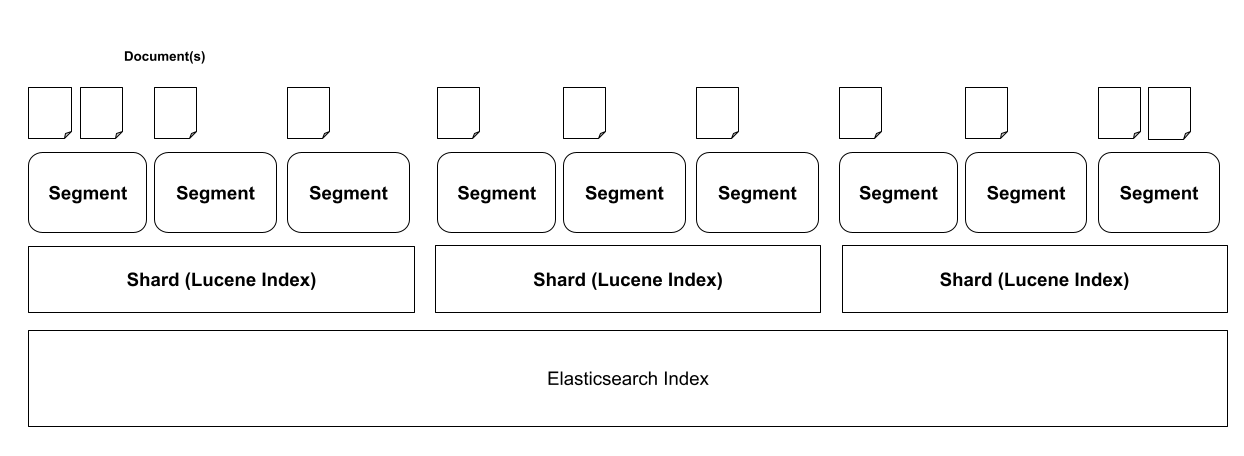
Elasticsearch Index
Индекс Elasticsearch можно рассматривать как набор документов в кластере Elasticsearch. В кластере Elasticsearch можно создать несколько индексов для управления документами.
Shard
Шарды распределяются на основе количества указанных индексов. Количество шардов определяется при определении индексов, и существуют некоторые ограничения на изменение этого числа после его установки. Данные управляются внутри с помощью индекса Lucene.
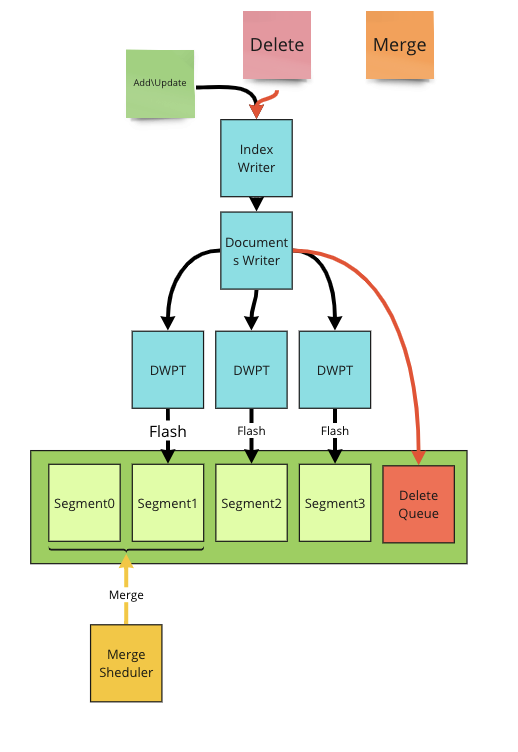
Рисунок ниже показывает логическое представление Lucene индекса. По сути это LSM-дерево.
Replica
Это копия шардов. Шард, который напрямую получает обновления, называется «primary shard», а его копия — «replica shard». Количество реплик влияет на доступность и производительность поиска и может быть изменено в любое время. Если основной шард по какой-либо причине утерян, один из его реплик будет повышен до primary шарда.
Segment
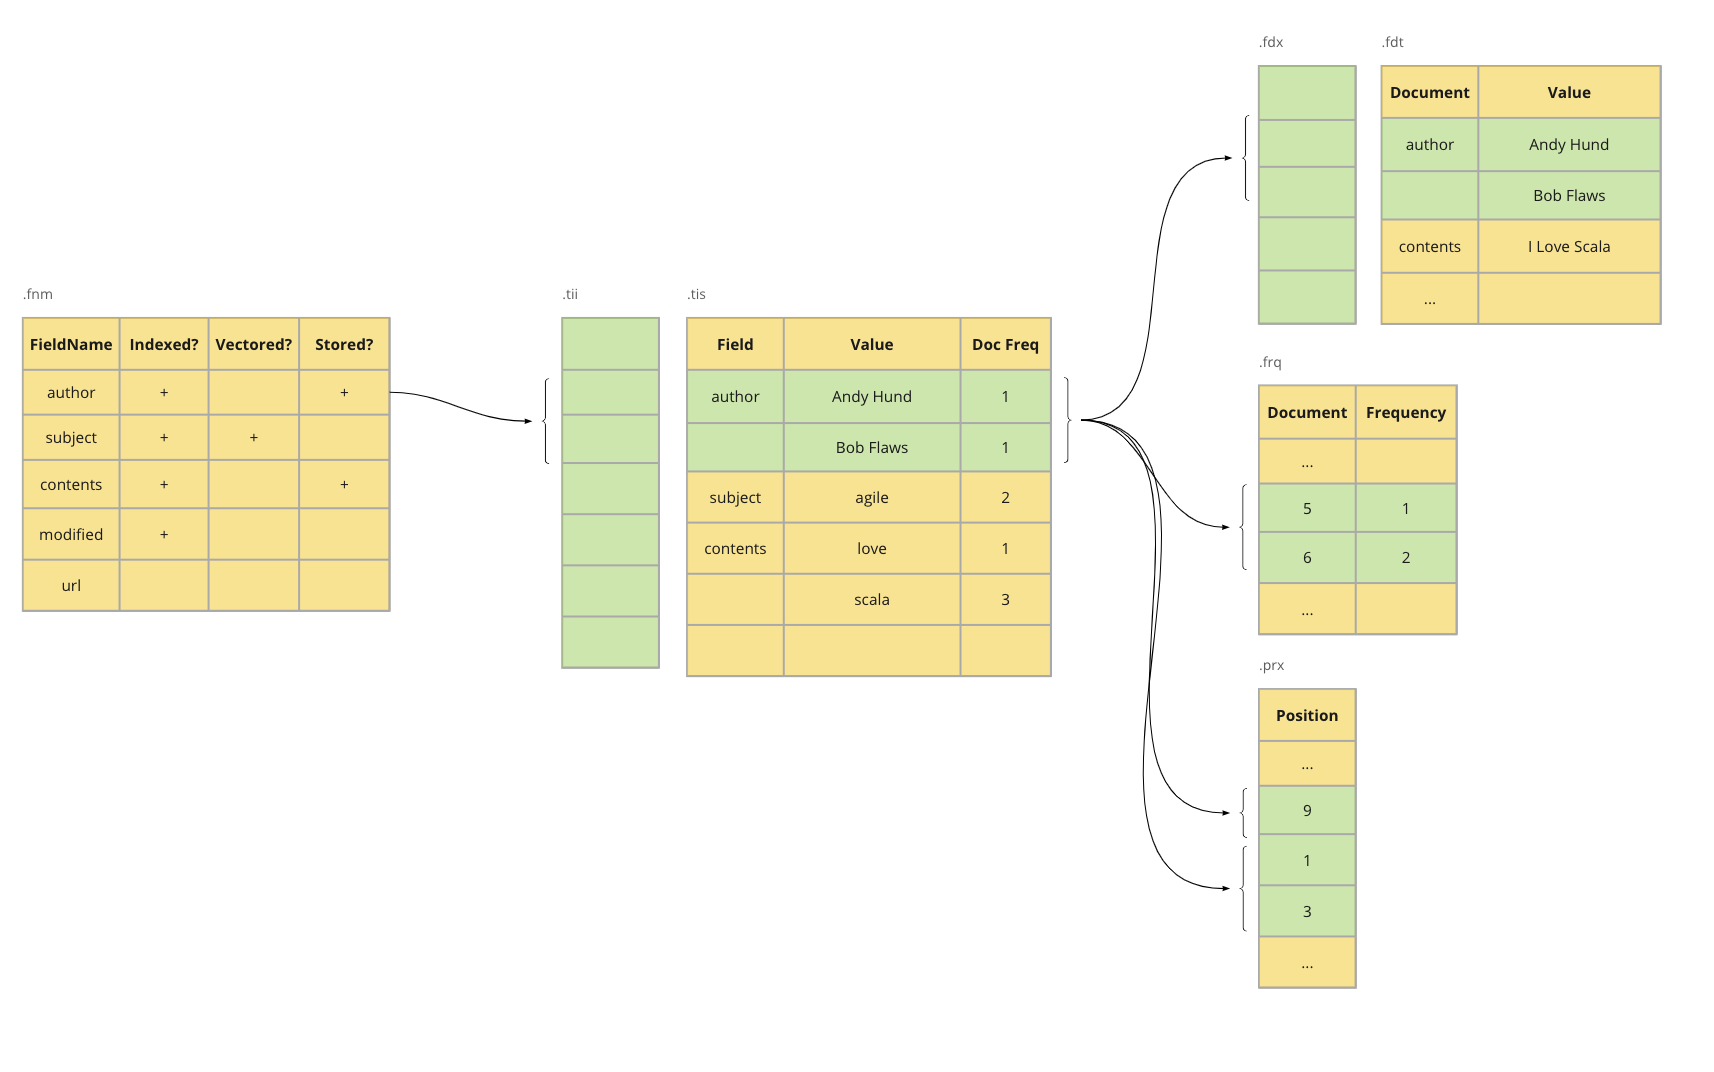
Индекс Lucene, управляемый шардами, управляет группами документов на так называемом уровне «сегментов». Сегменты, как правило, неизменяемы, поэтому удаление документа фактически не приведет к его удалению из сегмента. Вместо этого генерируется запись о том, что документ был удален (другими словами, он удален логически, а не физически). Это приведет к постепенному увеличению размера данных, поэтому сегменты будут регулярно объединяться, исключая все удаленные документы.
Рисунок ниже показывает логическое представление сегмента.
Document
Один документ представляет собой один фрагмент данных.
Ложка дёгтя
Ничего не дается бесплатно. За свою универсальность ElasticSearch платит стоимостью. Инвертированный индекс по своей природу очень требователен к памяти и процессорному времени, а с учетом того, что он распределенный все ухудшается в разы.
Характеристики
Характеристики | Значение | Комментарий |
|---|---|---|
| Семейства баз данных |
| ElasticSearch позволяет кроме индекса хранить и сами документы |
| Структуры данных |
| |
| Архитектура распределения нагрузки | shared-nothing architectures | |
| Репликация | один ведущий узел | |
| Партиционирование | Горизонтальное партиционирование | |
| Вторичные индексы | глобальные индексы | Но есть возможности лакильности. ElasticSearch предоставляет time based индексы. |
| Модели согласованности |
| В реализации ElasticSearch есть операции compare-and-set, что говорит нам о линеаризуемости. Можно предположить, что операции с документам могут быть линеаризуемы. Операции же поиска согласованны в конечном счете с операциями записи. |
| CAP | AP | ElasticSearch стремиться к согласованности, но не в понятии линеаризуемости. |
| PACELC | PA/EC | |
| HA кластер | автоматический | |
| Сложность управления и конфигурации | Просто |
Ссылки