Redis

Redis (Remote Dictionary Server) - резидентская СУБД, работающая с данными ключ-значение и относящаяся к классу NoSQL. Предлагается, как максимально быстрое и легкое решение, в следствии чего самым распространенным применением Redis является key-value кэш.
Модель данных
Данные в Redis хранятся в виде ассоциативного массива, но при этом поддерживается множество абстрактных типов, таких как строки, списки, множества, хеш-таблицы, упорядоченные множества. Ключ записи всегда индексируеся и выступает в роли первичного ключа.
| Тип | Описание | R/W |
|---|---|---|
| String | Строки, целочисленные или числа с плавающей точкой | Операции над целыми строками, их частями и инкремент/декремент чисел |
| List | Связный список строк | Вставка и вытягивание с головы и хвост, обрезание по смещению. Чтение одного или нескольких элементов, поиск и удаление по значению |
| Set | Несортированная коллекция уникальных строк | Добавление, получение или удаление элемента, проверка наличия, получение случайного элемента, intersect, union, difference |
| Hash | Несортированная хэш-таблица пар ключ-значение | Добавление, получение или удаление элемента, получение всей хэш-таблицы |
| ZSet | Отсортированное отображение строк на вещественную оценку (score), сортировка по "оценке"(score) | Добавление, получение или удаление отдельных значений, получение элементов по промежутку оценок(score) |
| Stream | Append-only лог с произвольным доступом О(1) | Добавление, получение одной и более записи, получение диапазона записей, длина потока |
| Bitmap | Сам по себе не реальный тип данных, а набор операций над String, как битовым вектором | Установка бита, получение бита, побитовые операции между 2..N строк |
String
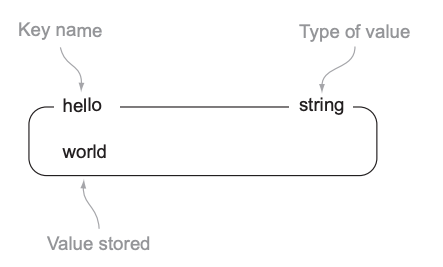
Строки хранят последовательность байтов, включая тексты, серилизуемые объекты и бинарные массивы. Это простейший из типов, которые можно соотнести с ключом. Значения строк имеют ограничение в 512Mb.
Строки могут быть использованы для простого кеша:
> SET bike:1 Deimos
OK
> GET bike:1
"Deimos"
SET и GET используются для установки и получения значений. Следует помнить, что SET перезаписывает значения, в случае коллизии ключей. У команды SET есть интересные опции, которые предоставляются в качестве дополнительных аргументов. Например, есть возможность попросить SET завершиться неудачей, если ключ уже существует, или наоборот, чтобы он завершился успешно только в том случае, если ключ уже существует:
> SET bike:1 bike nx
(nil)
> SET bike:1 bike xx
OK
Так же имеется возможность за одну команду устанавливать или получать множество значений с помощью MSET и MGET:
> MSET bike:1 "Deimos" bike:2 "Ares" bike:3 "Vanth"
OK
> MGET bike:1 bike:2 bike:3
1) "Deimos"
2) "Ares"
3) "Vanth"
Или атомарный счетчик:
> SET total_crashes 0
OK
> INCR total_crashes
(integer) 1
> INCRBY total_crashes 10
(integer) 11
INCR пытается получить число из строки и увеличивает на единицу, устанавливая полученное значение по ключ. Аналогично используются команды INCRBY, DECR, DECRBY.
Большинство операций над строками происходит за O(1).
List
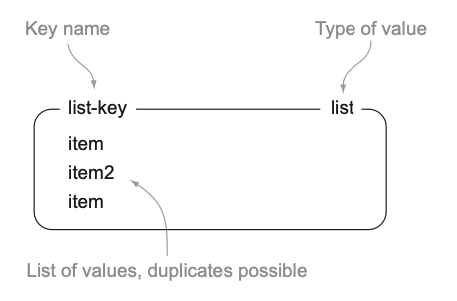
Списки Redis являются связными списками строковых значений и часто используются для реализации стеков и очередей.
Тк список является связным, то добавление элемента в голову или хвост не зависит от от количества элементов списка и выполняется за константное время.
Пример добавления и получения элементов из списка:
> RPUSH bikes:repairs bike:1
(integer) 1
> RPUSH bikes:repairs bike:2
(integer) 2
> LPUSH bikes:repairs bike:important_bike
(integer) 3
> LRANGE bikes:repairs 0 -1
1) "bike:important_bike"
2) "bike:1"
3) "bike:2"
Список может содержать до 2^32 - 1 (4,294,967,295) элементов, а операции добавления в голову или хвост занимают O(1), в то время как операции с элементами внутри списка обычно проходят за O(n).
Set
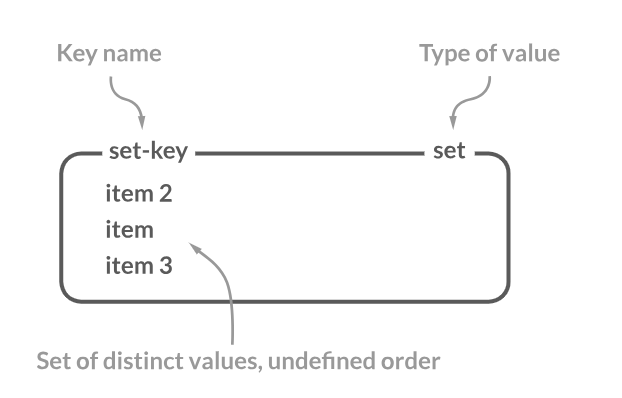
Множество является неупорядоченной коллекцией уникальных элементов и применяется для:
- Отслеживания уникальных элементов
- Представление отношений
- Выполнения общих операций над множествами, такими как пересечение, объединение или разность
Примеры:
> SADD bikes:racing:france bike:1
(integer) 1
> SADD bikes:racing:france bike:1
(integer) 0
> SADD bikes:racing:france bike:2 bike:3
(integer) 2
> SADD bikes:racing:usa bike:1 bike:4
(integer) 2
> SINTER bikes:racing:france bikes:racing:usa
1) "bike:1"
Множество может содержать до 2^32 - 1 (4,294,967,295) элементов. Большая часть операций, таких как добавление, удаление и проверка наличия выполняются за O(1).
Hash
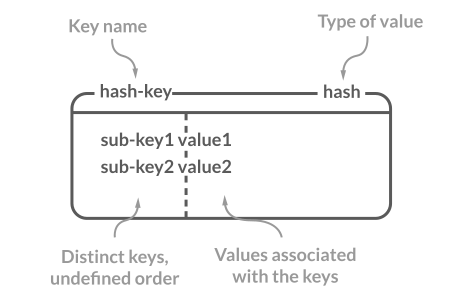
Хэш-таблицы Redis - тип записей, структурированных как коллекция поле-значение. Хотя хеш-таблицы удобны для представления объектов, на самом деле количество полей, которые вы можете поместить в хеш, не имеет практических ограничений (кроме доступной памяти), поэтому вы можете использовать хэши в своем приложении разными способами.
Пример:
> HSET bike:1 model Deimos brand Ergonom type 'Enduro bikes' price 4972
(integer) 4
> HGET bike:1 model
"Deimos"
> HGET bike:1 price
"4972"
> HGETALL bike:1
1) "model"
2) "Deimos"
3) "brand"
4) "Ergonom"
5) "type"
6) "Enduro bikes"
7) "price"
8) "4972"
Может содержать до 4,294,967,295 (2^32 - 1) пар поле-значение (на практике количество данных в хэше ограничено лишь количеством доступной памяти), а большинство команд выполняются за O(1). НО такие команды, как HKEYS, HVALS или HGETALL требуют O(n).
ZSet
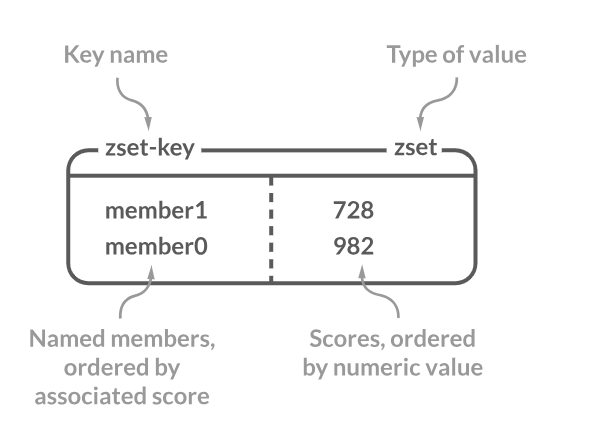
ZSet - это коллекция уникальных строк, упорядоченных по связанной оценке. Если несколько строк имеют одинаковую оценку, строки упорядочиваются лексикографически. Как и множества, ZSet состоит из уникальных, неповторяющихся строк, поэтому в некотором смысле также является хэш-таблицей. Однако, хотя элементы внутри не упорядочены, каждый элемент в ZSset связан с вещественным занчением, называемым оценкой (вот почему этот тип также похож на хэш, поскольку каждый элемент сопоставлен со значением). Причем элементы берутся по порядку (поэтому они не упорядочиваются по запросу, порядок — это особенность структуры данных, используемой для представления ZSet). Они упорядочены по следующему правилу: Если B и A — два элемента с разной оценкой, то A > B, если A.score > B.score. Если B и A имеют одинаковый балл, то A > B, если строка A лексикографически больше строки B. Строки B и A не могут быть равными, поскольку отсортированные множества содержат только уникальные элементы.
Пример:
> ZADD racer_scores 0 "Norem" 0 "Sam-Bodden" 0 "Royce" 0 "Castilla" 0 "Prickett" 0 "Ford"
(integer) 3
> ZRANGE racer_scores 0 -1
1) "Castilla"
2) "Ford"
3) "Norem"
4) "Prickett"
5) "Royce"
6) "Sam-Bodden"
> ZRANGEBYLEX racer_scores [A [L
1) "Castilla"
2) "Ford"
Большая часть операций с ZSet выполняются за O(log(n)), где n - количество элементов множества.
Stream
Поток в Redis - структура данных, действующая как журнал только для добавления, но так же реализующий некоторые не специфичные для append-only лога. К ним относится произвольный доступ за O(1) и множественные консюмеры. Redis генерирует уникальный идентификатор для каждой записи потока, которые, в свою очередь, могут быть использованы для получения связанных с ними записей или для чтения и обработки всех последующих за ними записей.
Пример:
## Добавления записей в поток
> XADD race:france * rider Castilla speed 30.2 position 1 location_id 1
"1692632086370-0"
> XADD race:france * rider Norem speed 28.8 position 3 location_id 1
"1692632094485-0"
> XADD race:france * rider Prickett speed 29.7 position 2 location_id 1
"1692632102976-0"

## Чтение первых двух записей, начиная с переданного идентификатора
> XRANGE race:france 1692632086370-0 + COUNT 2
1) 1) "1692632086370-0"
   2) 1) "rider"
      2) "Castilla"
      3) "speed"
      4) "30.2"
      5) "position"
      6) "1"
      7) "location_id"
      8) "1"
2) 1) "1692632094485-0"
   2) 1) "rider"
      2) "Norem"
      3) "speed"
      4) "28.8"
      5) "position"
      6) "3"
      7) "location_id"
      8) "1"
Bitmap
Битовый вектор в Redis - не самостоятельный тип, а набор операций над строками. Поскольку строки представляют собой двоично-безопасные двоичные объекты и их максимальная длина составляет 512 МБ, они подходят для установки до 2^32 различных битов. Вы можете выполнять побитовые операции с одной или несколькими строками. Некоторые примеры использования битовых векторов включают в себя:
- Эффективные представления наборов для случаев, когда члены набора соответствуют целым числам от 0 до N
- Пермишены объекта, где каждый бит представляет определенное разрешение, аналогично тому, как файловые системы реализуют права доступа
Пример:
## Установить значение
> SETBIT pings:2024-01-01-00:00 123 1
(integer) 0

## Прочитать 123 бит
> GETBIT pings:2024-01-01-00:00 123
1

## Прочитать 456 бит
> GETBIT pings:2024-01-01-00:00 456
0
SETBIT и GETBIT выполняются за O(1). BITOP, в свою очередь, за O(n), где n — длина самого длинного вектора в сравнении.
Доступ к данным
Протокол RESP(REdis serialization protocol)
Для общения с сервером клиенты используются протокол RESP, разработанный с учетом следующих свойств:
- Легкость реализации
- Быстрота разбора
- Человекочитаем
RESP позволяет сериализовать различные типы данных, такие как строки, целые числа, массивы. Так же он имеет специальный тип данных для ошибок. Это бинарный протокол, где весь запрос является последовательностью строк, закодированных в стандарте ASCII. На первом месте всегда находится передаваемая команда, все последующие элементы будут считаться аргументами. CRLF (\r\n), в свою очередь, является треминальным символом.
Тип полезной нагрузки опредляет ее первый байт, примером может служить простая строка
+OK\r\n, где + - определяет тип данных, как строку, а \r\n указывают на конец
Более подробно изучить протокол RESP можно из официальной документации.
Возможности
Key expiration
Одна из важнейших особенностей Redis - наличие срока жизни ключа (TTL Time To Live) не зависимо от типа хранимых данных. По истечению срока жизни ключ, как и ассоциируемые с ним данные, удаляются. Пример установки с командой EXPIRE:
> SET key some-value
OK

> EXPIRE key 5
(integer) 1

> GET key (immediately)
"some-value"

> GET key (after some time)
(nil)
Так же можно задавать TTL при исполнение других команд, например SET:
> SET key 100 ex 10
OK

> TTL key
(integer) 9
Вызов команды TTL вернет оставшееся время жизни ключа (для получения времени жизни в миллисекундах используется команда PTTL).
Scan
Команда SCAN необходима для последовательного перебора ключей по заданному паттерну. При этом команда имеет параметр cursor, что позволяет производить пагинацию данных, тем самым даже если под паттерн попадает большое количество ключей - мы можем обрабатывать их небольшими порциями, не получая длительных блокировок на получении всего набора. Каждый вызов SCAN выполняется за O(1), и требует O(N) для полного обхода.
Так же существуют модификации команды SCAN для разных типов данных:
- SCAN обходит список ключей
- SSCAN обходит множества Set
- HSCAN обходит поля типов Hash и связанных с ними значений
ZSCAN обходит элементы типов ZSet и связанные с ними оценки
| Команда | Синтаксис | Описание |
|---|---|---|
| SCAN | SCAN cursor [MATCH pattern] [COUNT count] [TYPE type] | Возвращает ключи, попадающему под паттерн pattern |
Команда SCAN и другие команды семейства SCAN могут предоставить пользователю набор гарантий, связанных с полными итерациями:
- Полная итерация всегда извлекает все элементы, которые присутствовали в коллекции от начала до конца полной итерации. Это означает, что если данный элемент находится внутри коллекции в момент начала итерации и все еще находится там, когда итерация завершается, то в какой-то момент SCAN возвращает его клиенту
- Полная итерация никогда не возвращает ни одного элемента, который НЕ присутствовал в коллекции от начала до конца полной итерации. Таким образом, если элемент был удален до начала итерации и никогда не добавляется обратно в коллекцию за все время, пока длится итерация, SCAN гарантирует, что этот элемент никогда не будет возвращен
Однако, поскольку у SCAN очень мало состояний (только cursor), у него есть следующие недостатки:
- Элемент может быть возвращен несколько раз. Приложение должно обрабатывать случай дублирования элементов, например, используя только возвращенные элементы для выполнения операций, которые безопасны при повторном применении несколько раз
Альтернативой команды SCAN может служить команда KEYS
| Команда | Синтаксис | Описание |
|---|---|---|
| KEYS | KEYS pattern | Возвращает ключи, попадающие по паттерн pattern |
Но, в отличии от SCAN, команда KEYS блокирует сервер REDIS, пока не вернутся все ключи. Выполняется всегда за O(N), где N - количество ключей в базе данных.
Пример:
> MSET firstname Jack lastname Stuntman age 35
"OK"

> KEYS *name*
1) "lastname"
2) "firstname"

> KEYS a??
1) "age"

> KEYS *
1) "age"
2) "lastname"
3) "firstname"
Pub/Sub
Redis позволяет организовать паттерн Publish/Subscribe, где сообщения отправляются не конкретному потребителю, а всем получателям, подписанным на канал. В redis Pub/Sub используются следующие команды:
| Команда | Синтаксис | Описание |
|---|---|---|
SUBSCRIBE | SUBSCRIBE channel [channel ...] | Подписывает клиента на 1..N каналов |
UNSUBSCRIBE | UNSUBSCRIBE [channel [channel ...]] | Отписывает клиента от 1..N каналов или от всех при отсутствии аргументов |
PUBLISH | PUBLISH channel message | Отправляет переданное сообщение в указанный канал |
| | Подписывает клиента на все каналы, удовлетворяющие переданному паттерну |
PUNSUBSCRIBE | | Отписывает клиента от всех каналов, попадающий под паттерн |
SSUBSCRIBE | SSUBSCRIBE shardchannel [shardchannel ...] | Подписывает клиента на 1..N шардированных каналов |
| SUNSUBSCRIBE | SUNSUBSCRIBE [shardchannel [shardchannel ...]] | Отписывает клинета от 1..N шардированных каналов или от всех при отсутствии аргументов |
SPUBLISH | SPUBLISH shardchannel message | Отправляет переданное сообщение в указанный шардированный канал |
Во время подписки клиент не может отправлять команды, но может подписаться или отписаться от других каналов.
Пример:
## Первый клиент подписывается на 2 топик
> SUBSCRIBE first second
*3
$9
subscribe
$5
first
:1
*3
$9
subscribe
$6
second
:2

## Второй клиент отправляет сообщение
> PUBLISH second Hello

## Первый клиент получает сообщение в запущенной сессии
*3
$7
message
$6
second
$5
Hello
Queue
С помощью типа данных List в Redis можно организовать примитивную очередь или стек. Для этого имеются следующие команды:
| Команда | Синтаксис | Описание |
|---|---|---|
| LPUSH | LPUSH key element [element ...] | Вставляет 1..N элементов в голову списка по ключу key |
| RPUSH | RPUSH key element [element ...] | Вставляет 1..N элементов в конец списка по ключу key |
| LPOP | LPOP key [count] | Удаляет и возвращет один или count элементов списка с головы по ключу key |
| RPOP | RPOP key [count] | Удаляет и возвращает один или count элементов списка с конца по ключу key |
| LLEN | LLEN key | Возвращает длину списка по ключу key |
| BLPOP | BLPOP key [key ...] timeout | Удаляет и возвращает элемент или элементы (из множества списков по ключу) с головы списка. Если список пуст - блокируется до появления элемента или ждем указанный timeout |
| BRPOP | BRPOP key [key ...] timeout | Удаляет и возвращает элемент или элементы (из множества списков по ключу) с конца списка. Если список пуст - блокируется до появления элемента или ждем указанный timeout |
Пример FIFO:
> LPUSH bikes:repairs bike:1
(integer) 1
> LPUSH bikes:repairs bike:2
(integer) 2
> RPOP bikes:repairs
"bike:1"
> RPOP bikes:repairs
"bike:2"
Пример FILO:
> LPUSH bikes:repairs bike:1
(integer) 1
> LPUSH bikes:repairs bike:2
(integer) 2
> LPOP bikes:repairs
"bike:2"
> LPOP bikes:repairs
"bike:1"
Пакетные операции
Pipelining в Redis зовется возможность передачи серверу множества команд за один раз без необходимости ожидания ответа от каждой отдельно выполненной команды. В отличии от обычного взаимодействия, когда мы читаем ответ после каждой отправленной команды, pipelining возвращает ответ один раз по завершению всех переданных команд. Так же важно помнить, что все результаты хранятся в памяти, пока не будут исполнены все переданные команды.
Индексирование
Хоть Redis изначально и предполагал доступ только по первичному ключу он может создавать и вторичные индексы, в том числе и составные.
Простейший числовой вторичный индекс можно создать для упорядоченного множества (ZSet). Внутри ZSet элементы отсортированы в порядке возрастания "балла". Поскольку
"баллы" представляют собой числа с плавающей точкой, индексы, которые можно построить с помощью ZSet, ограничены случаем, где индексируемое поле представляет собой число в заданном диапазоне. Две команды для создания таких индексов — это ZADD и ZRANGEBYSCORE, которые добавляют и извлекают элементы в указанном диапазоне. Например, можно индексировать множество имен людей по их возрасту, добавляя элемент в отсортированное множество. Элементом будет имя человека, а баллом будет возраст.
> ZADD myindex 25 Manuel
Ok
> ZADD myindex 18 Anna
Ok
> ZADD myindex 35 Jon
Ok
> ZADD myindex 67 Helen
Ok
И, соответственно, извлечение
> ZRANGEBYSCORE myindex 20 40
1) "Manuel"
2) "Jon"
В целом мы можем захотеть проиндексировать какое-то поле объекта
> HMSET user:1 id 1 username antirez ctime 1444809424 age 38
Ok
> HMSET user:2 id 2 username maria ctime 1444808132 age 42
Ok
> HMSET user:3 id 3 username jballard ctime 1443246218 age 33
Ok
Для создания индекса можно выполнить
> ZADD user.age.index 38 1
Ok
> ZADD user.age.index 42 2
Ok
> ZADD user.age.index 33 3
Ok
Транзакции
Транзакции в Redis не являются "транзакциями" в общепринятом понятии. Как минимум в них отсутствует понятие "rollback". Для исполнения транзакций используются следующие команды:
- MULTI - точка входа в транзакцию, последующие команды клиента помещаются в очередь
- EXEC - запуск транзакции
- DISCARD - отмена транзакции
- WATCH - средство обеспечения CAS
Транзакция Redis позволяет выполнить группу команд за одно обращение, при этом гарантируя, что
- Все команды в транзакции сериализуемы и выполняются последовательно. Другие команды, отправленные любым другим клиентом, не будут исполнены в середине исполнения транзакции, что гарантирует исполнение команд как изолированной операции.
- Команда EXEC запускает выполнение всех переданных команд в транзакции, поэтому если клиент теряет соединение до вызова EXEC - ни одна команда не будет исполнена на сервере.
Ошибки при работе с транзакциями сводятся к двум типам - ошибкам команд до и после вызова EXEC.
Ошибки ДО вызова EXEC могут быть связаны с неправильным синтаксисом, или нарушению каких-либо критичных ограничений (начиная с версии 2.6.5 сервер может сам определить ошибки на этапе добавления команд в очередь, а вызов EXEC вернет ошибку и отклонит транзакцию, в версиях до 2.6.5 клиенту необходимо самому проверять ответ каждой отправленной команды (в нормальной ситуации добавление команды в очередь исполнения транзакции возвращает QUEUED) и отменять исполнение командой DISCARD).
Ошибки ПОСЛЕ вызова EXEC не имеют специальной обработки. Таким образом, после вызова exec все команды в очереди, завершившиеся ошибкой, никак не будут влиять на исполнение следующих команд.
Оптимистичная блокировка. С помощью команды WATCH мы можем сделать ограничение по ключу, и если по ключу будет изменения до вызова EXEC - вся транзакция отклонится (снять заранее установленные ограничения можно командой UNWATCH, так же завершение EXEC приведет к UNWATCH).
Таким образом транзакции в Redis удовлетворяют CID(?) из ACID(?). Durability находится под вопросом, тк Redis является резидентской СУБД и возможность восстановить данные после остановки системы является опцией.
Скриптинг
Redis по определению является «предметно-ориентированным языком для абстрактных типов данных». Язык, на котором говорит Redis, состоит из его команд. Большинство команд специализируются на различных способах управления основными типами данных. Во многих случаях эти команды предоставляют все функции, необходимые разработчику для управления данными приложения в Redis.
При этом Redis поддерживает возможность выполнения произвольных сценариев(скриптов) на стороне сервера. Это позволяет обрабатывать данные там, где они хранятся.
Redis позволяет пользователям загружать и выполнять сценарии Lua на сервере. Сценарии могут использовать программные структуры управления и использовать большинство команд при выполнении для доступа к данным. Поскольку сценарии выполняются на сервере, чтение и запись данных из сценариев очень эффективны. Так же гарантируется атомарное выполнение сценария - при выполнении скрипта все действия сервера блокируются на все время его работы. Эта семантика означает, что все эффекты либо еще не произошли, либо уже завершились.
Сценарии предлагают несколько свойств, которые могут быть полезны во многих случаях. К ним относятся:
- Обеспечение локальности путем выполнения логики на сервере с данными. Локализация данных снижает общую задержку и экономит сетевые ресурсы
- Семантика блокировки, обеспечивающая атомарное выполнение скрипта
- Включение комбинаций простых возможностей, которые либо отсутствуют в Redis, либо являются слишком нишевыми, чтобы быть реализованы на уровне команд
Lua позволяет вам запускать часть логики вашего приложения внутри Redis. Такие сценарии могут, на пример, выполнять условные обновления для нескольких ключей.
Запуск скриптов происходит через передачу тела скрипта команде EVAL
> EVAL "return 'Hello'" 0
"Hello"
> EVAL "return 'Scripting!'" 0
"Scripting!"
Архитектура кластера
Redis изначально разрабатывался как максимально легковесное решение и рассчитывался на standalone режим работы, поэтому единственной топологией, доступной для всех, кто использовал Redis, была топология master/slave, в которой ведущий получает все операции записи и реплицирует изменения на ведомые устройства. Это происходит без какого-либо автоматического переключения при сбое или сегментирования данных. Данная топология применима, когда:
- У мастера достаточно памяти для хранения всех необходимых вам данных
- Можно добавить больше подчиненных устройств для лучшего масштабирования чтения или в случае, когда пропускная способность сети является проблемой (общий объем чтения превышает возможности оборудования)
- Допускается остановка приложения, когда на главной машине требуется техническое обслуживание
- Достаточно резервирования данных через ведомые устройства
В большинстве сценариев master/slave отлично работает, но перестает, когда:
- Набор данных больше, чем доступная память в главном экземпляре Redis
- Данное приложение не может быть остановлено при возникновении проблем с главным экземпляром
- Вам необходимо распределить данные между несколькими узлами. Единая точка отказа недопустима
Redis Sentinel и Redis Cluster имеют много общих характеристик, но каждый из них преследует свою цель. Цель Sentinel — обеспечить надежный автоматический переход на другой ресурс в топологии master/slave без сегментирования данных. Цель же Redis Cluster — распределить данные по разным экземплярам Redis и выполнить автоматический переход на другой ресурс, если с каким-либо master экземпляром произойдет какая-либо проблема.
Репликация
В основе репликации Redis лежит принцип master-replica. Каждая реплика является точной копией мастера, а в случаях потери связи при автоматическом возобновлении соединения пытается синхронизироваться, что бы соответствовать мастеру. В основе лежит 3 механизма:
- Когда мастер и реплики живы и не испытывают проблем с связью мастер транслирует поток входящих команд на реплики
- При любом нарушении связи между мастером и репликами после восстановления соединения реплика пытается выполнить частичную синхронизацию, получая ту часть команд, которую пропустила во время дисконнекта
- Если частичная синхронизация не выполнима - реплика запрашивает весь snapshot данных мастера, а после подключается к потоку входящих команд
По умолчанию используется асинхронная репликация - то есть мастер не ожидает подтверждения каждой отправленной команды, при этом сами реплики так же в асинхронном режиме сообщают мастеру о исполненных командах. Асинхронная репликация имеет меньшую задержку, за счет чего считается более производительной.
Синхронная репликация определенных данных может быть запрошена клиентами с помощью команды WAIT. Однако WAIT может только гарантировать наличие указанного количества подтвержденных копий в других экземплярах Redis, но не превращает набор экземпляров Redis в систему CP с строгой согласованностью: подтвержденные записи все равно могут быть потеряны во время аварийного переключения.
Реплики могут принимать соединения от других реплик. Помимо подключения нескольких реплик к одному мастеру, реплики также могут быть подключены к другим репликам в каскадной структуре. Начиная с Redis 4.0, все суб-реплики будут получать один и тот же поток репликации от мастера. Так же реплики могут быть использованы для уменьшения нагрузки мастера. При необходимости периодического сохранения или AOF мастер работает исключительно с оперативной памятью, а записью на диск занимается его реплика. Но надо быть осторожным с подобной настройкой - если мастер совершит вынужденный перезапуск - реплики попытаются синхронизоваться с мастером и сольют с него пустой snapshot.
Партицирование
Партицирование - возможность распределять данные по кластеру. Это полезно, когда данных для одного экземпляра становится слишком много и начинает страдать производительность. В Redis имеется два принципа распределения данных:
- Разделение диапазонами (Range partitioning)
- Разделение хэшами (Hash partitioning)
Range partitioning
Разделение диапазонами - возможность распределить данные путем выделения диапазонов ключей. Например, предположив, что данными являются пользователи, тогда паттерн ключа может быть user:N, где N - идентификатор пользователя (user:1, user:2, ..., user:100500). Выбрав диапазоны можно распределить пользователей по диапазонам 1..1000, 1001..2000 и т.д.. Или распределение по первому символу ключа. Каждый выбранный диапазон будет храниться на своем хосте. В минусы данного подхода можно отнести трудности при изменении списка хостов кластера - поскольку если количество экземпляров Redis изменится, распределение диапазонов должно измениться соответствующим образом. Так же к минусам разделения промежутками относится возможная неравномерность распределения данных, тк один диапазон может преобладать над остальными.
Hash partitioning
Разделение хэшами является чуть более сложным, нежели разделение диапазонами, но лишено проблемы с неравномерным распределением данных. Метод заключается в получении хэша ключа с последующим определением экземпляра (прим. распределение пар ключ-значение по корзинам хэш-таблицы).
Партицирование реализуется на различных уровнях системы: клиенте, маршрутизаторе запросов или прокси.
- Клиентский уровень - это уровень приложения, распределение происходит на этапе формирования команд.
- Уровень маршрутизатора запросов - распределение происходит за счет внутренних средств кластера и не нуждается в отдельном программном модуле. Получая запрос любой экземпляр Redis перенаправит команду в соответствующий экземпляр в своем кластере.
- Прокси уровень - отдельный уровень, который проксирует все запросы к Redis и выполняет распределение данных.
Twemproxy
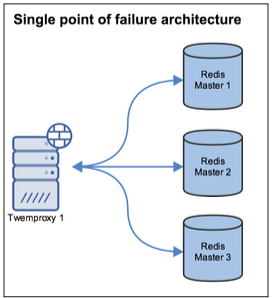
Примером прокси является программа twemproxy, при использовании которой клиентское приложение ничего не знает про распределение.
Но в случае отказа twemproxy вы не сможете читать или писать ни в один из экземпляров Redis, даже если они фукнцианируют нормально:
Чтобы решить эту проблему, мы могли бы использовать другую архитектуру, в которой имеется балансировщик нагрузки перед кластером twemproxy, и каждый экземпляр twemproxy подключен ко всем серверам Redis следующим образом:
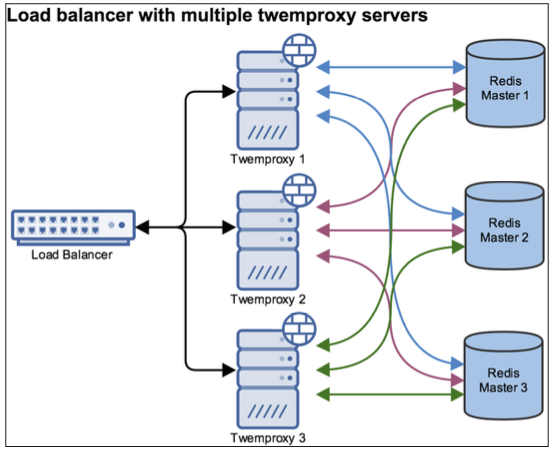
В другой возможной архитектуре twemproxy работает на том же сервере, что и клиент-приложение Redis, поскольку он не требует большого количества ресурсов.
Тегирование
Тегирование - это метод обеспечения хранения ключей на одном сервере. В сообществе Redis принято добавлять тег к имени ключа, помещая имя тега в фигурные скобки (то есть key_name:{tag}).
Persistence
Persistence в Redis - возможность записи данных на диск и имеет следующие опции:
- RDB (Redis Database) - раз в некоторое время делается snapshot данных и сохраняется на диск
- AOF (Append Only File) - Все операции записи добавляются в лог операций, что впоследствии может быть повторно последовательно исполнено, для достижения актуального состояния экземпляра
- Nope - экземпляр хранит данные только в памяти
- RDB+AOF - комбинация лога операций и периодических snapshot данных
RDB - является компактным представлением, позволяющее экземпляру быстрее восстанавливаться в сравнении с AOF, но из-за больших объемов разовой записи и периодичности является менее надежным способом из-за риска пропустить входящие команды записи. AOF, в свою очередь является более надежным, т.к. каждая команда является атомарной операцией записи (даже если экземпляр умрет посередине записи команды - остальная часть лога останется не тронутой), но объем лога операций больше, чем RDB, а восстановление требует повторения всех залогированных команд записи.
Redis Sentinel
Когда на master узле возникают проблемы, один из его подчиненных узлов необходимо повысить до уровня master, а все остальные подчиненные узлы необходимо перенастроить, чтобы они смотрели на новый master узел. До Redis Sentinel этот процесс переключения выполнялся вручную, что было не очень надежно.
Redis Sentinel — это распределенная система, предназначенная для автоматического повышения статуса подчиненного устройства Redis до главного в случае сбоя существующего главного устройства. Sentinel не распределяет данные между узлами, поскольку у главного узла есть все данные, а у подчиненных есть копии данных, соответственно, Sentinel не является распределенным хранилищем данных.
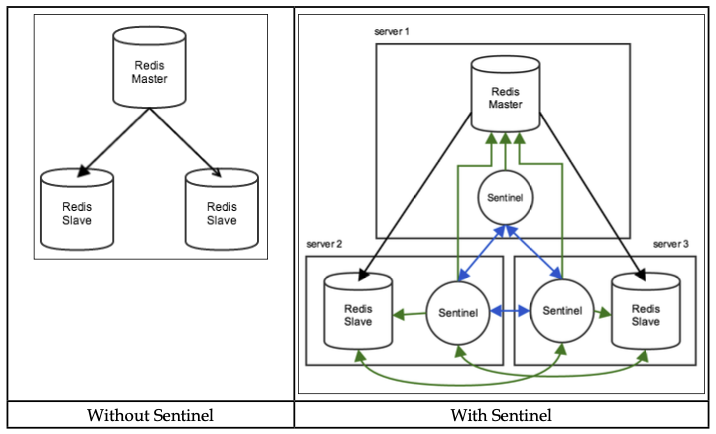
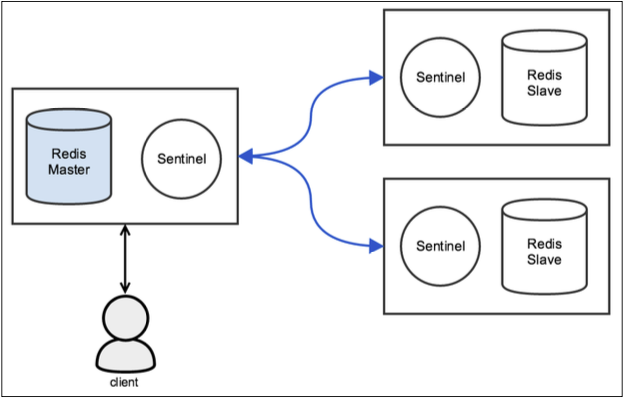
Наиболее распространенная архитектура предполагает установку одного Sentinel для каждого сервера Redis. Sentinel — это отдельный от сервера Redis процесс, который прослушивает собственный порт.
На примере кластера из одного master и 2х slave с применением Redis Sentinel архитектура может выглядеть следующим образом:
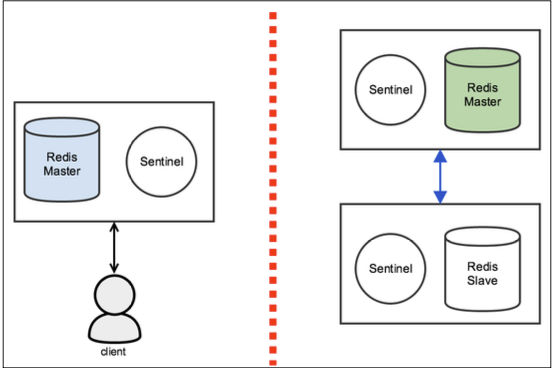
Redis Sentinel не является строго согласованным в сценарии сетевых проблем. Данные могут быть потеряны при возникновении split-brain.
Явление split-brain может быть продемонстрировано следующим образом:
Кластер до сбоя
После сбоя каждая изолированная часть выбирает своего мастера
Redis Sentinel решает проблему автоматического переключения при отказе доступности, но не решает проблему распределения данных между несколькими экземплярами Redis. Redis Cluster решает обе эти проблемы с помощью другого подхода.
Redis cluster
Redis Cluster был разработан для автоматического распределения данных между различными экземплярами Redis, обеспечивая некоторую степень доступности во время сетевых сбоев. В отличие от Sentinel, Redis Cluster требует для запуска только один процесс.
Чтобы кластер Redis считался работоспособным, требуется как минимум три мастера. Все данные распределяются между master экземплярами и реплицируются на slave устройства:
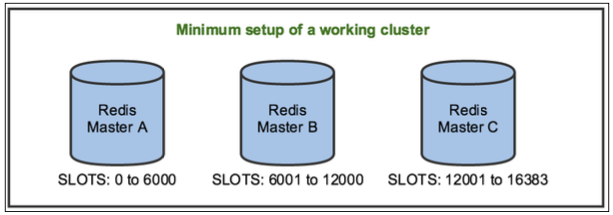
Рекомендуется иметь хотя бы одну реплику для каждого мастера. В противном случае, если какой-либо master-узел, не имеющая хотя бы одной реплики, выйдет из строя, данные будут потеряны:
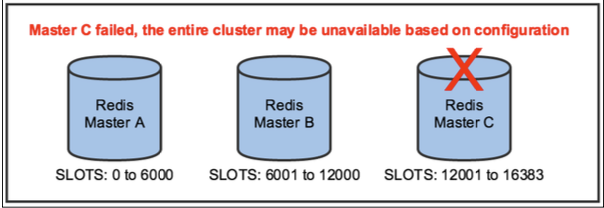
В отличие от Redis Sentinel, при отказе в кластере Redis недоступны только ключи в слотах, назначенных вышедшему из строя мастеру, пока реплика не будет переключена поскольку master не назначается мгновенно.
Когда Redis находится в режиме кластера, его интерфейс меняется, что требует отличного от standalone инсталяции клиента.
Характеристики
| Характеристика | Значение | Комментарий |
|---|---|---|
| Семейства баз данных | Multi-model database
| |
| Транзакционная модель | CID(?) | Durability находится под вопросом, тк Redis является резидентской СУБД и возможность восстановить данные после остановки системы является опцией |
| Многоузловые транзакции | нет | |
| Структуры данных | ассоциативный массив | |
| Масштабирование | Горизонтальное партицирование | |
| Репликация | с одним ведущим узлом | |
| Модели согласованности | строгая | |
| CAP | Настраиваемый
| |
| PACELC |
| |
| Fault Tolerance | автоматически | при использовании Redis Sentinel |
| Primary Key | есть | |
| Partition Key | есть | |
| Foreigen Key | нет | |
| Локальный вторичный индекс | есть | |
| Глобальный вторичный индекс | нету | |
| Ограничение уникальности | нет | установка значения ключа происходит перезаписью |
| JOINs | нету | |
| Аггрегации | нету | |
| Схема данных | нету | |
| Организация данных | денормализованная |
Ссылки
Документация redis (readthedocs.io)