Neo4j
Вопросы:
- Кластерный режим и master-master
- Где-таки лежат индексы на связи и ребра
- OLTP/OLAP
- Как запрос внутри работает с данными и индексом
Модель данных
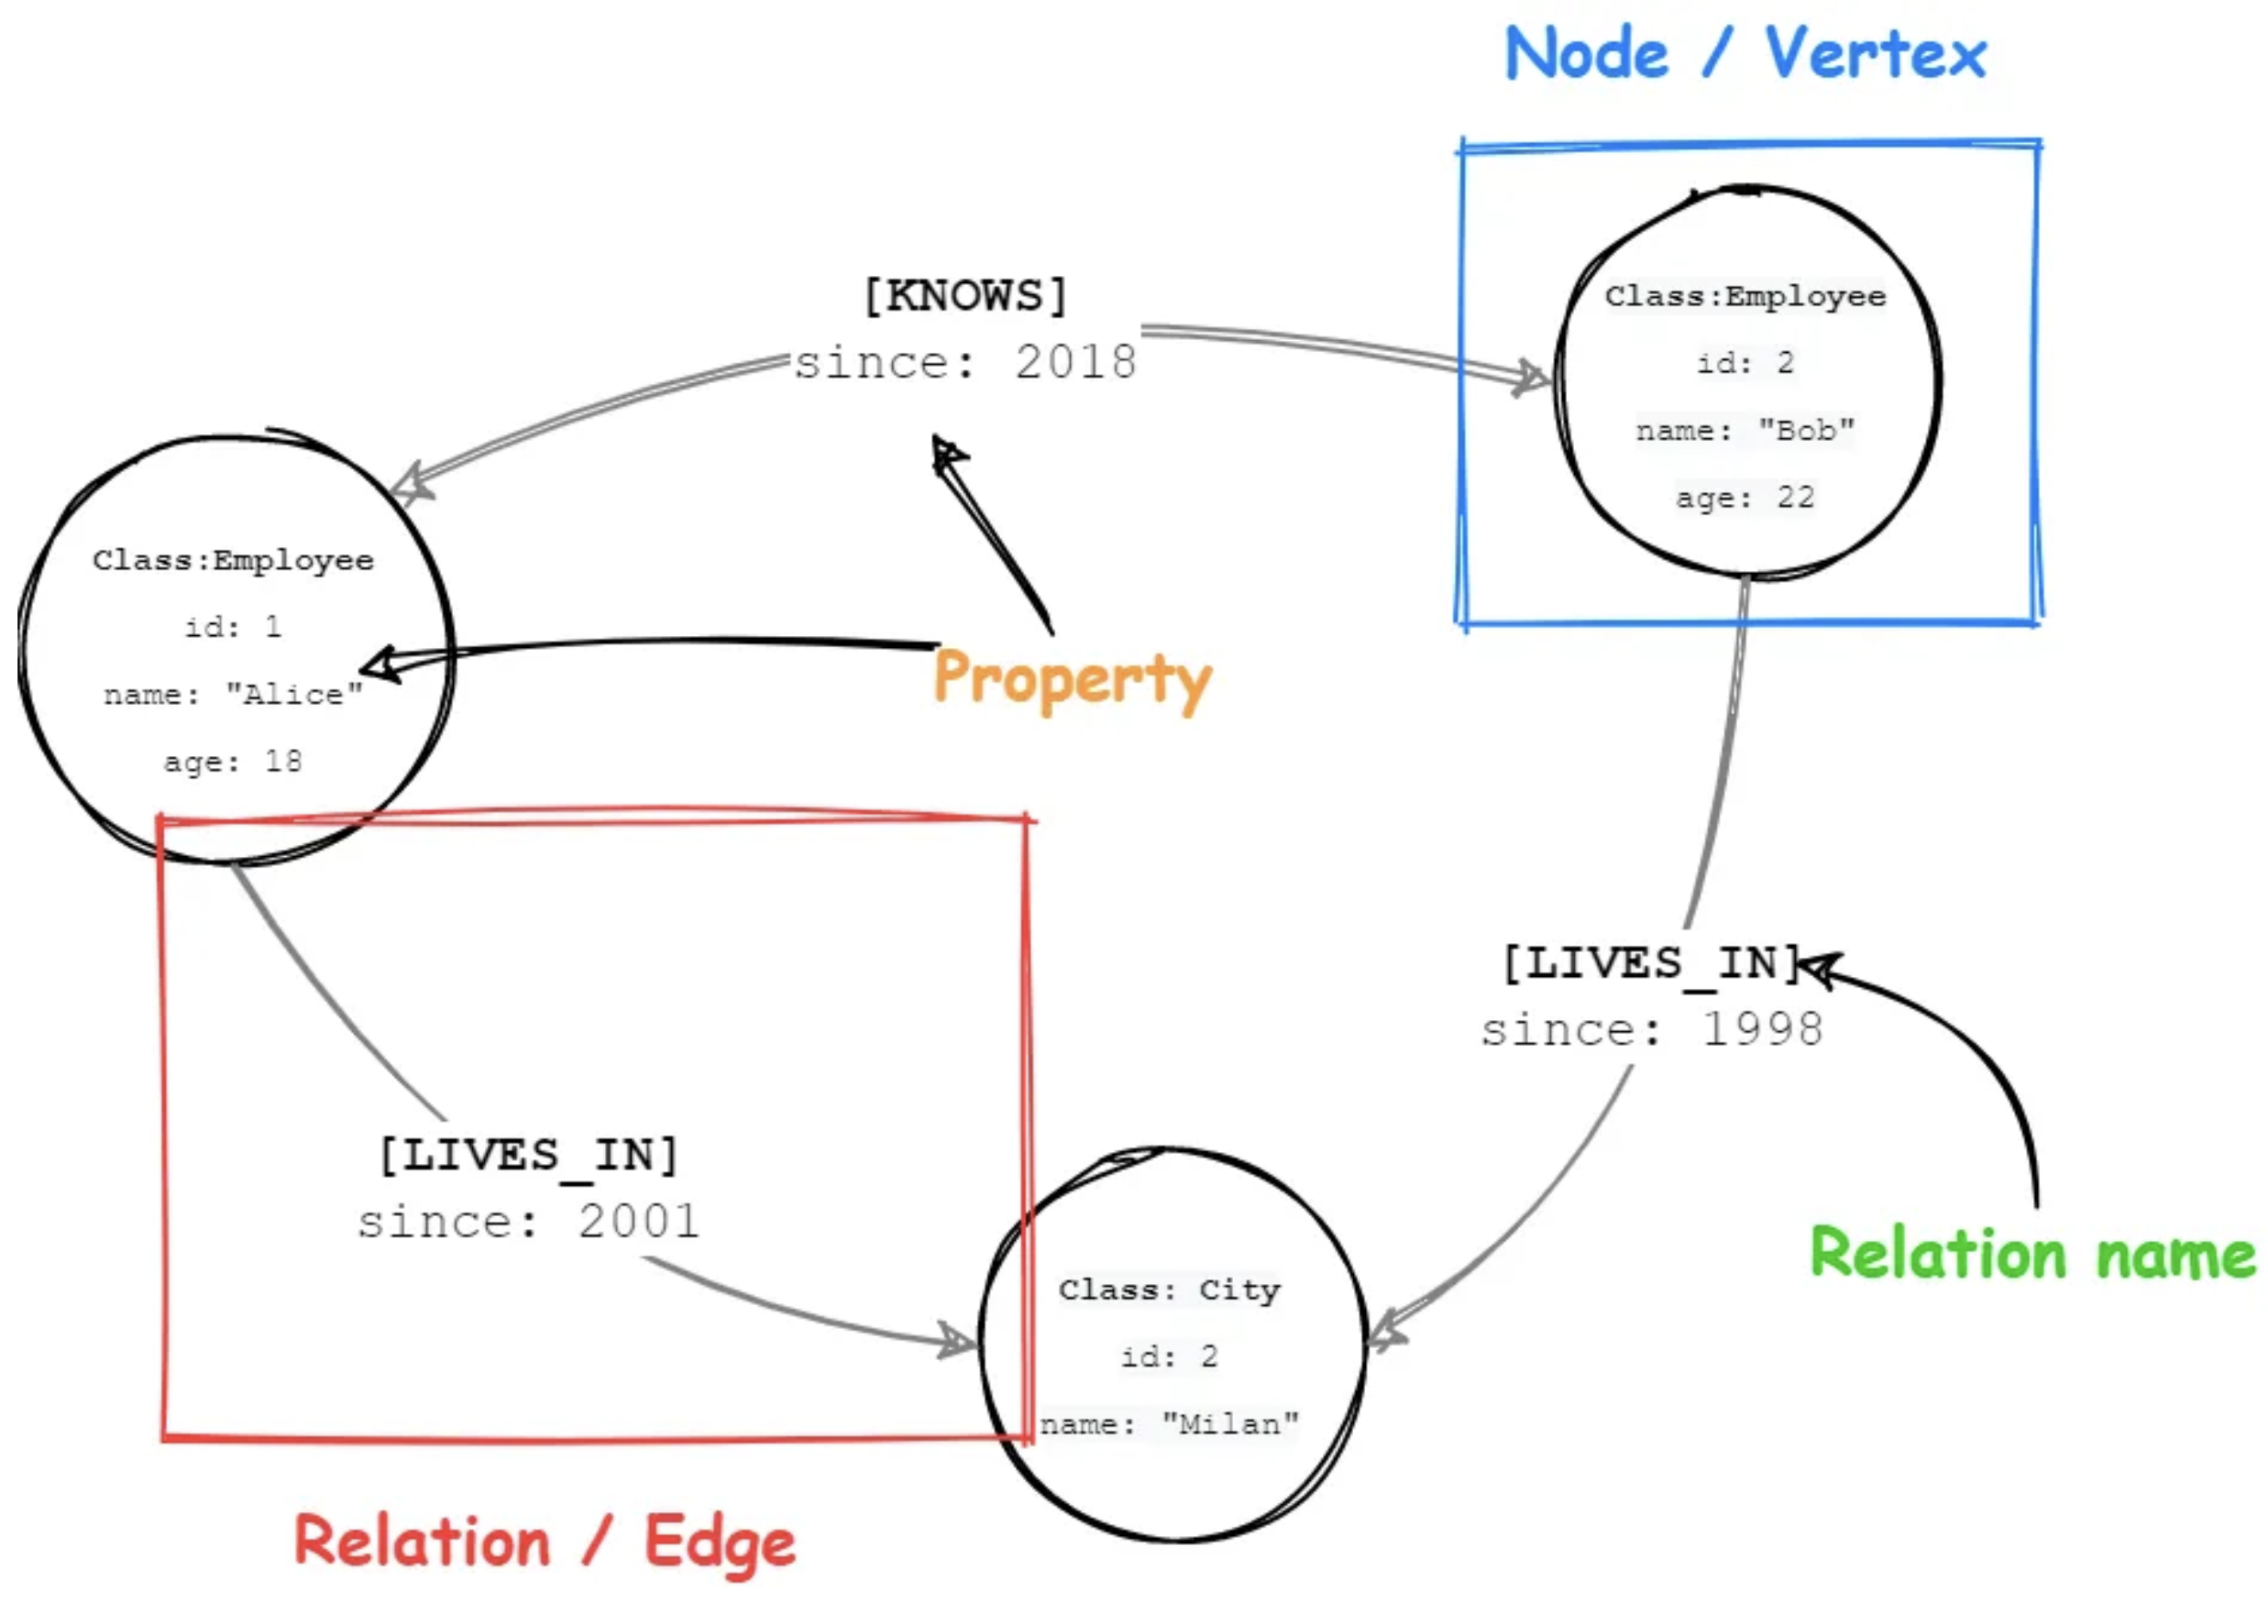
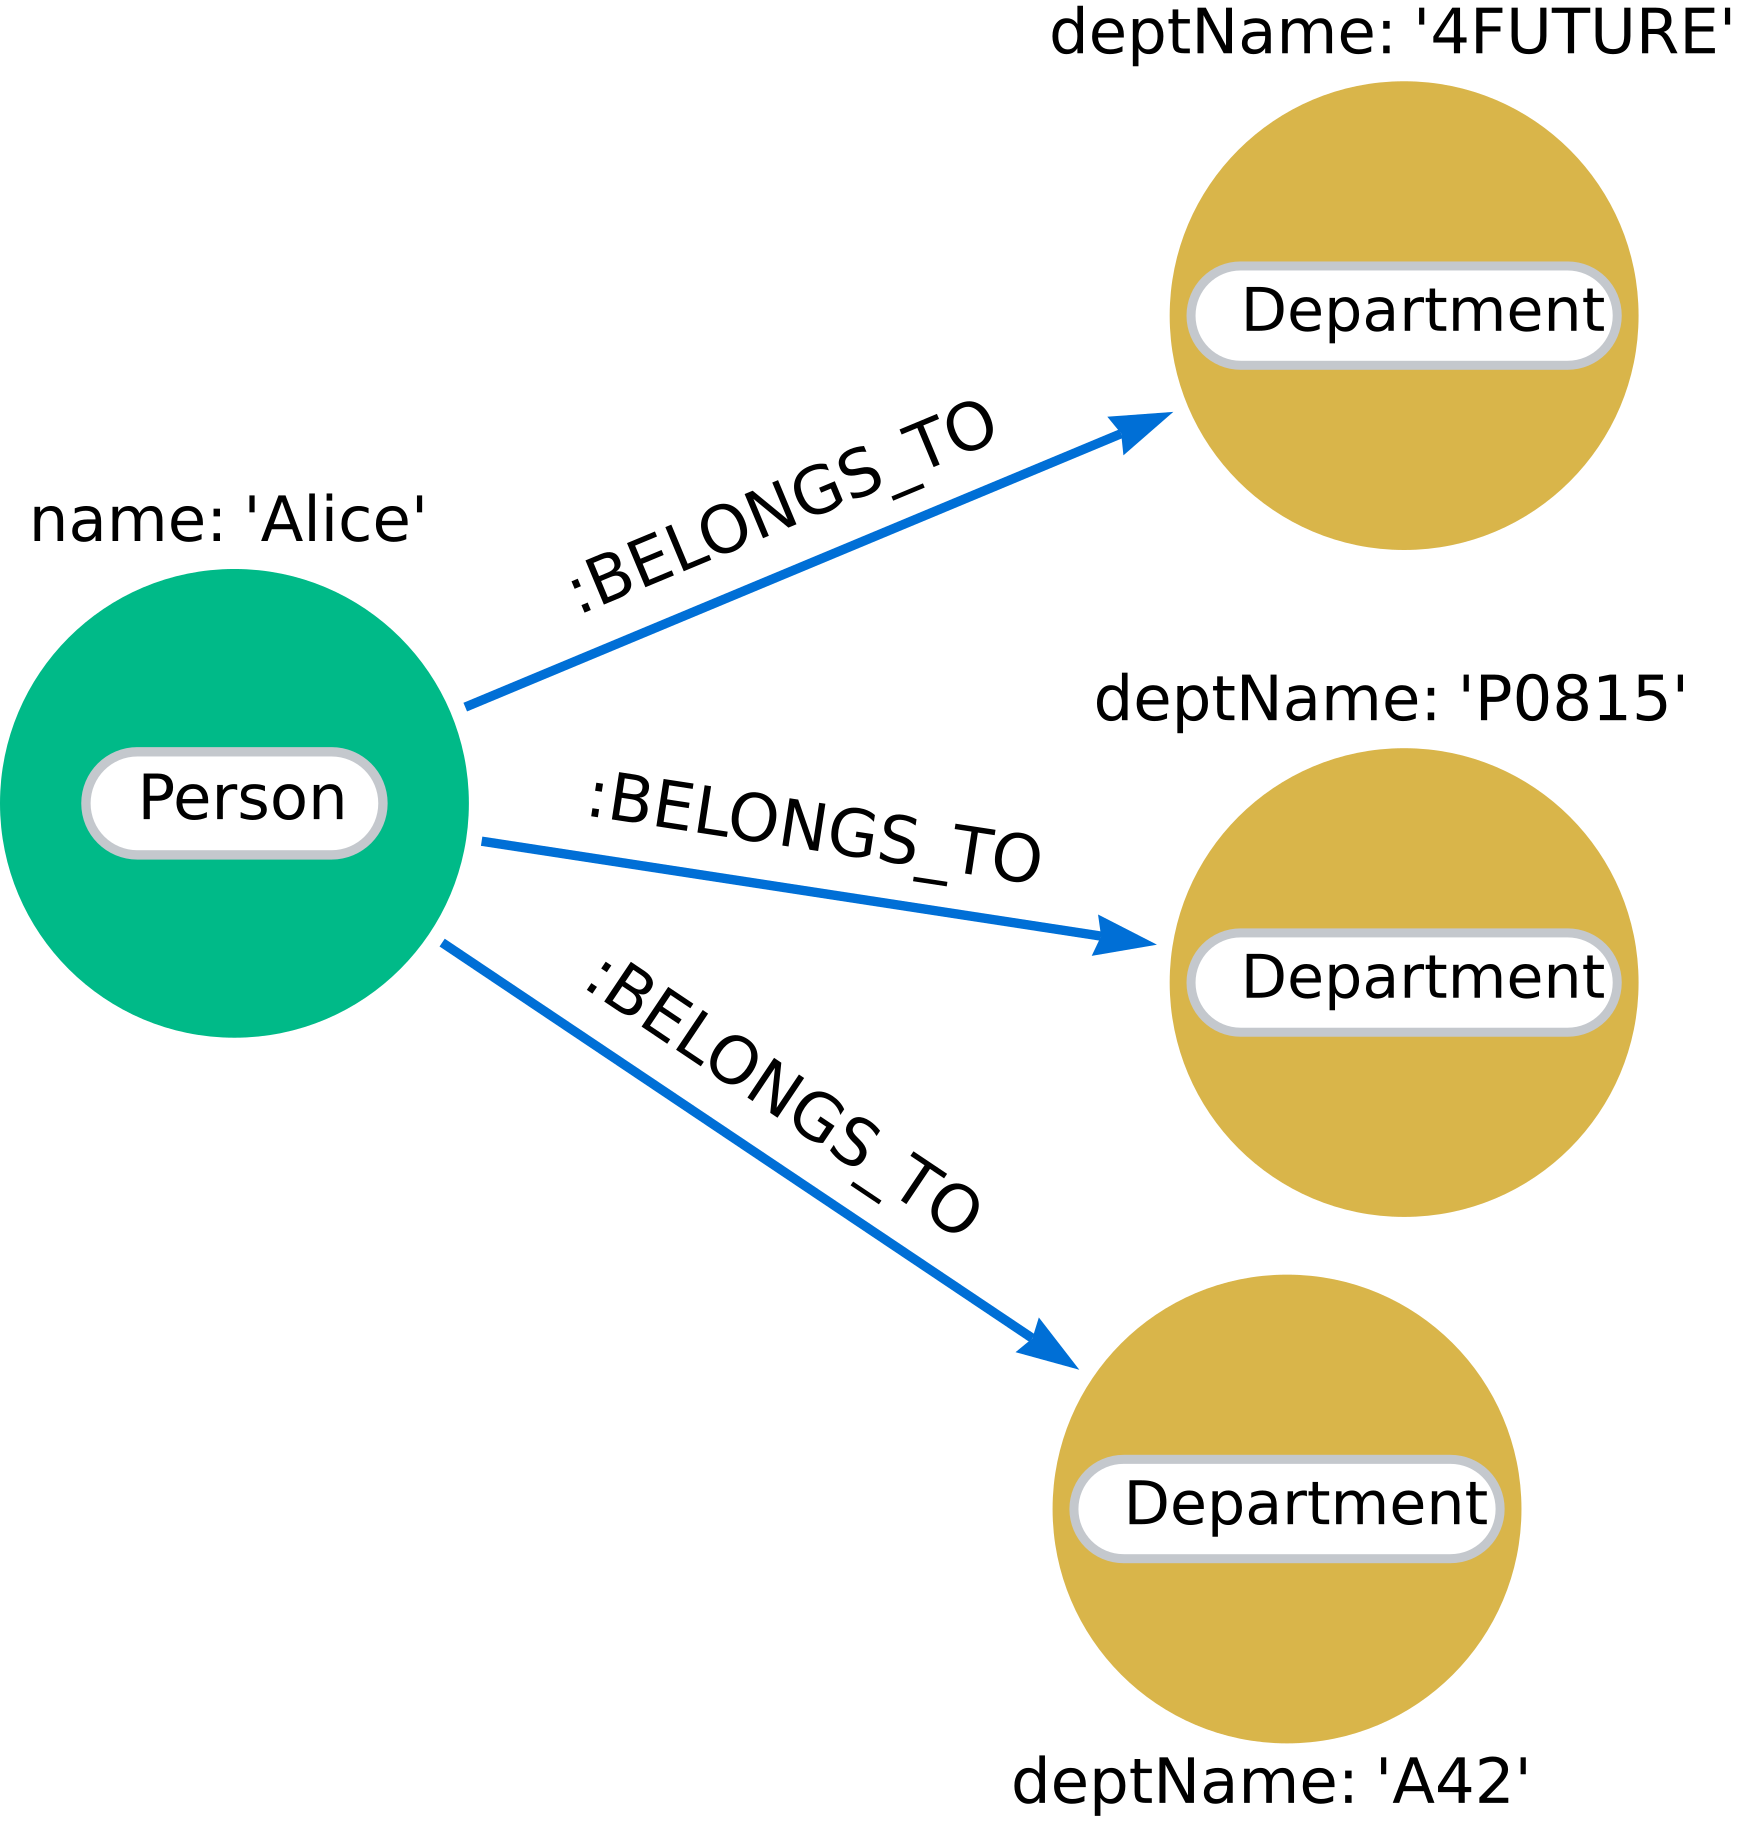
Формально граф – это система объектов произвольной природы (вершин) и связок (ребер), соединяющих некоторые пары этих объектов.
набор вершин (узлов) и ребер;
каждая вершина имеет
идентификатор
{1,4} лейбла, указывающие на тип вершины
список ребер
ассоциативный список свойств;
каждое ребро имеет
идентификатор
ссылку на начальную и конечную вершину (стрелки из ниоткуда или вникуда быть не может)
- лейбл, указывающий на тип связи
и ассоциативный список свойств;
вершины и ребра в графовой модели данных необязательно должны быть одного типа - они могут представлять различные объекты;
- ребра строго однонаправленные, соответственно, выбирая название для связи, необходимо выбрать правильный глагол, который бы отображал как левая часть связи (активная нода) воздействует (глагол) на правую часть (пассивная нода).
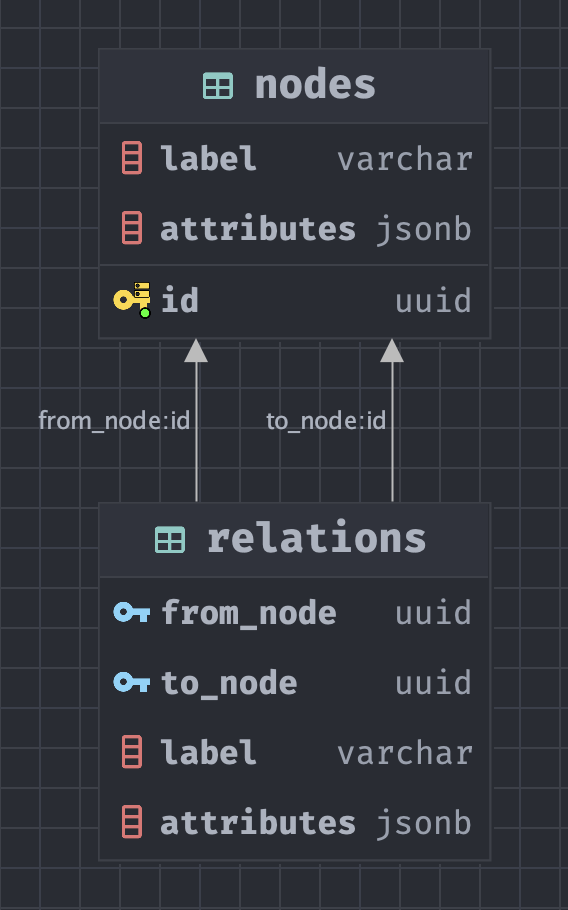
В некотором смысле графовую модель можно представить, как дополнение реляционной модели, где упор больше сделан не на атрибутах сущности, а на его связях. Если представлять граф в реляционной модели, то это будет по сути 2 таблицы с следующей схемой
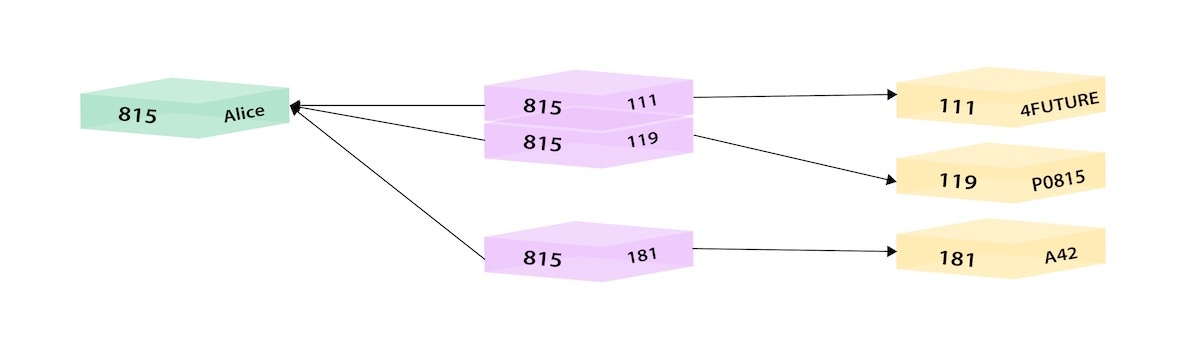
То есть отдельно вершины, отдельно ребра представляют из себя плоские списки, где каждая вершина внутри себя хранит список всех исходящих и входящих ребер.
Различия между реляционной и графовой моделями
Реляционная |
|
|---|---|
Графовая |
|
Возможности
Для Neo4j был разработан специальный язык запросов Cypher, который учитывает специфику работы с графами.
В отличии от реляционной модели, графовая модель избавляет от join'ов и сильно ускоряет запросы с высокой степенью вложенности. Особенно сильно упрощаются в обработке и написании запросов рекурсивные запросы вида
| SQL | Cypher |
|---|---|
| |
Графовая модель дает большой прирост в скорости обработки и именно на запросах большой вложенности, потому что для вычислений не нужно обращаться за индексами вторичного ключа в отдельное место на диске, а только взять указатель, который находится прям близко к хранению самой вершины. Также можно получить значительную экономию в дисковом пространстве относительно реляционных БД, когда количество ребер между вершинами становится больше количества самих вершин.
Фильтрация
В первую очередь Neo4j с язык запросов Cypher хороши в запросах фильтрации. В терминах Neo4j это называется сопоставление паттерна.
| SQL | Cypher |
|---|---|
| Запрос, который получает все фильмы-комедии, которые смотрели друзья друзей пользователя, но которые он не смотрел сам. | |
| |
Запись данных
Важно понимать большое отличие между MERGE и CREATE в языке Cypher
- CREATE – не будет проверять по первичному ключу существует ли уже такая нода в БД — это дает ему огромное преимущество в скорости.
CREATEчаще всего используют для дампов, чтобы быстро можно было их развернуть на чистой базе. - MERGE – создает паттерн в базе данных, он занимается вставкой данных более аккуратно — с проверкой всех условий, но и более медленно.
Найти вершины Person и Movie с данными именами и связать их отношением ACTED_IN. Если не будет таковых вершин, то связь не будет создана.
MATCH (p:Person {name: 'Michael Cain'})

MATCH (m:Movie {title: 'The Dark Knight'})

MERGE (p)-[:ACTED_IN]->(m).
Создать вершины Person и Movie с данными именами и связать их отношением ACTED_IN.
MERGE (p:Person {name: 'Michael Cain'})
MERGE (m:Movie {title: 'The Dark Knight'})
MERGE (p)-[:ACTED_IN]->(m)
Создать вершины Person и Movie с данными именами и связать их отношением ACTED_IN, запрос в одну строку.
MERGE (p:Person {name: 'Michael Cain'})-[:ACTED_IN]->(m:Movie {title: 'The Dark Knight'})
RETURN p, m
Важно, что 1 оператор MERGE создает 1 паттерн целиком. То есть, в предыдущем запросе, даже если уже был фильм "The Dark Knight", то будет создана новая вершина с таким же названием. Поэтому лучше создавать вершины отдельным запросом, потом связывать их ребрами через запрос с MATCH.
Обновление атрибутов
Обновление выполняется через оператор SET
MATCH (p:Person)-[r:ACTED_IN]->(m:Movie)

WHERE p.name = 'Michael Cain' AND m.title = 'The Dark Knight'

SET r.roles = ['Alfred Penny'], r.year = 2008

RETURN p, r, m
Удаление данных
Важно знать, что нельзя удалить вершину хотя бы с одним входящим или исходящим ребром.
MATCH (p:Person)
WHERE p.name = 'Jane Doe'
DELETE p
Индексы
Neo4j поддерживает различные индексы для ускорения поиска данных. Подробнее об индексах можно прочитать в документации.
Транзакции
Neo4j поддерживает ACID транзакции. Подробнее можно прочитать в документации.
Neo4j поддерживает все уровни изоляции из ACID. По-умолчанию используется READ COMMITED.
Сама БД не поддерживает многообъектные транзакции по-умолчанию, потому что все изменения поддерживаются только на уровне одного узла. Но БД поддерживает группировку различных изменений в рамках одной транзакции. Поэтому можно эмулировать поддержку многообъектных транзакций на уровне клиента БД через Neo4j SDK.
Физическая структура данных
Коротко можно изобразить схему хранения данных на диске следующим образом:
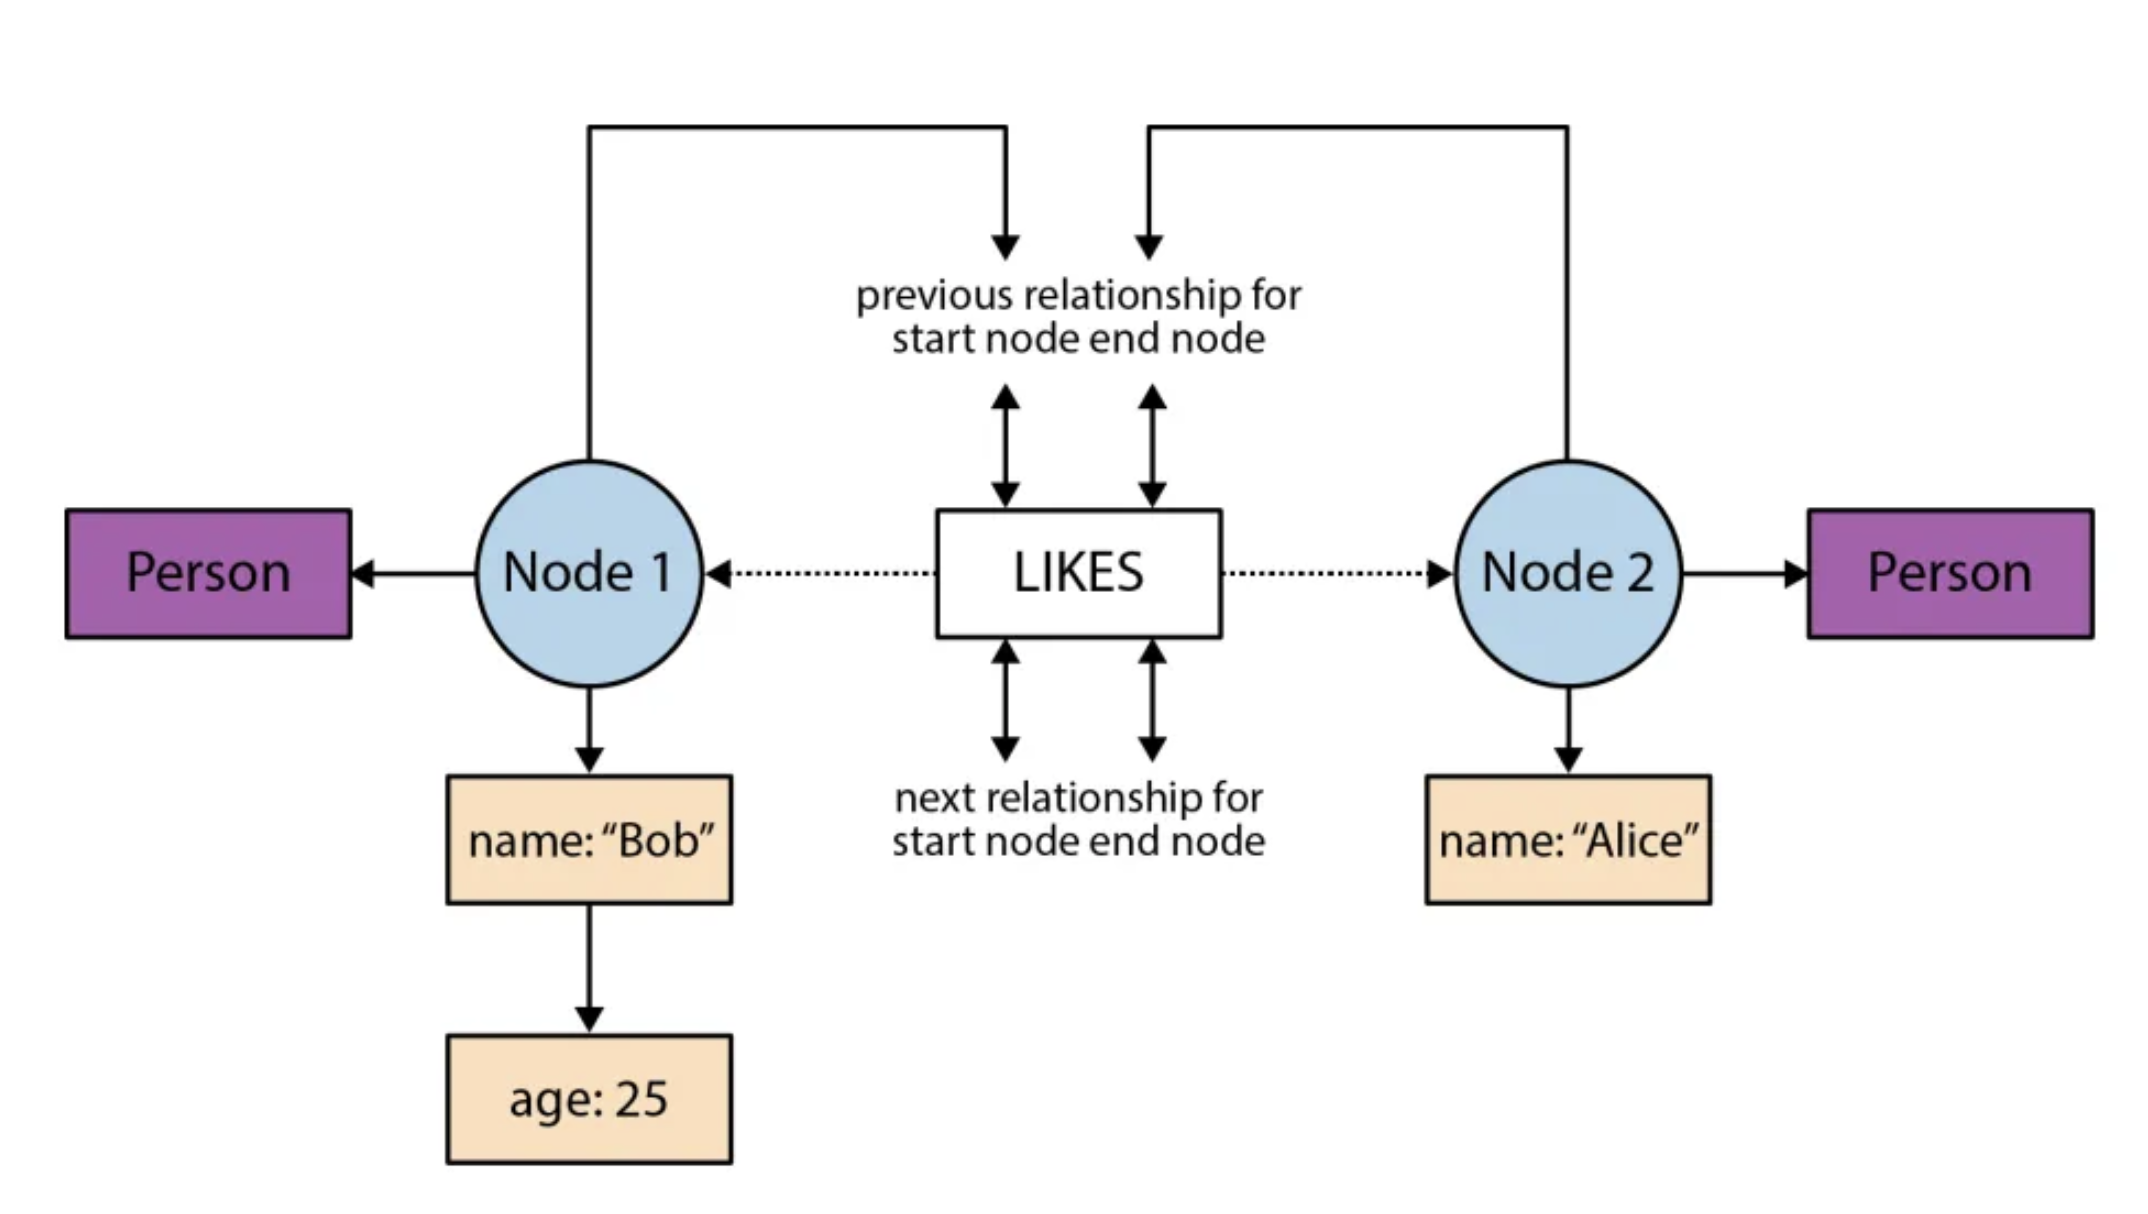
Физически данные в Neo4j хранятся в 4х хранилищах:
- хранилище вершин – вершины помечены синим цветом
- хранилище ребер – помечены белым цветом
- хранилище свойств (ассоциативных список для Каждой вершины/ребра) – помечены бежевым цветом
- хранилище лейблов – помечены фиолетовым цветом
Ранее я уже говорил, что указатели на связанные вершины лежат близко с исходной вершиной. На самом деле тут допущена небольшая неточность, которая незначительна в том контексте. Сейчас раскроем схему хранения данных в Neo4J более подробно.
Данные о вершине всегда занимают строго 15 байт
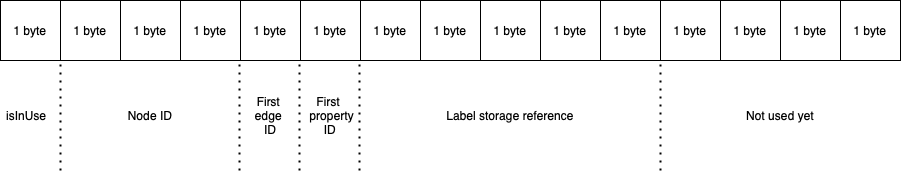
Данные о ребре всегда занимают строго 34 байта, которые состоят из:
- ID стартовой вершина;
- ID конечной вершины;
- Указатель на лейбл ребра;
- Указатель на предыдущее ребро стартовой вершины
- Указатель на следующее ребро стартовой вершины
- Указатель на предыдущее ребро конечной вершины
- Указатель на следующее ребро конечной вершины
То есть 4мя последними указателями вершины образуют двусвязные списки из всех ребер, которые исходят из одной вершины.
Теперь, чтобы сделать обход по графу, заданный запросом Cypher, нужно
- Получить стартовую вершину. Для ускорения этого действия Neo4J использует индекс
- Получив стартовую вершину, остается сделать обход графа по ссылкам, которые находятся рядом с данными, но в разных хранилищах. Значительное ускорение получается за счет постоянного размера каждой вершины и ребра на диске, потому что в итоге это приводит к операции поиска по индексу в хранилищах.
Почему Neo4j быстрая
Neo4j держит в off heap page cache, где кэширует все данные, к которым обращаются клиенты. Обработчик запросов не взаимодействует напрямую с данными на диске, а только через кэш. Если данных в кэше нет, то уже идут более дорогостоящие операции чтения с диска. Поэтому разработчики БД в документации рекомендуют выделять для БД столько оперативной памяти, сколько возможно. Лучшим решением будет хранить все данные в оперативной памяти, хоть это и не необходимое требование для работоспособности БД.
Кластер
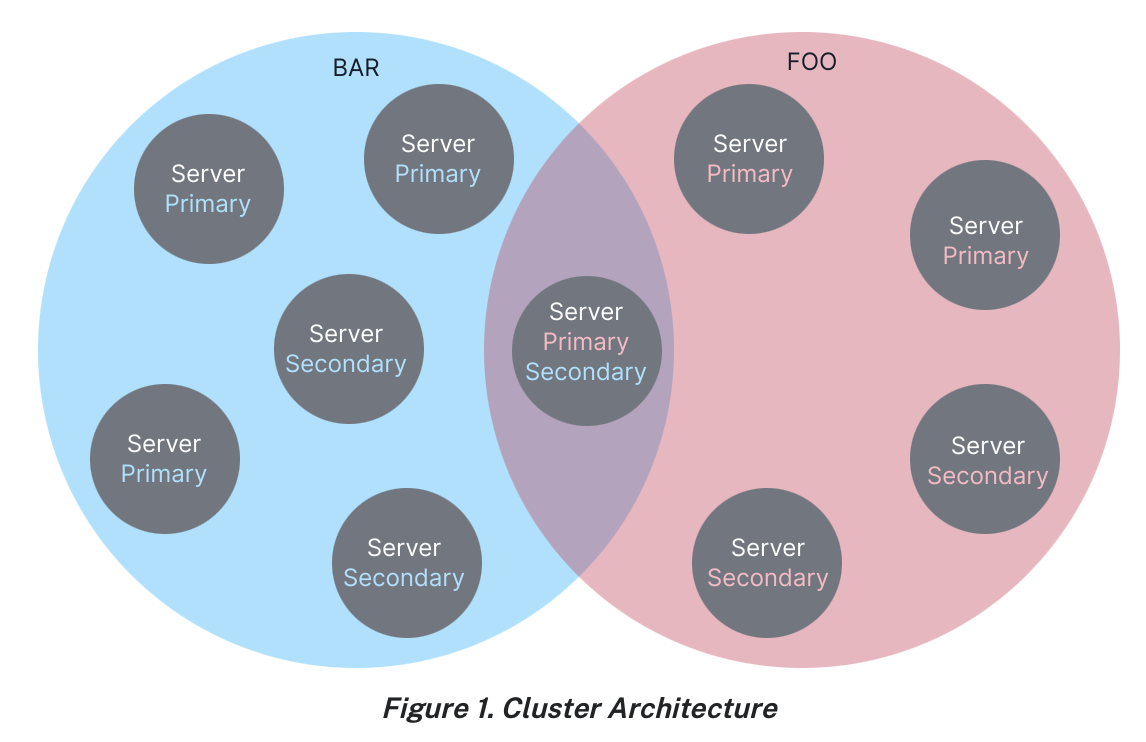
БД Neo4j может работать в кластере. Neo4j рассматривает кластер, как гомогенную структуру хостов, каждый из которых может выполнять роль мастера или реплики для {1..n} БД, размещенных в кластере. Роли узлов в кластере могут меняться со временем автоматически по необходимости.
При создании БД в кластере может быть указана топология, либо же берутся дефолтные настройки кластера.
CREATE DATABASE foo TOPOLOGY 3 PRIMARIES 2 SECONDARIES
Мастер узлы
Для повышения доступности БД на запись БД Neo4J может быть создана с несколькими мастер узлами в режиме HA (high availability). Тогда при выполнении запроса на запись узел, который выполняет запрос, синхронно реплицирует журнал с изменениями по протоколу Raft на другие мастер узлы и дождется N/2+1 подтверждений от них о записи, где N – кол-во мастер узлов. Таким образом устойчивость БД к утрате узлов в кластере рассчитывается по формуле N = 2F + 1, где N – требуемое кол-во мастер узлов, а F – кол-во потерянных узлов, которые требуется пережить.
БОльшее число узлов с синхронной репликацией изменений повышают устойчивость БД к потере данных, но значительно замедляют операции записи. Нужно ответственно относиться к выбору этого параметра при создании БД. Хотя этот параметр можно поменять и после создания БД.
Важно понимать, что HA режиме на некоторое время операции записи обрабатывает только 1 мастер узел, при этом синхронно реплицируя журнал изменения данных другим primary узлам. Neo4j не поддерживает работу в multi master режиме, а только автоматически умеет переключать мастеры при недоступности текущего.
HA режим доступне только в Enterprise версии начиная с Neo4j 3.2.
Реплика узлы
Реплика узлы получают обновления об изменениях от мастер узлов асинхронно и требуются только для увеличения пропускной способности БД на чтение.
Read after write
Для решения проблемы read-after-write за клиента, в БД Neo4J введены заметки (bookmarks). При записи данных на мастер узел запрашивает заметку и при последующем обращении к кластеру может запросить данные только с тех узлов, которые уже успели обработать данную метку.
Сценарии использования
Когда не стоит использовать
- Объем данных превышает возможности одного узла или стоимость такого узла слишком велика
- Необходим высокий throughput на запись
Когда стоит использовать
- Если в вашем приложении центральную роль играют связи и отношения между данными
- Если вам нужна гибкость в изменении и расширении структуры данных, Neo4j позволяет легко добавлять новые сущности, узлы и связи, не требуя сложных миграций схемы данных.
- Когда требуется полноценный ACID
Некоторые примеры
- граф связей между пользователями
- рекомендательные системы, где нужно предлагать похожий контент пользователям с похожими интересами
Характеристики
Характеристики | Значение | Комментарий |
|---|---|---|
| Семейства баз данных | Grath | |
| Транзакционная модель | ACID | |
| Структуры данных | Граф | |
| Масштабирование | горизонтальное на чтение вертикальное на запись | |
| Репликация | синхронная между мастер узлами и асинхронная между мастер-реплика | |
| Модели согласованности | линеаризуемая | |
| CAP | CP | |
| PACELC | PC/EC | |
| Fault Tolerance | автоматически (при HA режиме) | |
| Primary Key | нет | Но можно сделать вторичный индекс + constraint на уникальность значения атрибута |
| Partition Key | нет | |
| Foreigen Key | нет | |
| Локальный вторичный индекс | есть | |
| Глобальный вторичный индекс | - | |
| Ограничение уникальности | есть | |
| JOINs | нет | |
| Агрегации | есть | |
| Схема данных | нет | Есть только ноды и связи, внутри атрибуты без схемы. Но можно добавить constraint |
| Организация данных | нормализованная |
Ссылки
- https://gauravsarma1992.medium.com/neo4j-storage-internals-be8d150028db
- https://neo4j.com/developer/kb/understanding-data-on-disk/
- https://neo4j.com/docs/cypher-manual/current/indexes-for-search-performance/
- https://neo4j.com/docs/getting-started/appendix/graphdb-concepts/graphdb-vs-rdbms/
- https://neo4j.com/docs/operations-manual/current/clustering/introduction/
- https://raft.github.io/
- https://neo4j.com/docs/operations-manual/current/performance/disks-ram-and-other-tips/
- https://neo4j.com/docs/operations-manual/current/database-internals/
- https://neo4j.com/docs/operations-manual/current/performance/disks-ram-and-other-tips/